LM Warden

Tus propias GPU, tan fáciles de usar como una API en la nube.

LM Warden ejecuta vLLM, llama.cpp o MLX en tu propio hardware y pone delante un único puerto compatible con OpenAI: una clave por app, el uso de cada clave y un panel en directo para cada GPU. En una máquina Linux con tarjetas NVIDIA o en un Mac con chip de Apple.

Código abierto, Apache-2.0Sin cuenta ni telemetríaLinux + NVIDIA · macOS (beta) · Windows en camino

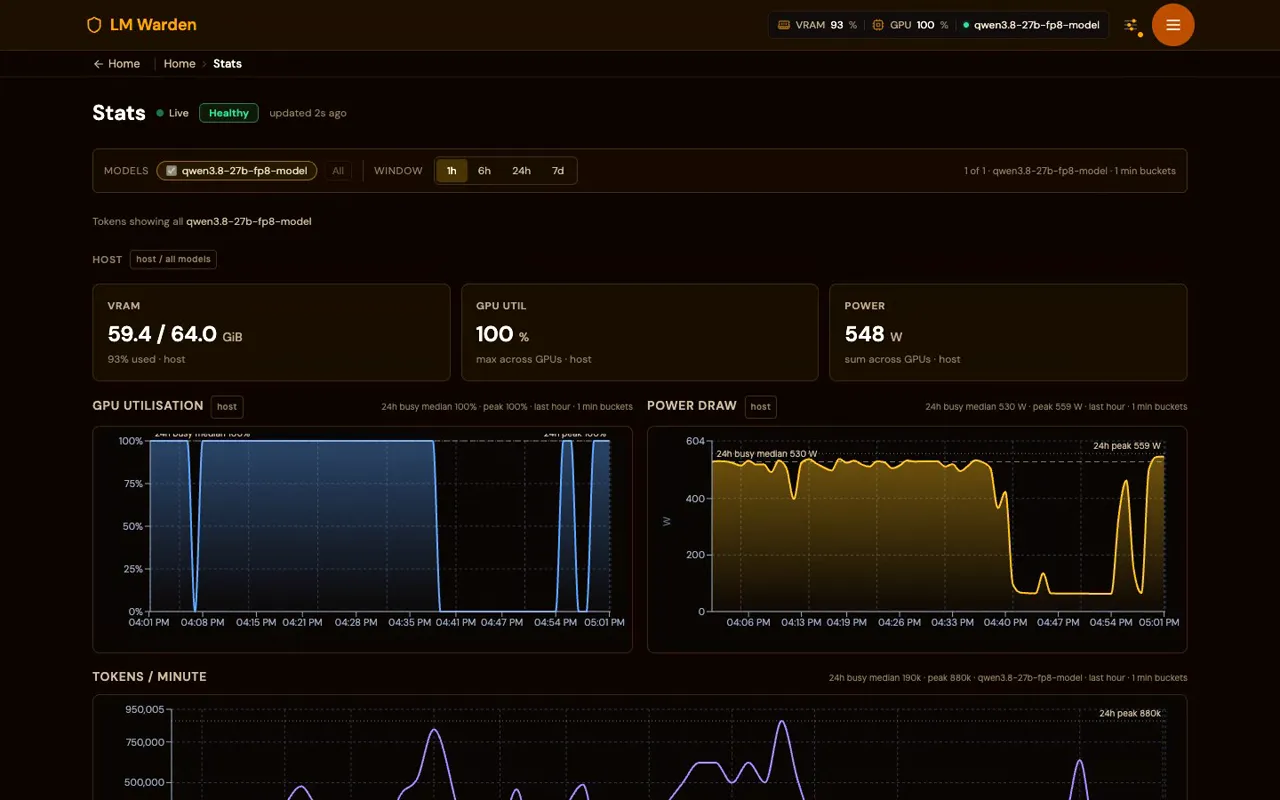
La página Stats de una instancia de LM Warden con mucha carga: VRAM 59,4 de 64 GiB, uso de GPU 100 %, potencia 548 W y gráficos del uso de GPU, el consumo eléctrico y los tokens por minuto de la última hora
  • Linux · NVIDIA vLLM v0.32.0 y llama.cpp b11719 sobre CUDA
  • macOS · chip de Apple MLX y llama.cpp sobre Metal
  • API OpenAI, Anthropic Messages y Responses en un puerto
  • Agentes de programación Claude Code, Codex CLI, OpenCode y 7 más ya configurados

Para qué se usa

¿Dónde lo vas a ejecutar?

Elige una plataforma arriba para ver sus pasos, o muestra las cuatro.

Un solo comando en el host con GPU.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • Host x86_64, Docker Compose v2.24+, el NVIDIA Container Toolkit y una tarjeta Turing o más reciente.
  • Después abre http://HOST:8080/ui/, completa el asistente de primer inicio, agrega un modelo y genera una clave. Tu punto de conexión es http://HOST:8080/v1.
  • Varias GPU en una máquina: paralelismo de tensores, o una réplica por tarjeta con enrutamiento según la caché.
  • Hoy, NVIDIA. La compatibilidad con GPU AMD ROCm e Intel llegará próximamente; aún sin fechas. Dinos cuál usarías: Radeon · Intel.
  • Instalación · Instalación sin conexión · Desde el código · Actualización
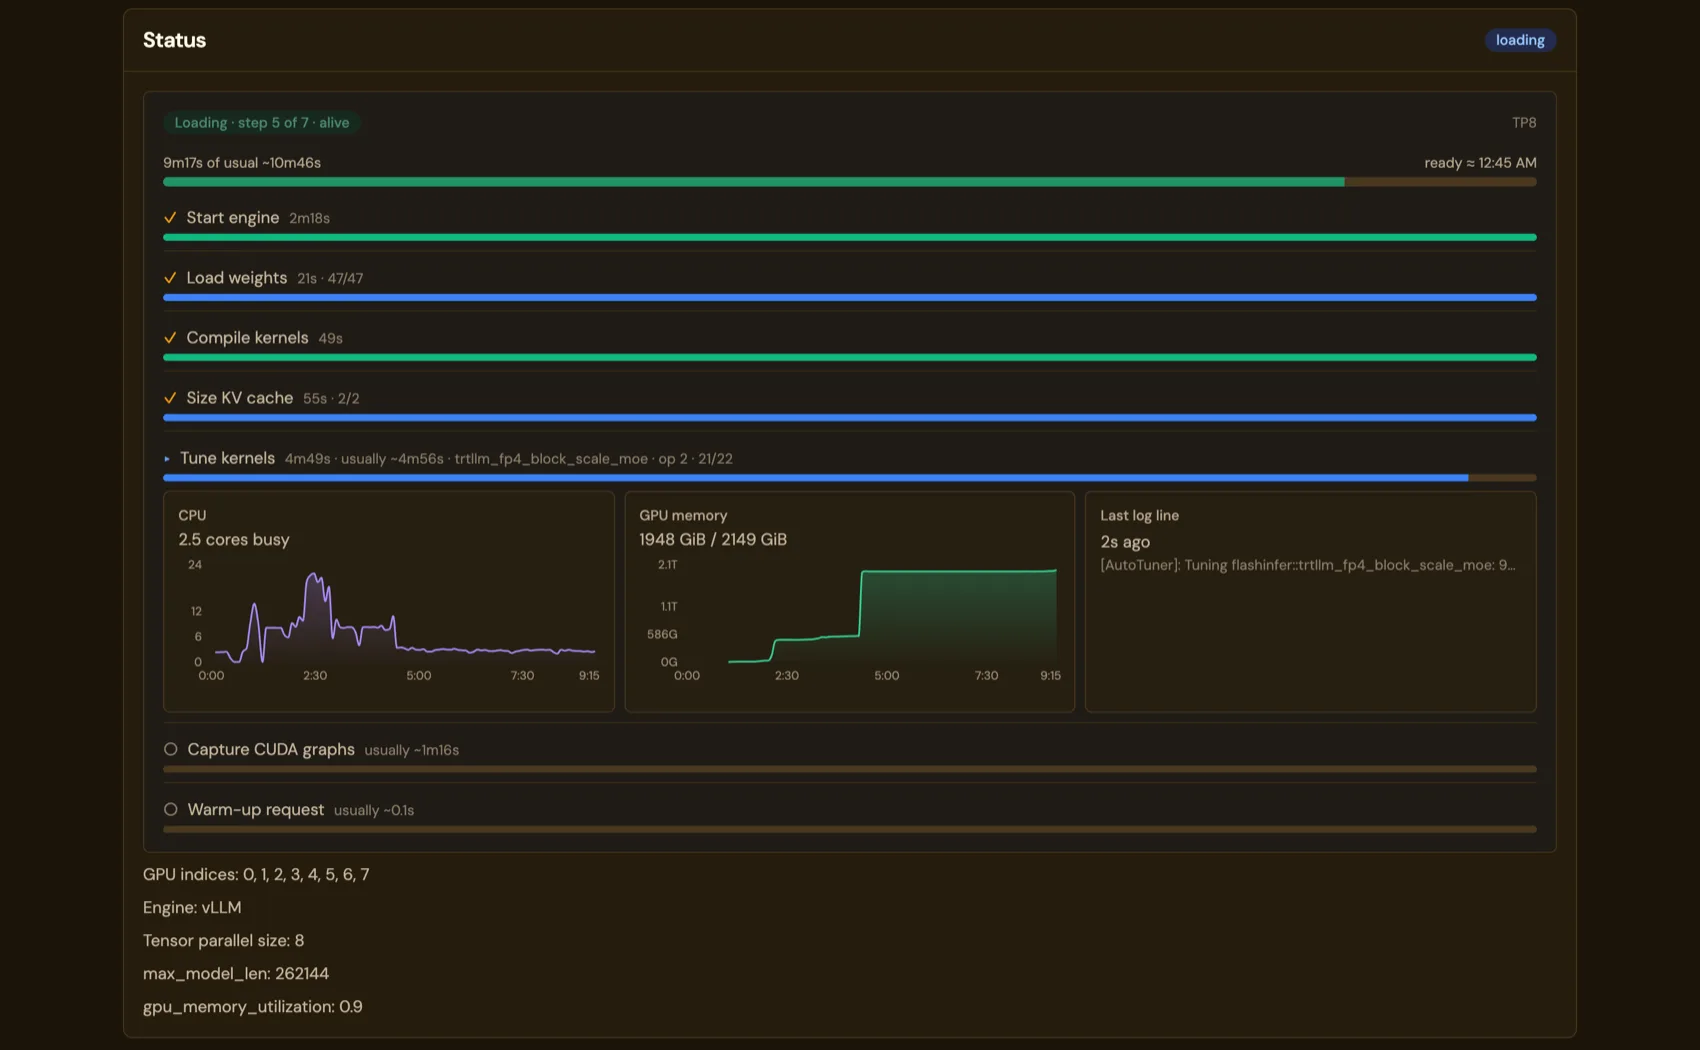
Una carga de modelo en curso en la página Models, cada paso con su tiempo transcurrido y su tiempo habitual
Un modelo cargándose tras la instalación: cada paso con el tiempo habitual de cargas anteriores.

Una app de la barra de menús, en beta.

Descargar para Mac (beta)

  • Unos 110 MB. Mac con chip de Apple (M1 o posterior), macOS 14 o posterior. SHA-256 · notas de la versión.
  • Motores: MLX y llama.cpp compilados con Metal. El mismo panel y la misma API de OpenAI; sin vLLM ni lectura de potencia.
  • Beta, sin rodeos: firmada ad hoc y sin notarizar, así que la primera vez que la abras macOS te pedirá que la permitas en Privacidad y seguridad; para actualizarla hay que volver a descargarla. Pasos para el primer inicio.
  • Solo escucha en 127.0.0.1 hasta que elijas Share on Local Network.
  • Próximamente: mlx-rust-lm, un tercer motor. El equipo de LM Warden está portando mlx-lm de Apple de Python a Rust sobre los bindings oficiales mlx-c de Apple; funcionará junto a MLX y llama.cpp y, con el tiempo, sustituirá al motor mlx-lm de Python, que, con Python y sus bibliotecas, ocupa hoy la mayor parte de la descarga. No oficial y sin afiliación con Apple.
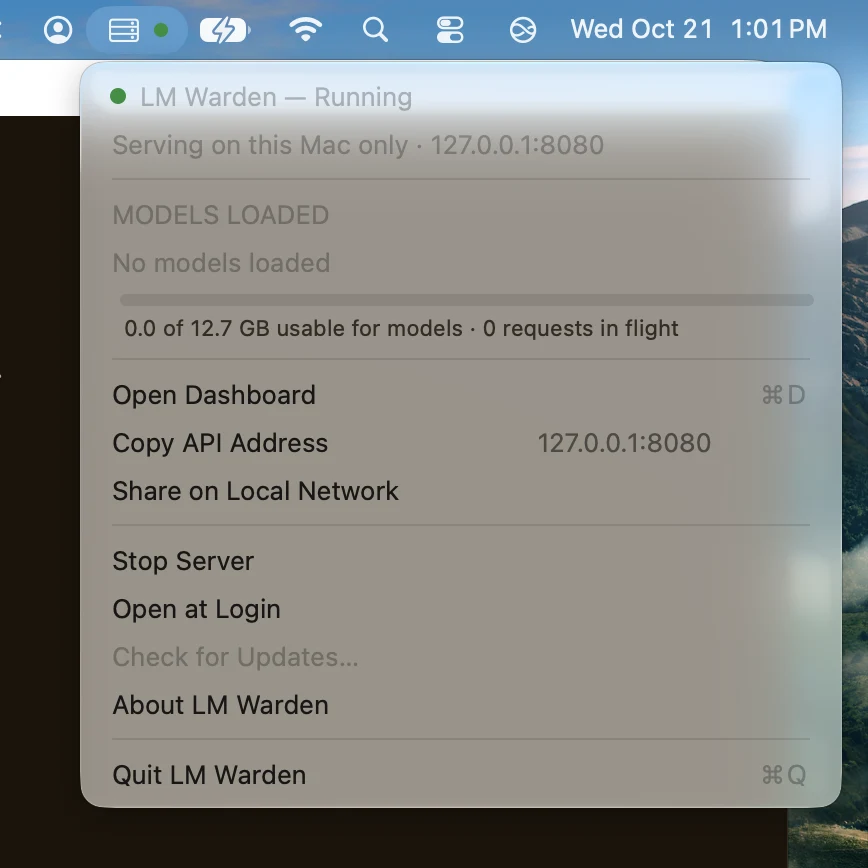
El menú de LM Warden en la barra de menús de un Mac: Running, sirviendo solo en este Mac en 127.0.0.1:8080, sin modelos cargados, una barra de memoria, Open Dashboard, Copy API Address, Share on Local Network
El menú de la beta en la barra de menús de un M1 de 16 GB.

Windows es lo siguiente, aún sin fecha.

Lo estamos desarrollando y publicaremos aquí una compilación el día que exista, no un formulario de registro antes. Mientras tanto, tienes dos opciones que sí funcionan:

  • Ejecuta LM Warden en una máquina Linux con GPU y úsalo desde Windows: todos los clientes de OpenAI, Claude Code y Codex se conectan a través de la red.
  • Sigue las versiones en GitHub para enterarte de la primera compilación para Windows.
  • Las GPU AMD Radeon e Intel llegarán después; dinos cuál usarías: Radeon · Intel.

El dispositivo dedicado: próximamente, sin fecha.

Una cuarta forma de ejecutar LM Warden, para una máquina que no debe hacer nada más.

  • Conectas una unidad USB a un chasis con GPU. Instala un Linux reducido que hace una sola cosa: ejecutar LM Warden.
  • Configura por ti la red y el almacenamiento de los modelos.
  • Las actualizaciones llegan a través de la red, o la máquina funciona totalmente aislada de la red (air-gapped).
  • Pensado para un servidor LLM seguro y dedicado: para un equipo que quiere una máquina totalmente cerrada o para una instalación sin salida a internet.

Hasta que salga, la instalación de Linux de arriba hace el mismo trabajo en un host que configuras tú mismo, incluida la instalación sin conexión / aislada de la red. Sigue las versiones en GitHub.

Todavía no hay imagen: no hay nombre de producto ni hardware que mostrar, y no vamos a inventarnos una ilustración.

¿Ya lo usas? En Linux se actualiza sobre la instalación existente: descarga las nuevas imágenes, reinicia y la base de datos se migra automáticamente a la nueva versión. Pasos · Registro de cambios.

El autoalojamiento plantea ocho problemas. Así queda resuelto cada uno.

Un motor, por sí solo, sirve un modelo en un puerto. Estas son las piezas que lo rodean, con nuestras propias cifras cuando las tenemos.

  1. ¿Cabe este modelo en mi GPU?

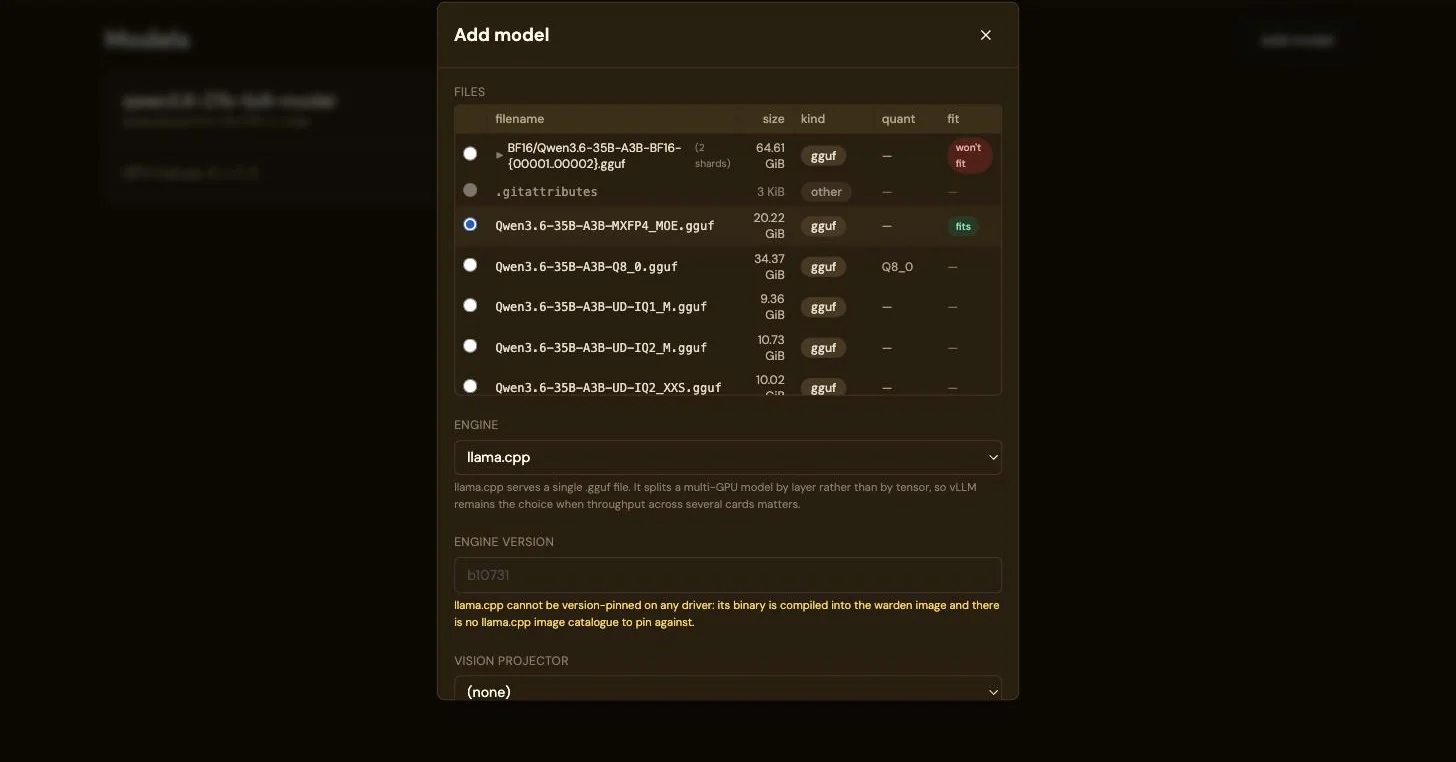
    Pega un repositorio de Hugging Face en Add model. Cada archivo aparece con un veredicto según las tarjetas que marques: cabe, cabe con poco margen o no cabe. Si marcas más tarjetas, su memoria se suma. No se descarga nada hasta que algo quepa.

    El mismo archivo de 20,22 GiB, marcado como que cabe al seleccionar cuatro GPU
  2. Has comprado GPU. ¿Están trabajando o esperando?

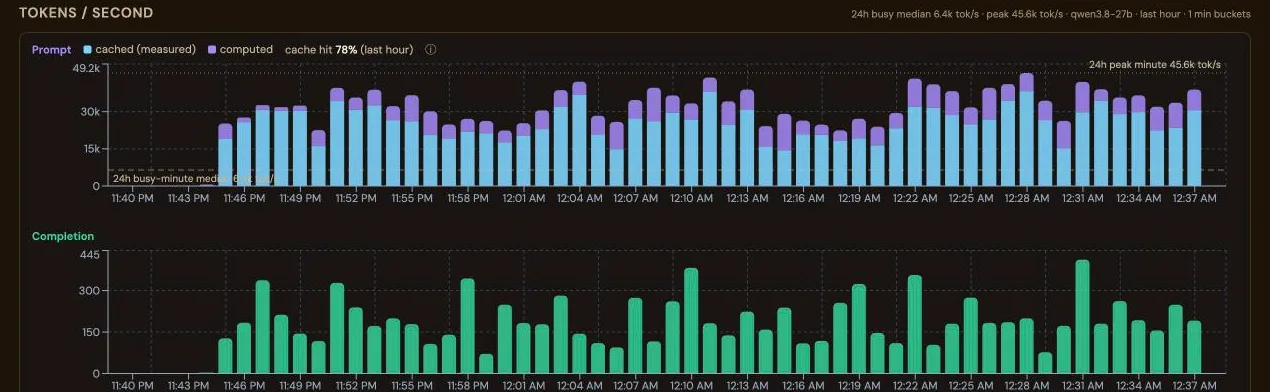
    El rendimiento depende de la concurrencia × la longitud del prompt × la reutilización de la caché, y un motor por sí solo no muestra nada de eso en conjunto. La página Stats sí, de 1 h a 7 días: VRAM, uso de GPU, potencia (Linux), tokens por segundo con los tokens de prompt divididos en servidos desde la caché y calculados, latencia p50/p95, tasa de aciertos de la caché de prompts, preempciones y solicitudes por clave y por IP de cliente. Si el uso se estanca mientras hay solicitudes en cola, aumenta la concurrencia; si la proporción de caché es baja, mantén cada sesión en la misma réplica.
    Tokens por segundo: los tokens de prompt divididos en servidos desde la caché y calculados, y debajo los tokens de respuesta
  3. Habla con el modelo antes de conectar nada.

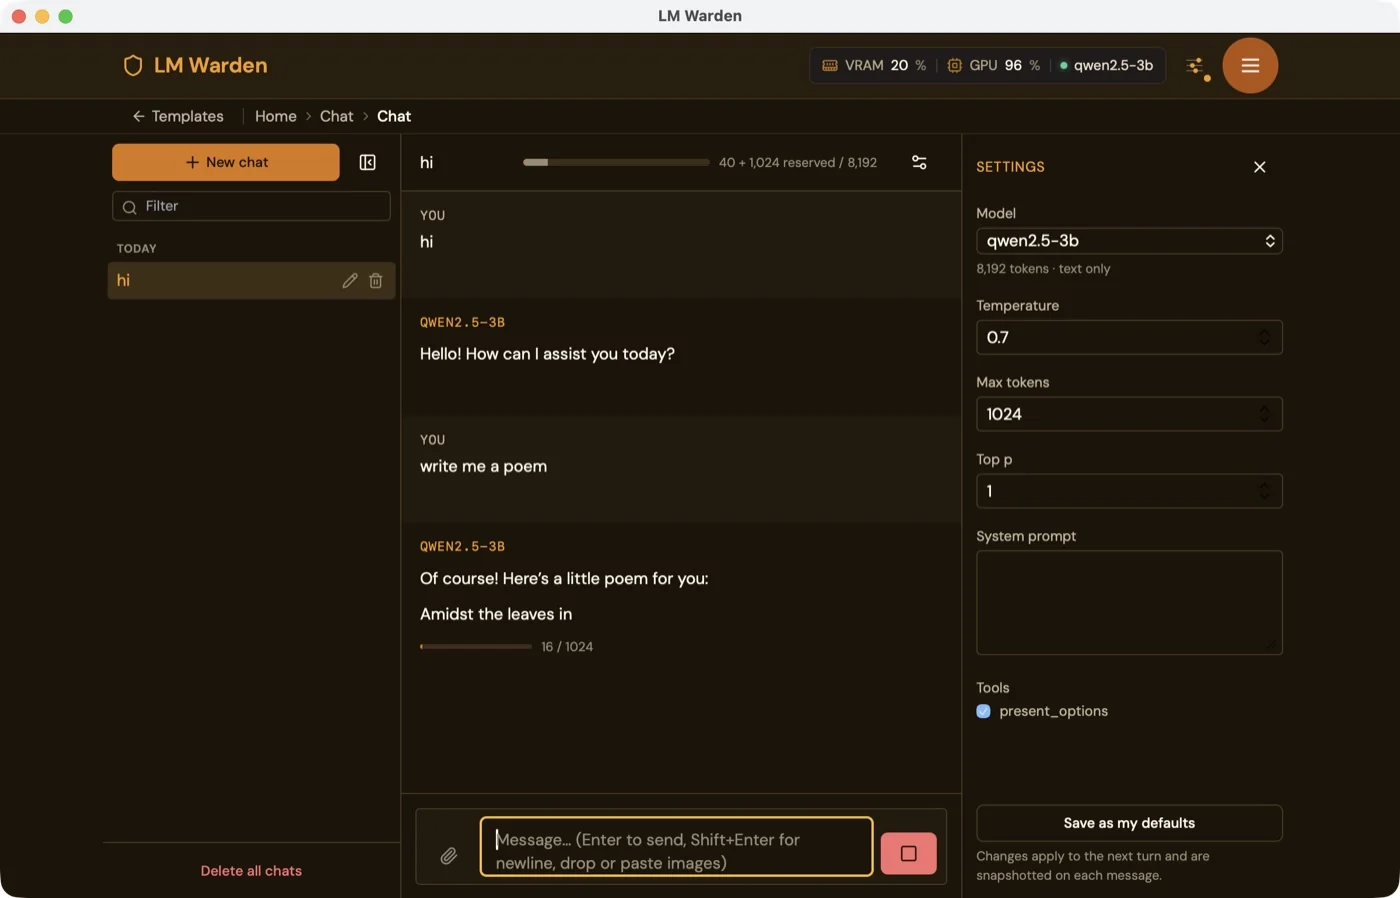
    El chat está en la misma ventana que todo lo demás. Markdown en streaming con código resaltado y fórmulas; hasta ocho imágenes PNG, JPEG o WebP por mensaje para un modelo de visión; temperatura, top-p, máximo de tokens y prompt del sistema por chat, que se guardan como valores predeterminados; los chats se guardan con título y se pueden bifurcar. Las llamadas a herramientas que hace el modelo se muestran, así que puedes comprobar que funcionan antes de que un agente dependa de ellas.

    El chat en la ventana del panel de la app para Mac, con la respuesta de qwen2.5-3b llegando en streaming y la GPU al 96 % en el encabezado
  4. ¿Qué vio y qué dijo realmente el modelo?

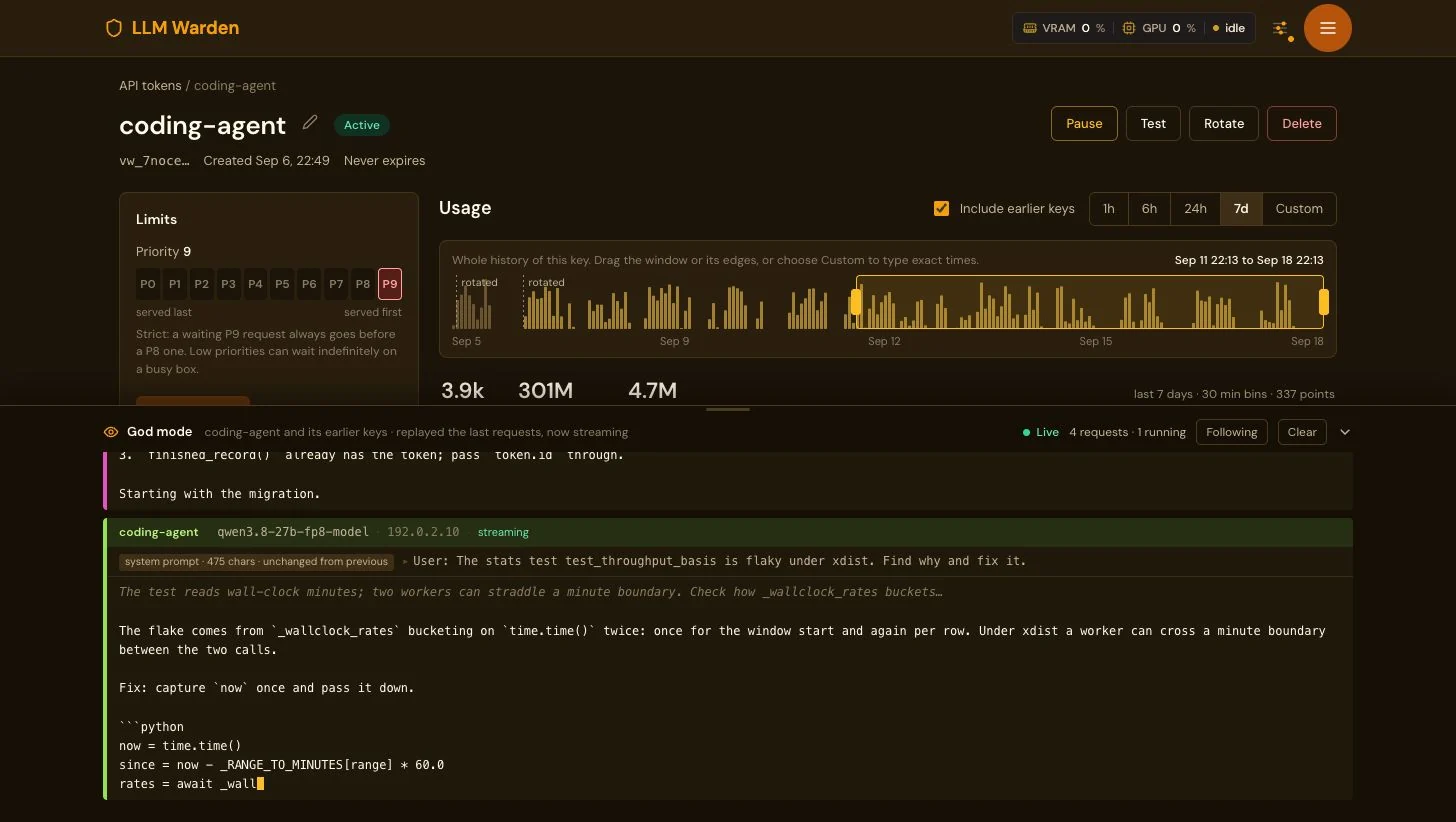
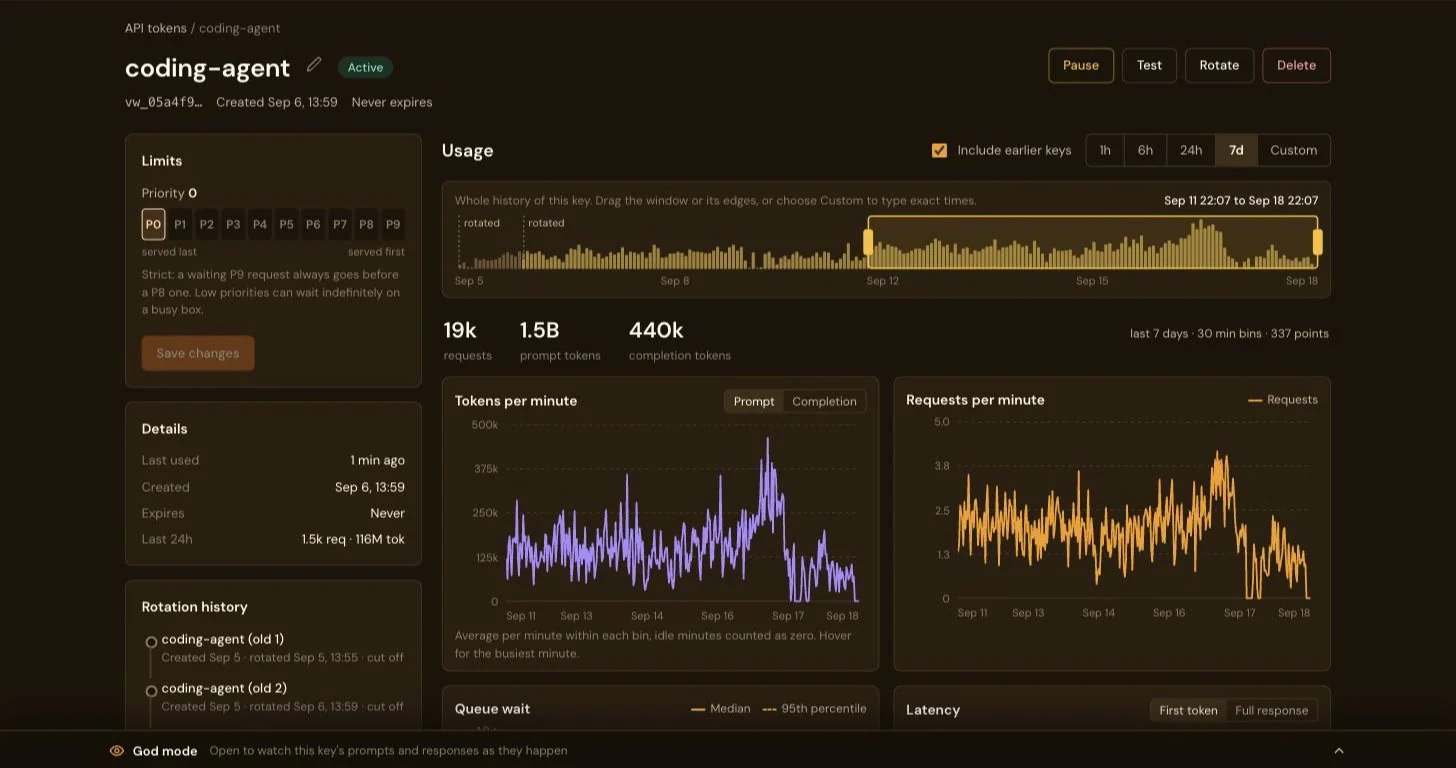
    God mode, para depurar prompts: con VW_GODMODE_ENABLED activado en la implementación, la página de cada clave incorpora un panel que transmite en directo los prompts y las respuestas de esa clave. Desactivado de forma predeterminada, y cuando está desactivado ni siquiera aparece. Es un búfer circular limitado en memoria: nada se escribe en la base de datos ni en el disco, y se borra al reiniciar. Puede abrirlo cualquiera con la sesión de administrador; el warden tiene un único rol, el de administrador.

    La página de la clave de API coding-agent con el panel God mode abierto en la parte inferior: Live, 4 requests, 1 running; una solicitud a qwen3.8-27b-fp8 desde 192.0.2.10 en streaming, con el prompt del usuario sobre una prueba de estadísticas que falla de forma intermitente y la respuesta del modelo, con una corrección en Python, escribiéndose en ese momento

Cada turno de un agente vuelve a leer toda la conversación.

Un agente reenvía todo su historial en cada turno, así que una conversación larga es, sobre todo, un prefijo que el motor ya ha leído. vLLM guarda ese trabajo en su caché de prefijos, pero solo en la réplica que lo hizo, y su propio balanceador envía cada turno a la réplica con la cola más corta. LM Warden asigna cada conversación nueva a la réplica menos cargada y la mantiene allí, gracias al ID de sesión que Claude Code ya envía. Solo mueve una solicitud cuando esa réplica supera su umbral de desbordamiento.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Cuatro turnos de una conversación en un modelo con cuatro réplicas. Con el balanceador de vLLM, cada turno pasa por el prefill (el motor lee el prompt y lo carga en la caché) casi desde cero en la réplica que lo recibe. Con LM Warden, la conversación se queda en la réplica 2 y solo el turno nuevo pasa por el prefill. Es un esquema del mecanismo, no una medición.

Medido en nuestra máquina de cuatro tarjetas (4 × RTX A4000, Qwen3-4B como cuatro réplicas de una tarjeta cada una, sesiones sintéticas al estilo de Claude Code, primero sin afinidad y después con ella, una prueba tras otra): con cada conversación fijada a su réplica, la proporción de tokens de prompt servidos desde la caché subió del 56 al 86 % con 4 sesiones simultáneas, y la mediana del tiempo hasta el primer byte bajó de 2,05 a 0,38 s. Los tokens de salida por minuto fueron mayores en todos los escalones que probamos, y el p95 del tiempo hasta el primer byte (el 5 % más lento) fue menor en todos ellos. El número de réplicas con trabajo apenas cambió (2,71 frente a 2,83 de cuatro con 4 sesiones): la mejora viene de reutilizar la caché, no de tener más tarjetas trabajando.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Tasa de aciertos de la caché de prefijos en cada escalón: tokens de prompt servidos desde la caché divididos entre los tokens de prompt solicitados, sumando las cuatro réplicas, según la variación de los contadores del propio vLLM durante el escalón. La mejora se mantiene mientras hay margen y desaparece con 32 sesiones, cuando las conversaciones se desbordan a otras réplicas.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Tiempo hasta el primer byte con 4 a 32 sesiones simultáneas, mediana y p95, en escala logarítmica para que los escalones de menos de un segundo se puedan comparar con los de un minuto. Con afinidad, la mediana es mucho más baja hasta 16 sesiones (0,38 frente a 2,05 s con 4) y más alta con 24 y 32; el p95 es menor en todos los escalones, aunque con 16 la diferencia (24,9 frente a 26,2 s) está dentro del ruido de una sola ejecución por variante. Medido en el cliente, a través de internet, hasta el primer token recibido.

Todos los escalones de la rampa, sin y con afinidad

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Medido en nuestra máquina de cuatro tarjetas con un modelo pequeño, primero sin afinidad y después con ella, sin reiniciar vLLM entre medias: la segunda variante empezó con la caché de prefijos ya caliente, y ambas generaron sus prompts con la misma semilla. Cada escalón dura 3 minutos, así que solo completa entre 9 y 31 sesiones, y una sesión de más o de menos cambia las sesiones por hora en 20; los tokens de salida por minuto son la columna más estable. Tu modelo, tus tarjetas y tu carga de trabajo serán distintos; el panel de réplicas en la página de un modelo muestra los mismos contadores para los tuyos.

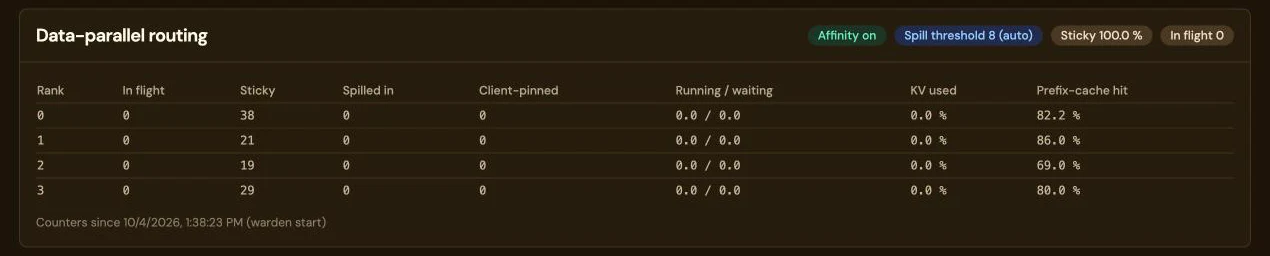
El panel Data-parallel routing en la página de un modelo, con las etiquetas Affinity on, Spill threshold 8 (auto), Sticky 100.0% e In flight 0. Una tabla enumera las réplicas 0 a 3 con in flight, sticky (38, 21, 19 y 29), spilled in, client-pinned, running y waiting, la KV usada y la tasa de aciertos de la caché de prefijos (82,2; 86,0; 69,0 y 80,0 por ciento), y una línea que indica que los contadores acumulan desde que se inició el warden.
Los mismos contadores en la página de un modelo: una fila por réplica con las solicitudes que tiene en curso, cuántas conversaciones se quedaron (sticky) o llegaron por desbordamiento, lo que se está ejecutando y lo que espera, la caché KV en uso y la tasa de aciertos de la caché de prefijos. Captura del 4 de octubre de 2026 con la afinidad activada y el umbral de desbordamiento en 8 (auto): sticky 100 % y una tasa de aciertos de la caché de prefijos de 82,2; 86,0; 69,0 y 80,0 % en las réplicas 0 a 3. Es una captura del panel, no un resultado de medición. Toca la imagen para ampliarla.

Dónde sale perdiendo. Los escalones de 24 y 32 sesiones son una sobrecarga deliberada de cuatro tarjetas pequeñas, y todas las réplicas están saturadas. La salida sigue siendo mayor (11.178 frente a 9.048 y 16.638 frente a 14.760 tokens por minuto) y las solicitudes más lentas tardan mucho menos (p95 38 frente a 59 s, y 39 frente a 83 s), pero la mediana del tiempo hasta el primer byte es peor con afinidad: 13,1 frente a 5,1 s con 24 sesiones y 27,7 frente a 12,3 s con 32. No hemos aislado la causa, y bajar el umbral de desbordamiento de 8 a 4 no cambió nada.

Si tu máquina va muy cargada, mide las dos opciones. La ventaja es mayor mientras hay margen; si tu máquina funciona al límite, compara ambas configuraciones; la afinidad se puede desactivar por modelo. Las réplicas, y por tanto este enrutamiento, forman parte de la instalación de Linux con GPU NVIDIA; la app para Mac (beta) no tiene paralelismo de tensores ni de datos.

El método completo: la carga de trabajo, el banco de pruebas, el umbral de desbordamiento y una máquina de siete GPU que lo usa desde entonces →

Conecta tu agente de programación a tus propias GPU.

Diez agentes y clientes se conectan con una URL base y una clave; con dos de ellos puedes además seguir usando una suscripción de pago a Claude para el trabajo difícil.

Conserva tu suscripción a Claude y deriva a tus GPU las llamadas rutinarias

Claude Code y el Anthropic SDK, a través del enrutador. Una regla indica en lugar de qué modelos de Claude responden tus GPU; todo lo demás va a Anthropic con tu propia cuenta o clave.

Adónde va una solicitud de Claude Code El agente envía cada solicitud al enrutador de LM Warden. Las solicitudes para modelos claude-haiku van a un modelo en tu GPU, que responde en nombre de ese modelo. Cualquier otro modelo, Opus incluido, se reenvía a Anthropic con tu propia cuenta. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Adónde va una solicitud de Claude Code El agente envía cada solicitud al enrutador de LM Warden. Las solicitudes para modelos claude-haiku van a un modelo en tu GPU, que responde en nombre de ese modelo. Cualquier otro modelo, Opus incluido, se reenvía a Anthropic con tu propia cuenta. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
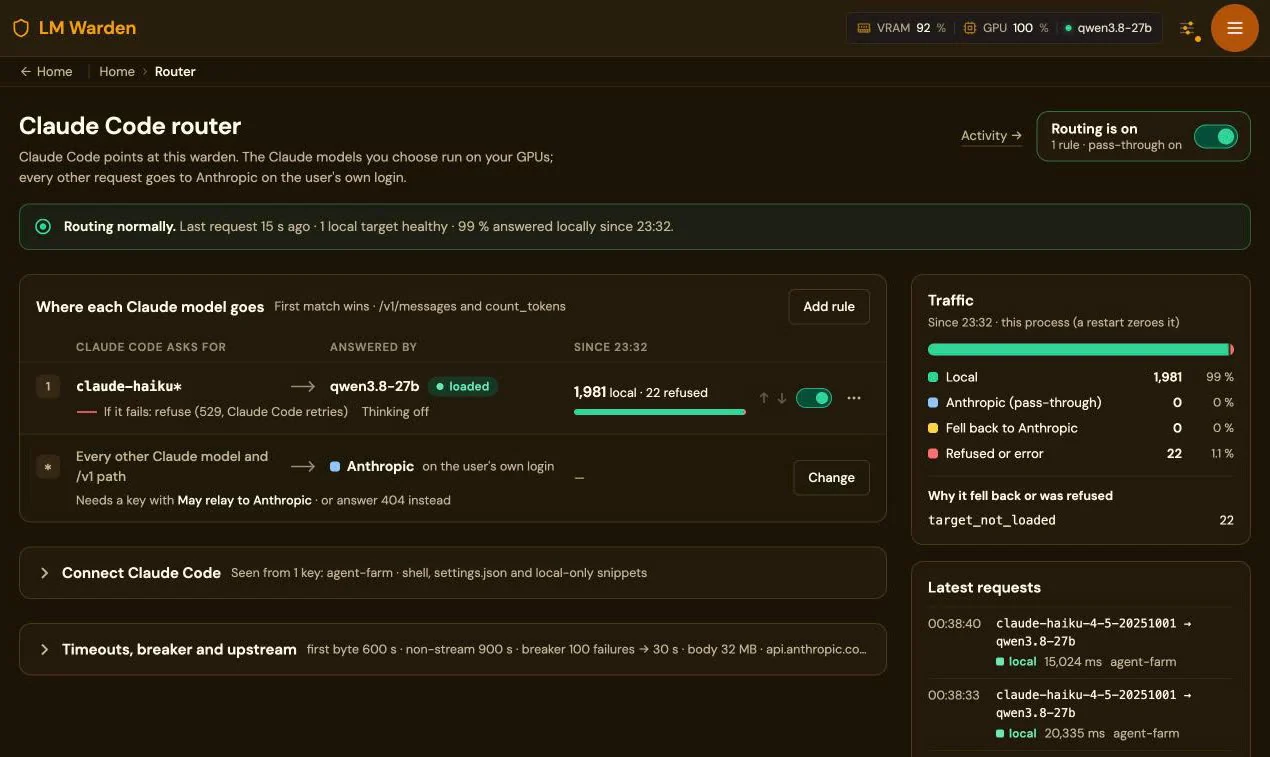
1.981solicitudes respondidas por el modelo local: el 99 % del tráfico de Claude Code de la máquina desde su reinicio. Datos de la página Router de nuestra propia máquina de siete GPU, 21 de octubre de 2026; 22 rechazadas mientras el modelo de destino no estaba cargado.
La página del enrutador de Claude Code: enrutamiento activado, 99 % respondido por el modelo local desde las 23:32; la regla 1 envía claude-haiku* a qwen3.8-27b, 1.981 locales y 22 rechazadas; cualquier otro modelo de Claude va a Anthropic con la cuenta del propio usuario
Claude Code 2.1.227 o posterior: ANTHROPIC_BASE_URL apuntando al warden, la clave del warden en ANTHROPIC_CUSTOM_HEADERS y tu sesión de Claude sin tocar. No hemos evaluado la calidad de las respuestas: encarga al modelo local el trabajo rutinario y bien definido.

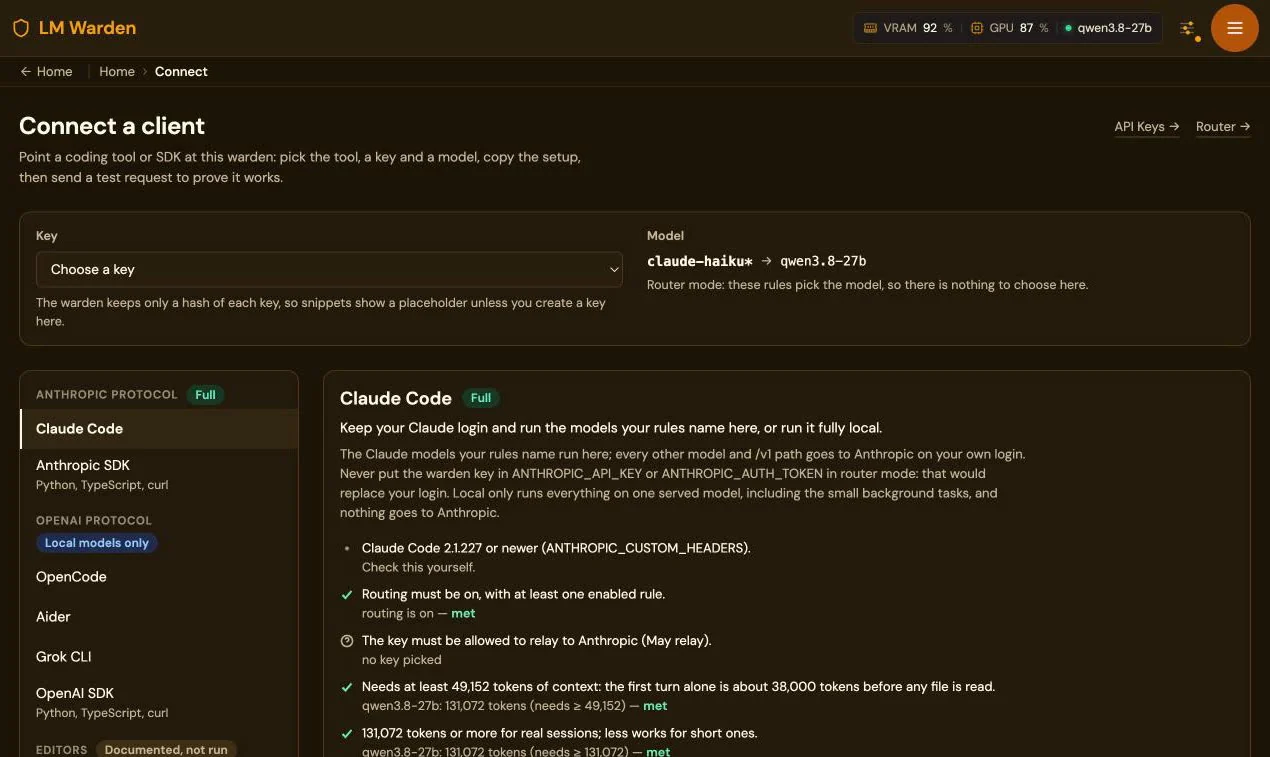
Connect genera la configuración de cada cliente y envía una solicitud de prueba.

Elige en la consola el cliente, una clave y un modelo cargado; Connect comprueba cada requisito con lo que está cargado de verdad (ventana de contexto, llamadas a herramientas, enrutador activado) y te da los archivos listos para pegar. Todos los agentes de programación: una página por cliente con lo que funciona y lo que observamos.

La página Connect a client: un selector de clave, la regla del enrutador claude-haiku* a qwen3.8-27b, los clientes agrupados por protocolo y el panel de Claude Code con sus requisitos comprobados

Deja que la IA por la que ya pagas ajuste tus propias GPU.

Elegir un modelo para tus tarjetas implica elegir una cuantización, un motor, cómo repartirlo entre las GPU, cuánto contexto darle y el tipo de caché KV; cada intento cuesta una descarga y una carga. Todo lo que hace la consola es una llamada a la API, así que Claude Code, Codex u otro agente con acceso a un shell puede hacer esa búsqueda por ti, en tu hardware y con tu carga de trabajo.

El ciclo

El ciclo de ajuste Inventariar las GPU, preseleccionar modelos con la vista previa de capacidad antes de descargar nada, cargar distribuciones candidatas, medir su rendimiento con solicitudes reales, ajustar la configuración y dejar cargada la mejor. Las mediciones y los ajustes se repiten hasta que el agente da el resultado por bueno. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner El ciclo de ajuste Inventariar las GPU, preseleccionar modelos con la vista previa de capacidad antes de descargar nada, cargar distribuciones candidatas, medir su rendimiento con solicitudes reales, ajustar la configuración y dejar cargada la mejor. Las mediciones y los ajustes se repiten hasta que el agente da el resultado por bueno. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

Lo que llama el agente: GET /api/system/gpus, POST /api/models/fit-preview antes de cualquier descarga, el registro y suggest-config, la descarga y la carga, una prueba de estrés que encuentra y aplica el límite real de contexto, GET /api/stats/v2/throughput y latency, y una clave de inferencia que el propio agente genera para enviar tráfico de prueba. Antes de nada lee /agent-guide.md, una breve descripción de estas llamadas escrita para un modelo de lenguaje.

Una carga de modelo en curso en la página Models: cada paso con su tiempo transcurrido y su tiempo habitual
Lo que vigila el agente mientras se carga una distribución: cada paso con el tiempo habitual de cargas anteriores. Si una carga deja de avanzar, se detiene y sus GPU quedan libres.

Cuatro prompts para pegar y lo que obtienes con cada uno

  1. Inventario y preselección. Pide: enumera mis GPU, preselecciona tres modelos de pesos abiertos para programación con agentes que quepan con al menos 65.536 tokens de contexto, comprueba cada uno con fit-preview y no descargues nada. Obtienes: una tabla con modelo, cuantización, motor, GPU, contexto y el motivo de cada elección.
  2. Motor y distribución para un modelo. Pide: decide entre vLLM y llama.cpp, y entre paralelismo de tensores y réplicas con paralelismo de datos en mis tarjetas; carga las dos mejores distribuciones, envía a cada una las mismas 20 solicitudes en streaming y compáralas con concurrencia 1 y 8. Obtienes: el tiempo hasta el primer token y los tokens por segundo de ambas, la mejor cargada, la otra descargada y la clave de prueba revocada.
  3. Encontrar los límites reales y aplicarlos. Pide: haz una prueba de estrés del modelo cargado, aplica el contexto medido y después mide el rendimiento con concurrencia 1, 4 y 16 y prompts de unos 2 mil y 30 mil tokens. Obtienes: el límite de contexto guardado en la configuración del modelo y una tabla con el tiempo hasta el primer token y los tokens por segundo para cada concurrencia y tamaño de prompt.
  4. Comparar dos candidatos con tu propio trabajo. Pide: vuelve a enviar los prompts de ./workload/*.txt al modelo A y al modelo B con concurrencia 4 y evalúa cada respuesta. Obtienes: model-comparison.md con latencia, tokens por segundo, corrección según el criterio del agente y una recomendación; el modelo recomendado queda cargado.

Antes de empezar. Un token de administrador tiene todos los permisos de administración sobre el warden (modelos, claves, configuración; aún no hay permisos más restringidos): dale una caducidad corta y revócalo en Settings → Access Tokens cuando termine el trabajo. Una prueba de estrés hace fallar un motor a propósito para encontrar su límite: ejecuta estos prompts en un warden del que no dependa nadie más. Las descargas son grandes; los prompts comprueban que el modelo cabe antes de descargarlo, pero vigila el espacio en disco.

Elegir motor y distribución (vLLM, paralelismo de tensores o de datos) es cosa de la instalación de Linux; en un Mac, la elección es entre MLX y llama.cpp en una sola GPU. El modelo que hace el ajuste puede ser cualquiera por el que ya pagues; el modelo que se ajusta es el que está en tus tarjetas. La página de ajuste con agentes: los cuatro prompts completos.

Una máquina con GPU, compartida por todo tu equipo, tu familia y tus agentes.

Crea tantas claves de API como necesites y repártelas: un colega, un familiar, un trabajo de CI, una granja de agentes, cada uno con su propia clave, su propia prioridad y su propia página de uso. El hardware trabaja para todos, y el trabajo importante nunca se queda esperando.

Tu hardware, tal como es: de un Mac a ocho B300.

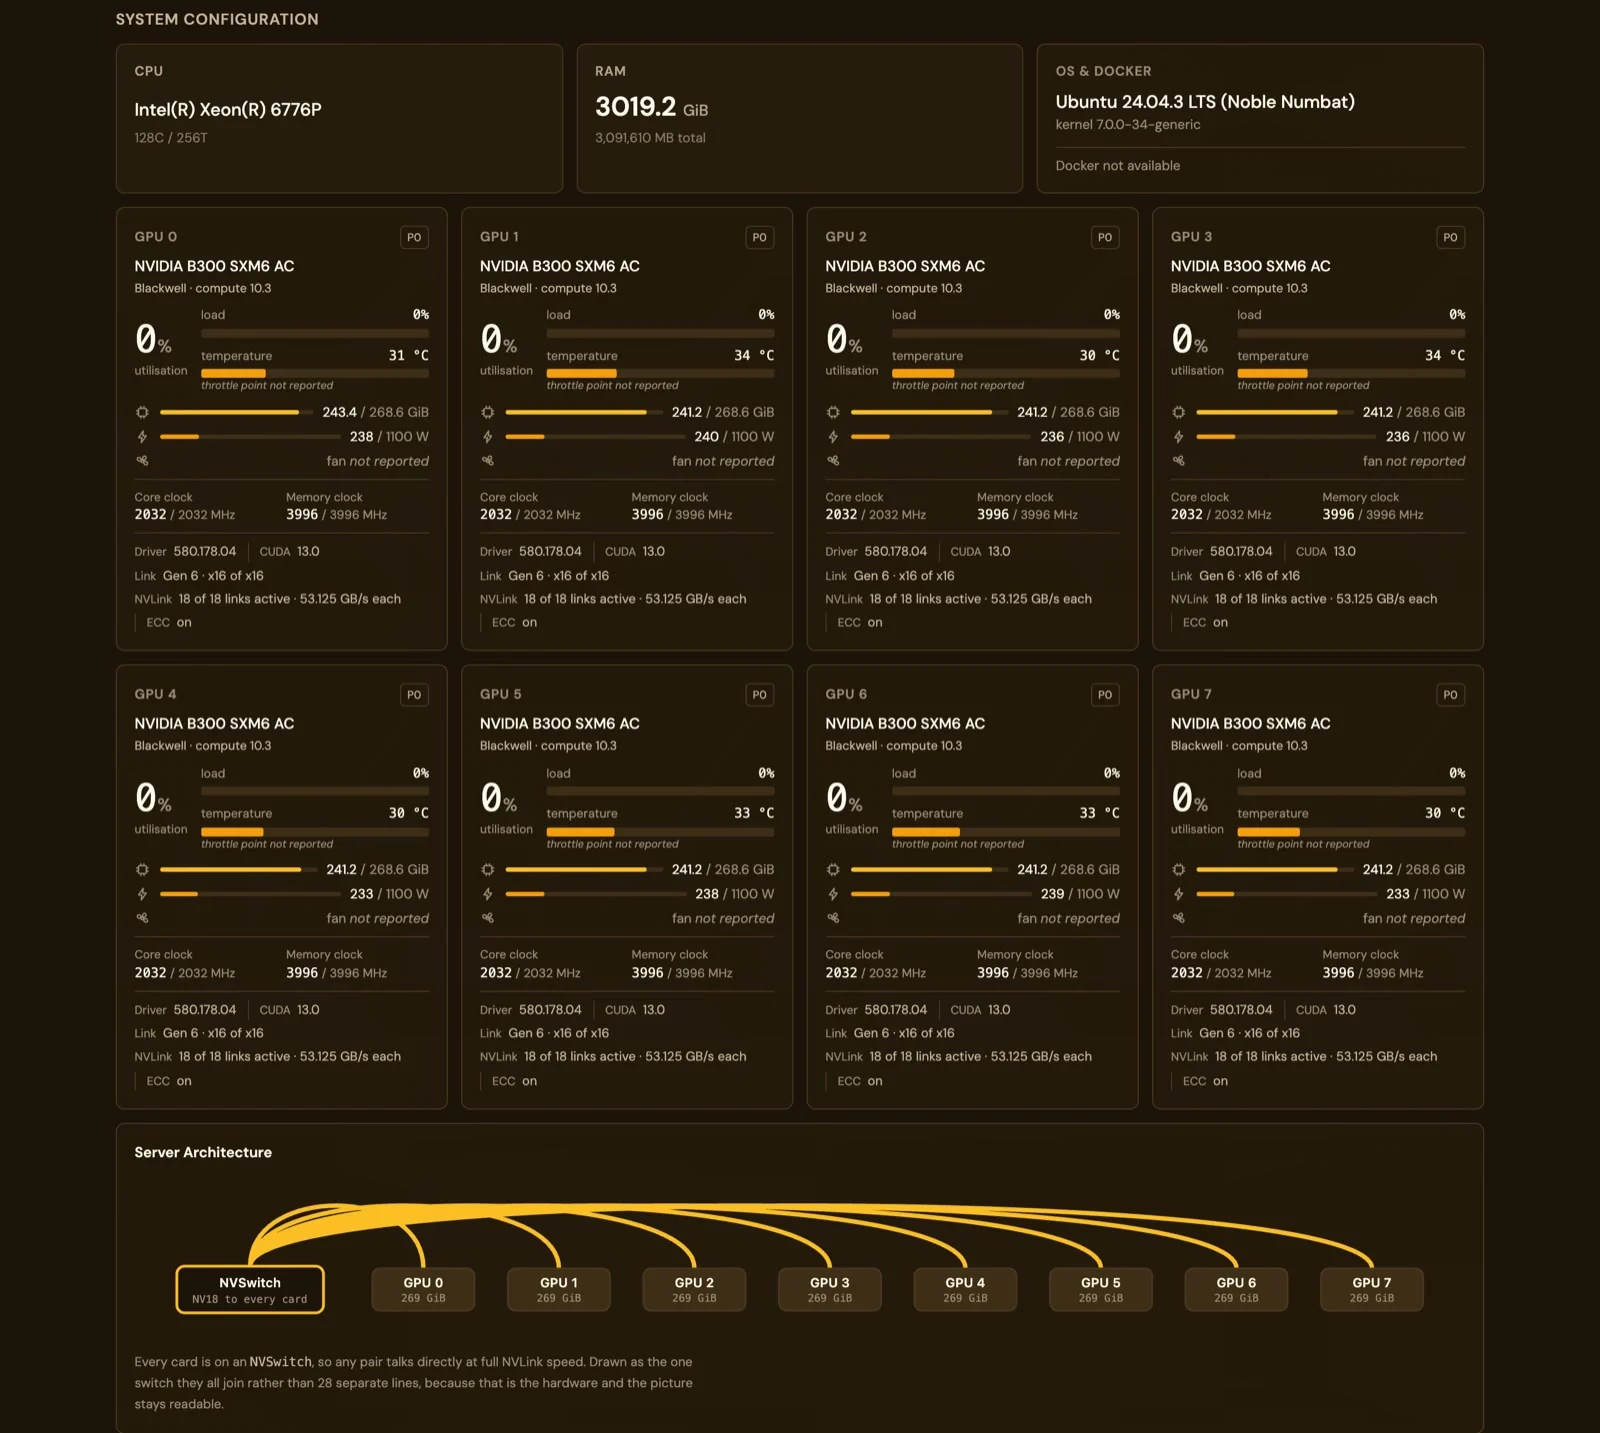
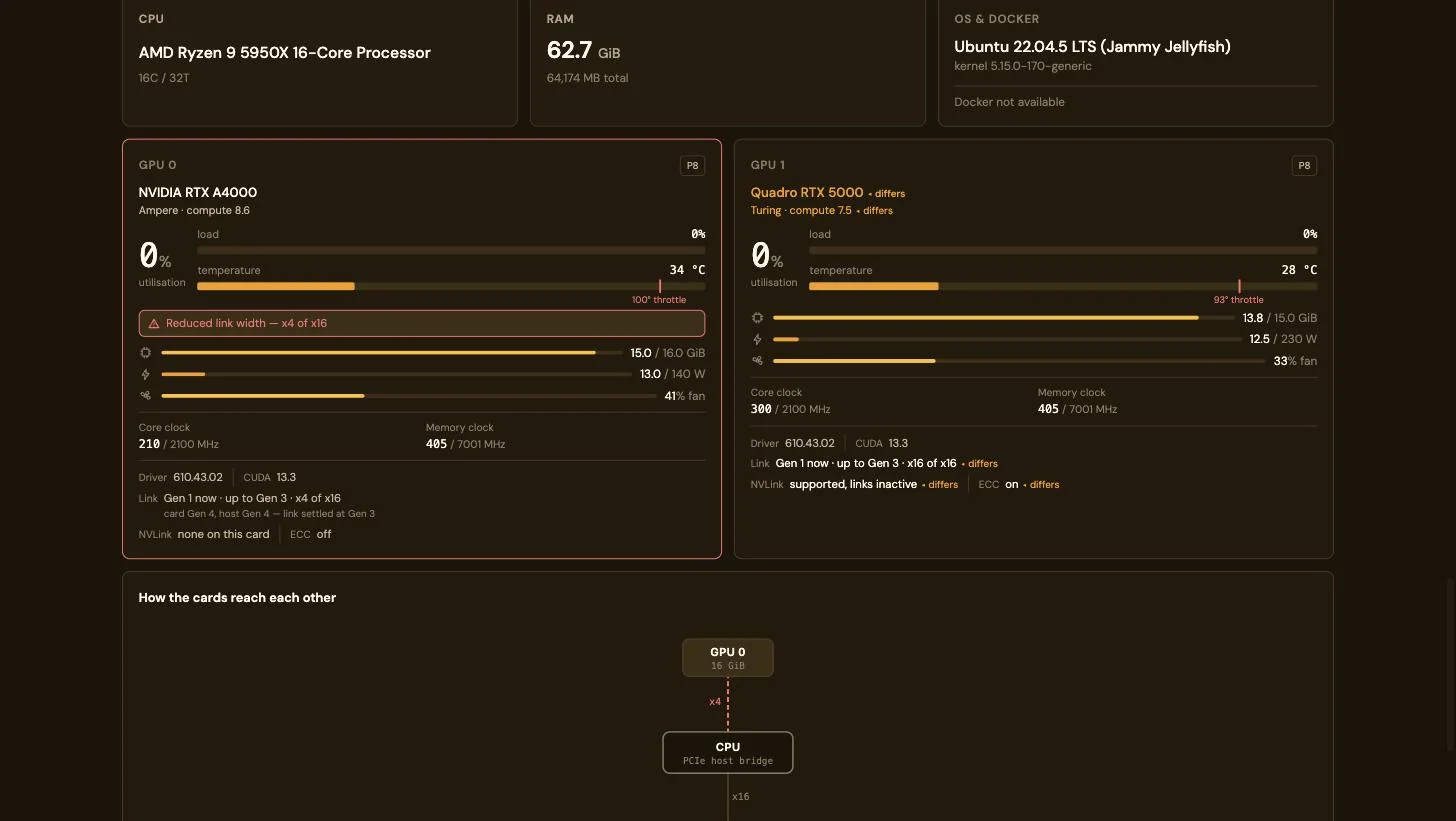
La misma consola analiza un M1 de 16 GB, dos tarjetas dispares en un PC bajo la mesa y un servidor NVSwitch de 8 × B300, y señala el cuello de botella en lugar de diluirlo en un promedio: un enlace PCIe negociado a x4 en vez de x16, enlaces NVLink inactivos, ECC distinto entre tarjetas.

Configuración del sistema en un servidor de 8 × B300: Intel Xeon 6776P, 3019 GiB de RAM, ocho paneles NVIDIA B300 SXM6, cada uno con 241 de 268,6 GiB en uso, Link Gen 6 x16 de x16, NVLink con 18 de 18 enlaces activos a 53,125 GB/s cada uno, ECC activado y un esquema de la arquitectura del servidor con un NVSwitch conectado a cada tarjeta
Ocho tarjetas B300 SXM6 en un NVSwitch: 18 de 18 enlaces NVLink activos por tarjeta, ECC activado, PCIe Gen 6 x16, 241 de 268,6 GiB en uso por tarjeta mientras sirven GLM-5.2 NVFP4 con paralelismo de tensores 8.
Dos GPU dispares: una NVIDIA RTX A4000 con un aviso rojo Reduced link width x4 de x16 y Link Gen 1 ahora, hasta Gen 3, junto a una Quadro RTX 5000 cuya arquitectura, VRAM, límite de potencia, enlace, NVLink y ECC aparecen marcados como differs; debajo, un esquema de cómo llegan las tarjetas a la CPU por enlaces x4 y x16
Dos tarjetas compradas con años de diferencia: el enlace de la A4000 funciona a x4 en vez de x16 y aparece marcado en rojo; la arquitectura, el límite de potencia, NVLink (compatible, enlaces inactivos) y ECC de la Quadro aparecen marcados como differs. El esquema muestra qué ranura es la estrecha.
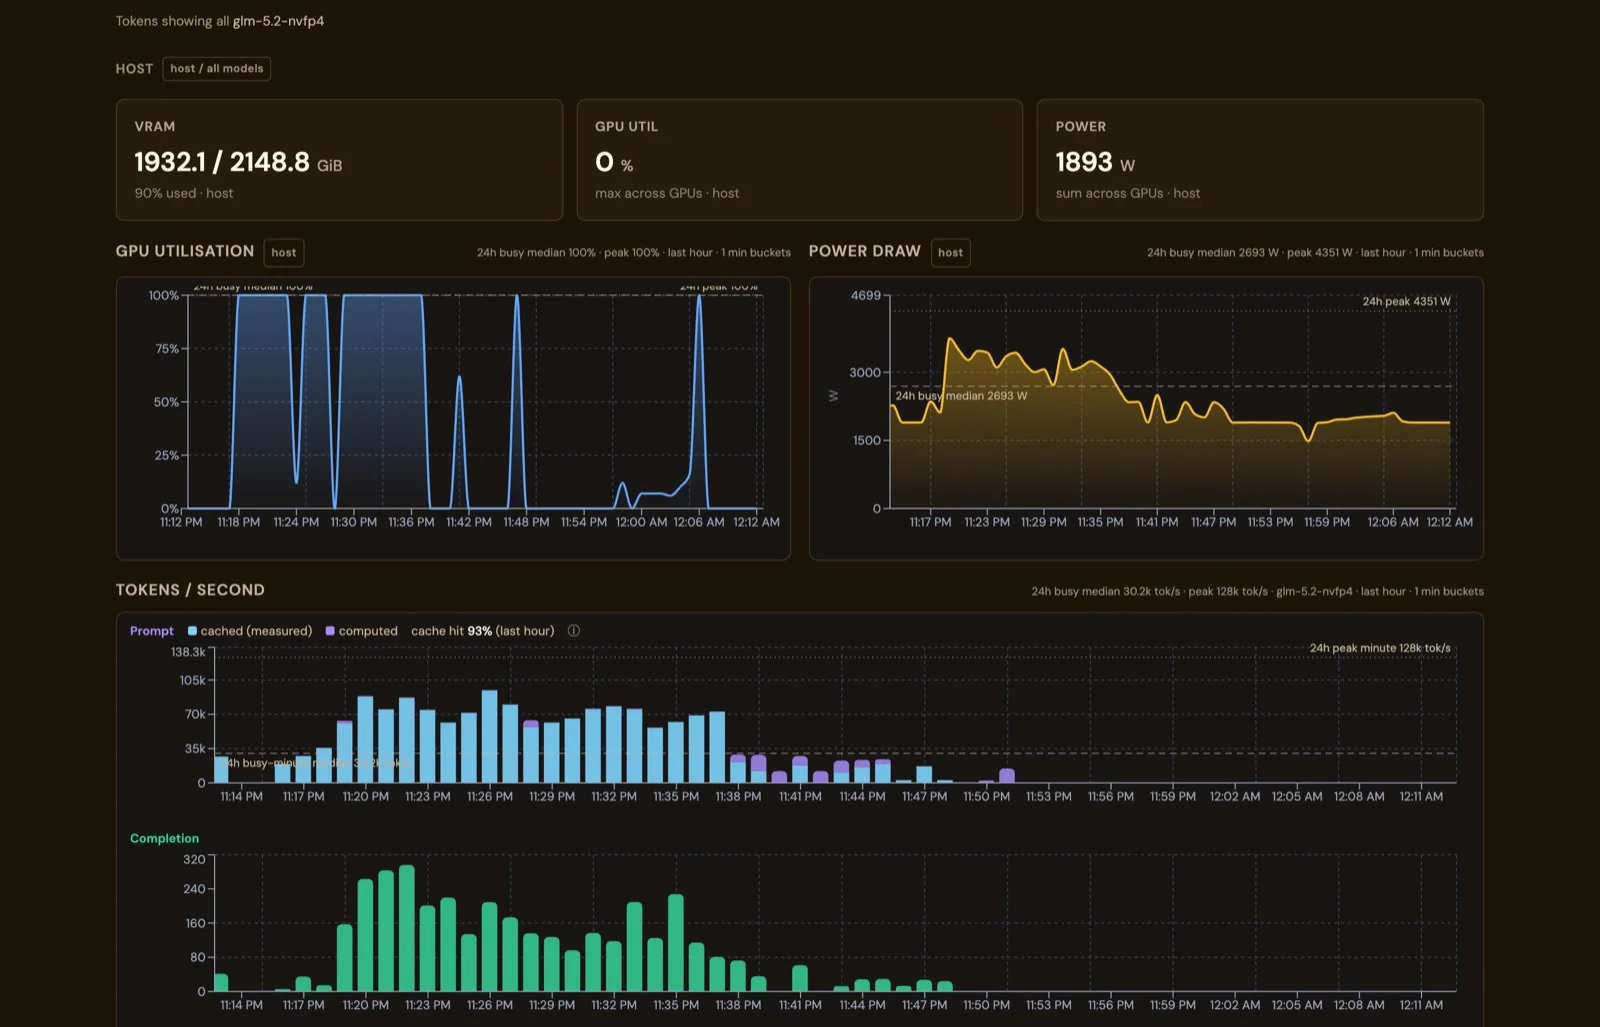
Stats en el servidor de 8 × B300: VRAM 1932,1 de 2148,8 GiB, potencia de 1893 W sumando todas las tarjetas, uso de GPU y consumo eléctrico de la última hora, y tokens de prompt por segundo divididos en servidos desde la caché y calculados, con un 93 % de aciertos de caché
La misma página Stats en lo más alto de la gama: 1.932 de 2.149 GiB de VRAM, 1.893 W entre todas las tarjetas, un pico de 4.351 W en esa hora y el 93 % de los tokens de prompt servidos desde la caché.
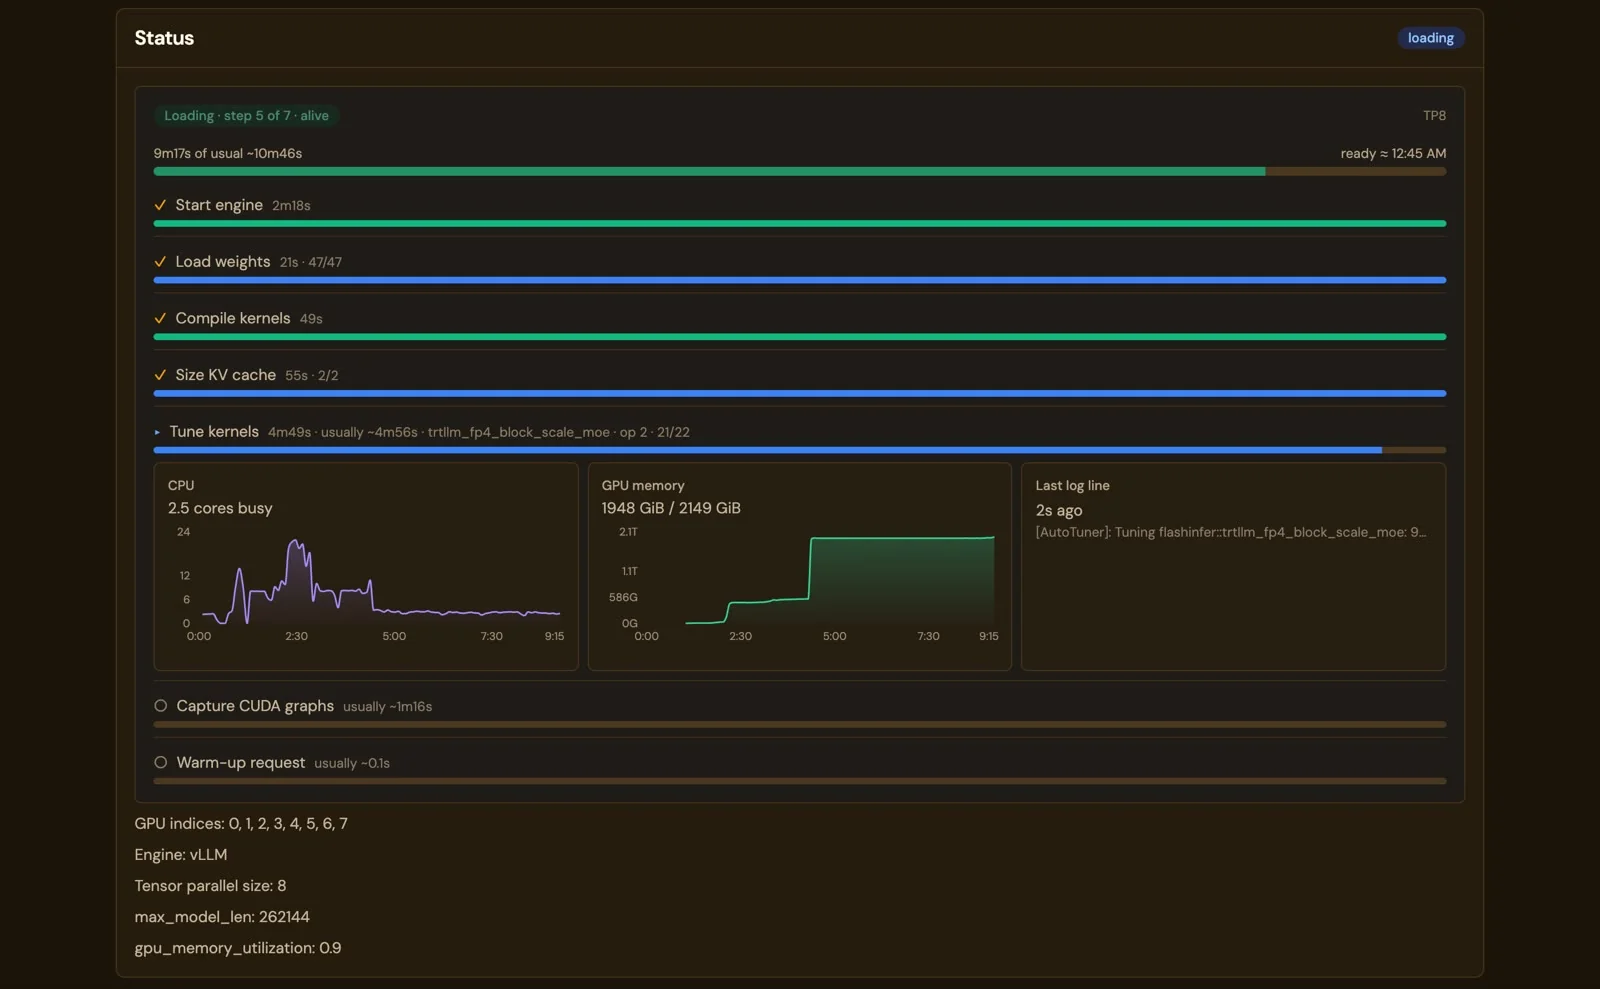
La página del modelo mientras GLM-5.2 NVFP4 se carga en ocho B300: a los 9 min 17 s de unos 10 min 46 s habituales, con los pasos Start engine, Load weights 47 of 47, Compile kernels y Size KV cache terminados y Tune kernels en op 21 of 22, más gráficos de CPU y memoria de GPU y la última línea del registro
Una carga de 10 minutos, paso a paso: GLM-5.2 NVFP4 en ocho B300, a los 9 min 17 s de unos 10 min 46 s habituales, sin nada en rojo mientras siga avanzando.

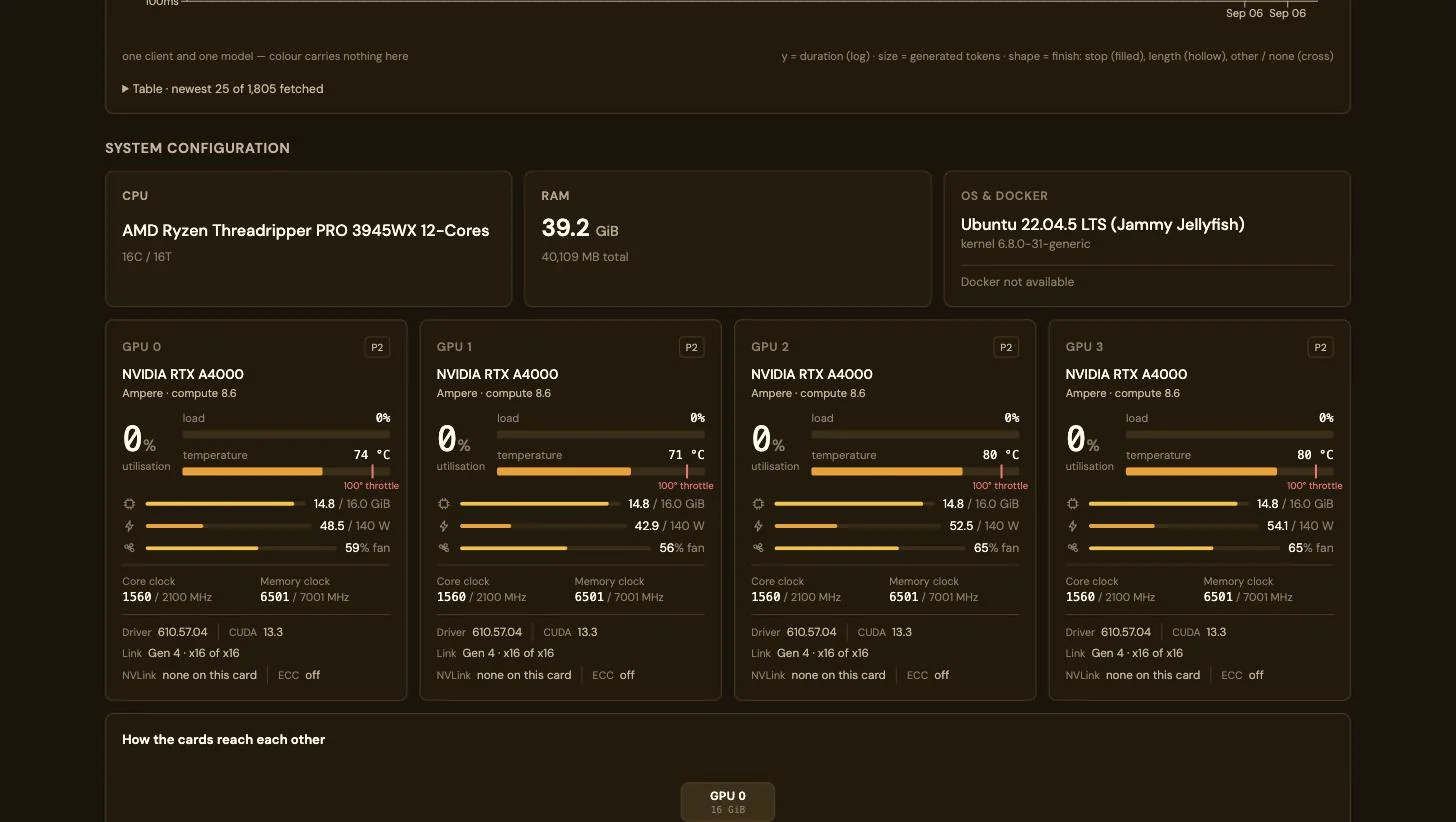
Lo que muestra cada panel por tarjeta: la temperatura frente a su propio umbral de limitación térmica, la potencia frente a su límite, frecuencias, ventilador, la generación y el ancho PCIe negociados en ese momento, ECC y NVLink si la tarjeta los tiene, y el proceso que ocupa la memoria. El esquema de interconexión se obtiene de nvidia-smi topo -m. En un Mac: el uso de GPU y el presupuesto de memoria que indica Metal, sin potencia. Y el motor que hay debajo de todo se vigila con su propio /health, no con la tabla de procesos: si el motor se cae mientras el proceso que lo envuelve sigue vivo, se recarga y se conservan los datos de diagnóstico.

Lo que muestra

Supervisión de GPU

Cada tarjeta, con sus propios datos.

Uso, temperatura frente al umbral de limitación térmica de esa tarjeta, potencia frente a su límite, VRAM, frecuencias, enlace PCIe y qué proceso ocupa la memoria. Nada de promedios de toda la máquina.

Configuración del sistema y cuatro paneles de GPU para tarjetas NVIDIA RTX A4000 con uso, temperatura, VRAM, potencia, ventilador y frecuencias por tarjeta

Solicitudes en curso

Mira qué está haciendo cada agente ahora mismo.

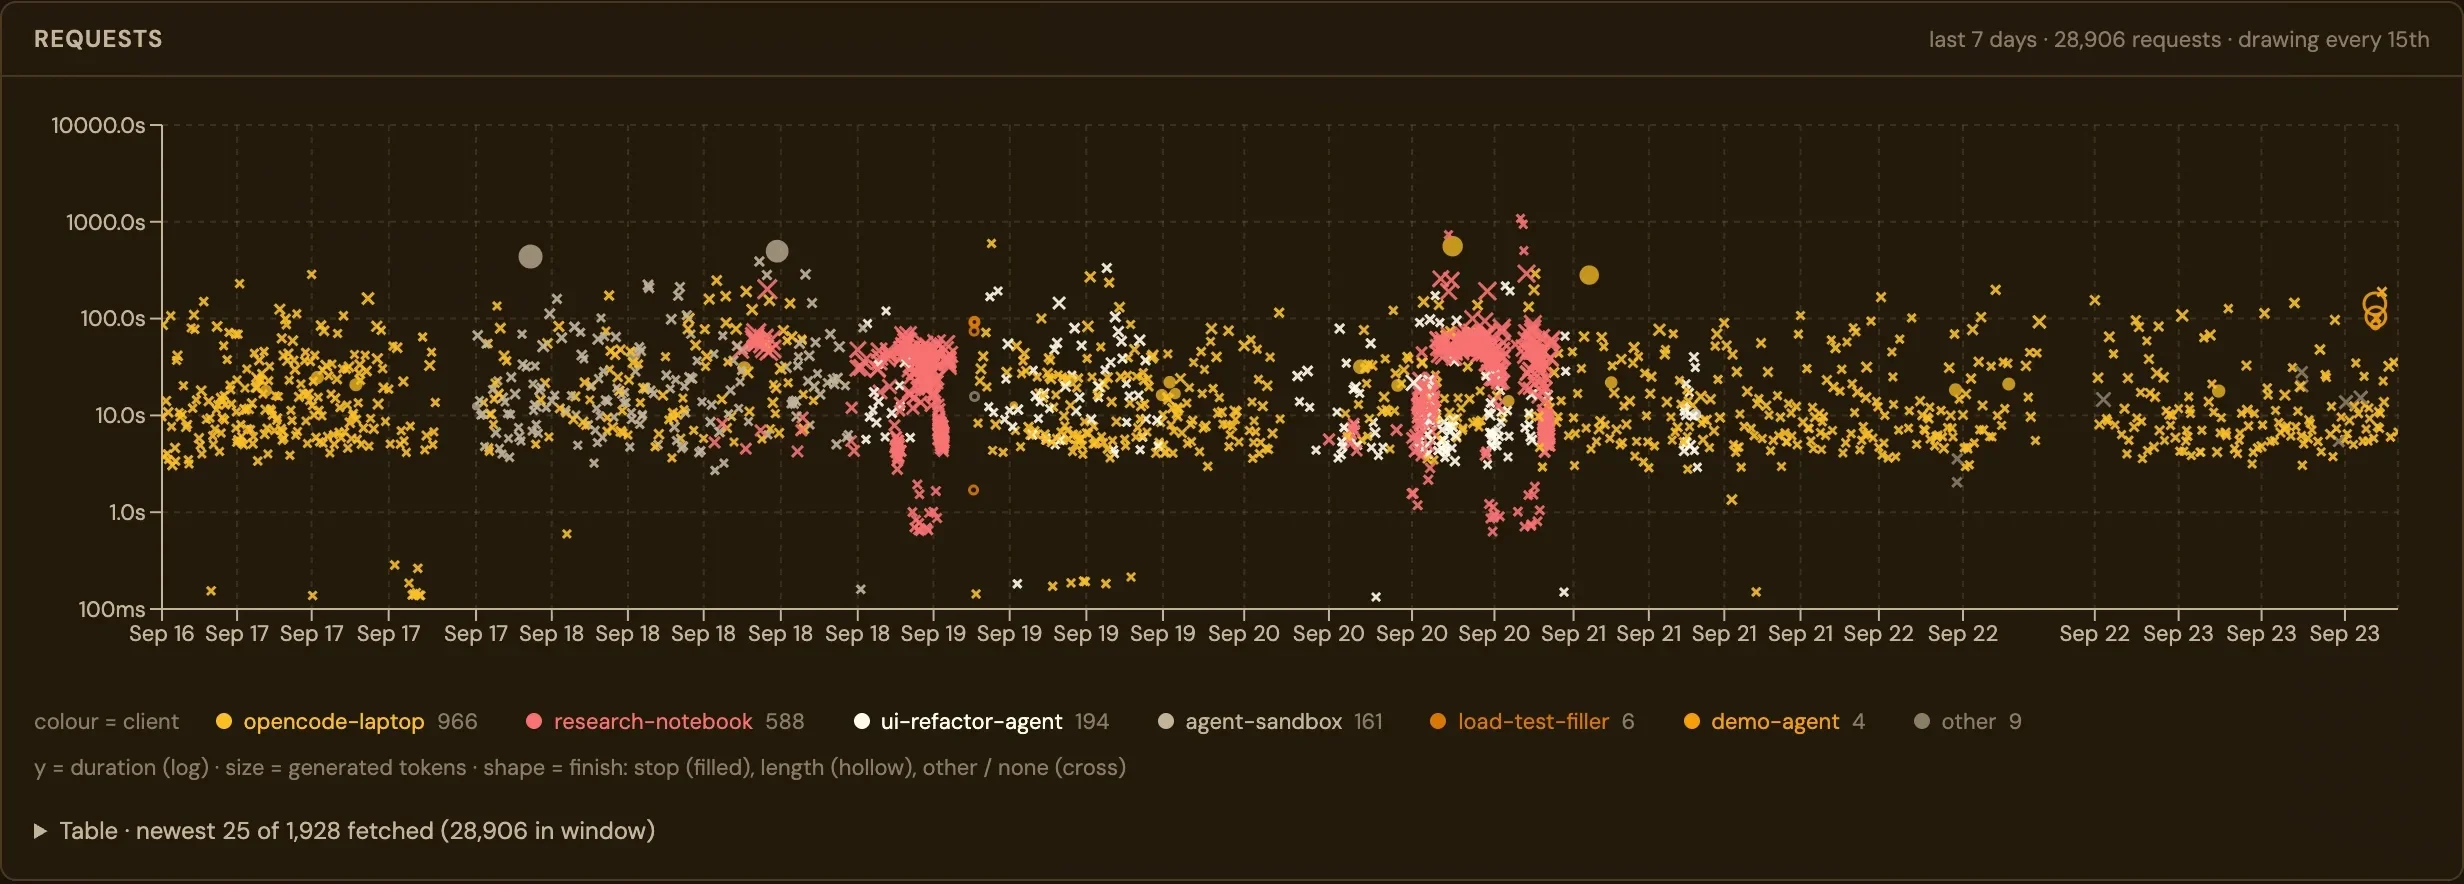
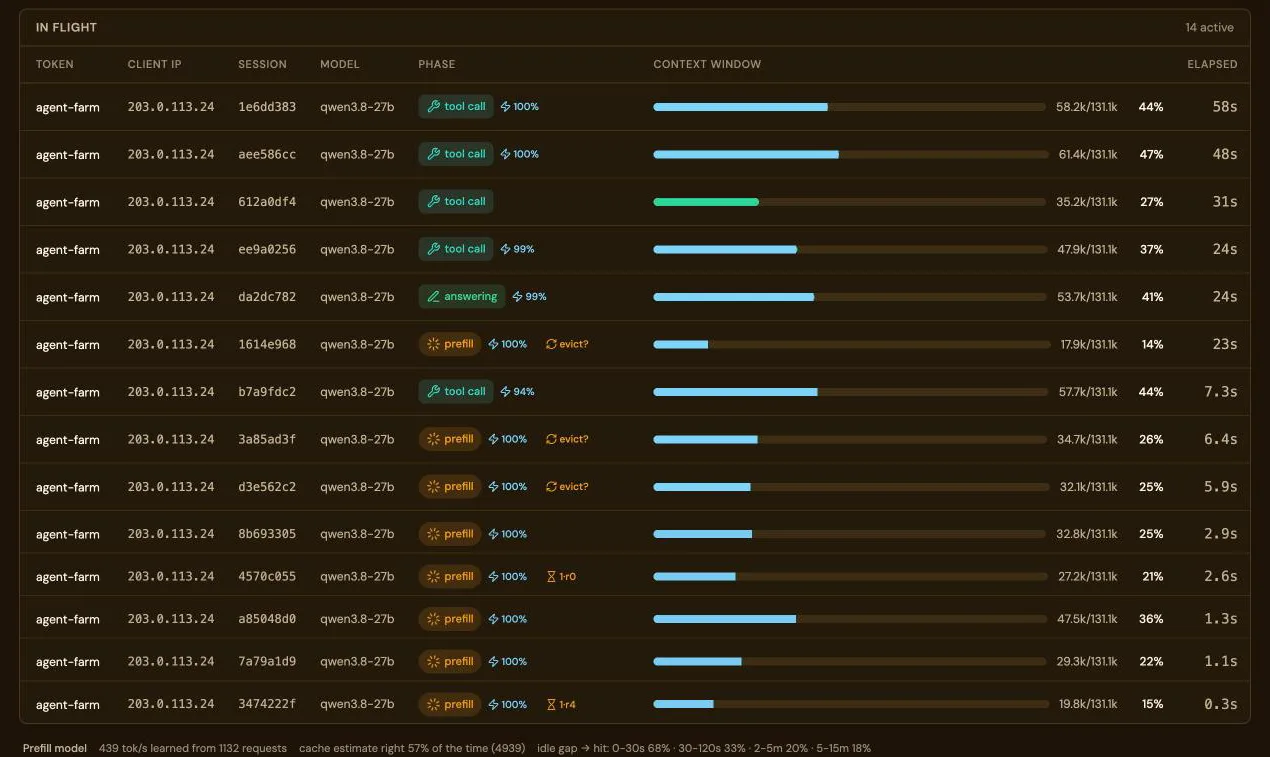
Cada solicitud con su clave, su sesión y su fase: en cola, prefill, pensando, llamada a herramienta, respondiendo. Qué parte de cada prompt salió de la caché de prefijos, medido por solicitud.

La tabla de solicitudes en curso: diez solicitudes activas, cada una con clave, sesión, fase y tokens

Agentes de programación

Claude Code, Codex y OpenCode, conectados desde una sola página.

Connect genera la configuración de cada cliente con la dirección de este warden, una clave y un modelo cargado, comprueba los requisitos con lo que está cargado de verdad y envía una solicitud de prueba.

La página Connect a client con Claude Code seleccionado y los requisitos comprobados

Gratuito, de código abierto y desarrollado en abierto.

LM Warden tiene licencia Apache-2.0 y está en GitHub: el script de instalación y el archivo Compose son todo el despliegue, y puedes leer ambos. Sin cuenta, sin comprobación de licencia y sin telemetría. vLLM, llama.cpp y MLX son proyectos upstream que ejecutamos sin modificar.

mlx-rust-lm próximamente

Una adaptación de mlx-lm de Apple de Python a Rust sobre los bindings oficiales mlx-c de Apple, desarrollada y mantenida por el equipo de LM Warden como proyecto de código abierto independiente. LM Warden la usará como tercer motor en Mac y, con el tiempo, sustituirá al motor mlx-lm de Python, que hoy ocupa la mayor parte de la descarga para Mac. No oficial y sin afiliación con Apple.