LM Warden

Vos propres GPU, accessibles comme une API hébergée.

LM Warden fait tourner vLLM, llama.cpp ou MLX sur votre propre matériel et les place derrière un port unique compatible OpenAI : une clé par application, la consommation suivie clé par clé et un panneau en direct pour chaque GPU. Sur une machine Linux équipée de cartes NVIDIA ou sur un Mac à puce Apple.

Libre, Apache-2.0Sans compte ni télémétrieLinux + NVIDIA · macOS (bêta) · Windows à venir

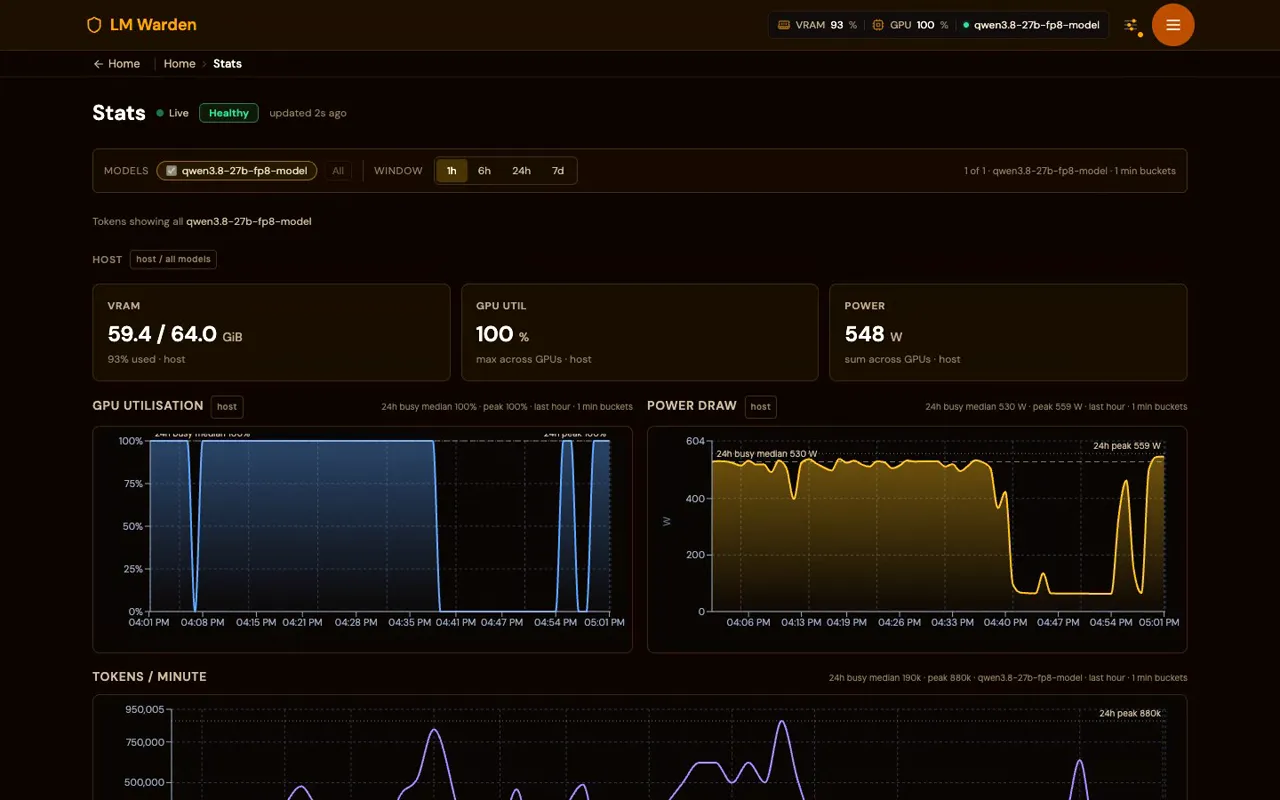
La page Stats d’une instance LM Warden très sollicitée : VRAM 59,4 sur 64 Gio, utilisation du GPU 100 %, puissance 548 W, et des graphiques de l’utilisation du GPU, de la consommation électrique et des jetons par minute sur la dernière heure
  • Linux · NVIDIA vLLM v0.32.0 et llama.cpp b11719 sur CUDA
  • macOS · puce Apple MLX et llama.cpp sur Metal
  • API OpenAI, Anthropic Messages et Responses sur un seul port
  • Agents de codage Claude Code, Codex CLI, OpenCode et 7 autres configurés pour vous

Ce qu’en font les utilisateurs

Où allez-vous l’installer ?

Choisissez une plateforme ci-dessus pour voir ses étapes, ou affichez les quatre.

Une seule commande sur l’hôte GPU.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • Hôte x86_64, Docker Compose v2.24+, le NVIDIA Container Toolkit, une carte Turing ou plus récente.
  • Ouvrez ensuite http://HOST:8080/ui/, terminez l’assistant de premier démarrage, ajoutez un modèle, créez une clé. Votre point de terminaison est http://HOST:8080/v1.
  • Plusieurs GPU dans une machine : parallélisme de tenseurs, ou un réplica par carte avec routage selon le cache.
  • NVIDIA aujourd’hui. La prise en charge des GPU AMD ROCm et Intel arrive bientôt ; pas encore de date. Dites-nous lesquels vous utiliseriez : Radeon · Intel.
  • Installation · Hors ligne / air gap · Depuis les sources · Mise à jour
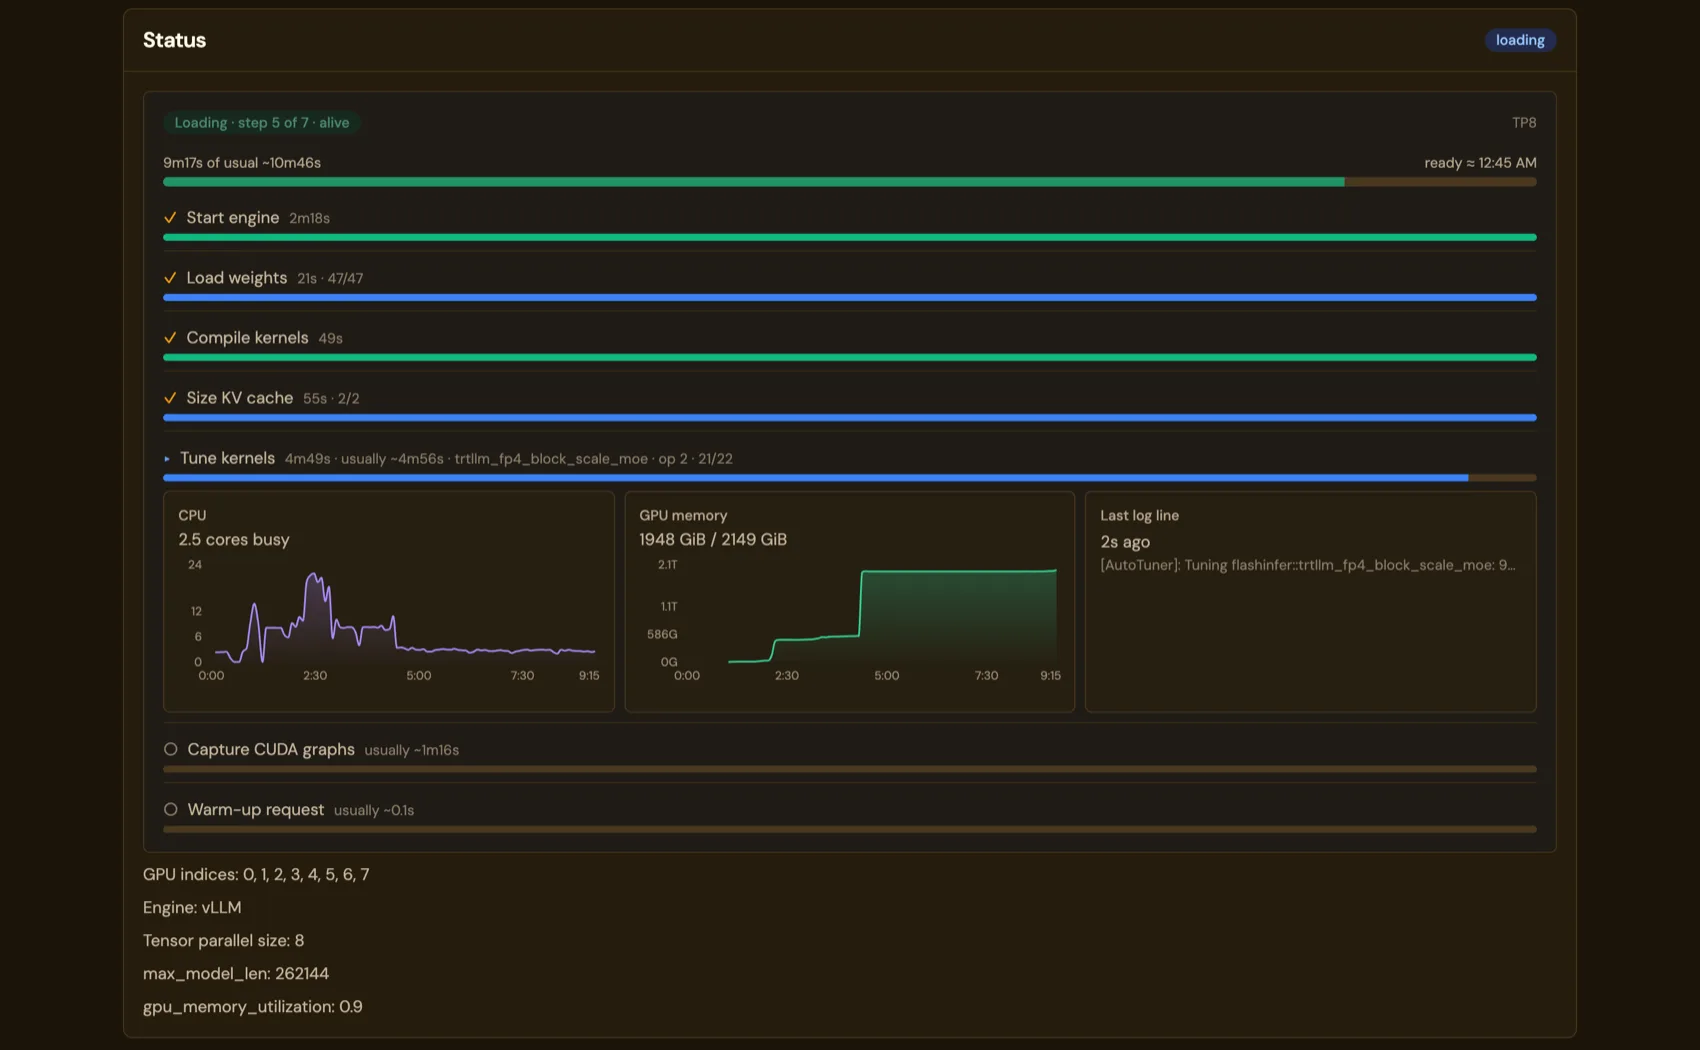
Un chargement de modèle en cours sur la page Models, chaque étape avec son temps écoulé et sa durée habituelle
Un modèle en cours de chargement après l’installation : pour chaque étape, la durée habituelle relevée lors des chargements précédents.

Une app pour la barre des menus, en bêta.

Télécharger pour Mac (bêta)

  • Environ 110 Mo. Mac à puce Apple (M1 ou plus récent), macOS 14 ou version ultérieure. SHA-256 · notes de version.
  • Moteurs : MLX et llama.cpp compilés avec Metal. Le même tableau de bord et la même API OpenAI ; ni vLLM, ni mesure de la consommation électrique.
  • Une bêta, sans détour : signée ad hoc et non notarisée ; au premier lancement, macOS vous demande donc de l’autoriser dans Confidentialité et sécurité, et chaque mise à jour passe par un nouveau téléchargement. Étapes du premier lancement.
  • Accessible uniquement à l’adresse 127.0.0.1 tant que vous n’avez pas activé Share on Local Network.
  • Bientôt disponible : mlx-rust-lm, un troisième moteur. L’équipe LM Warden porte mlx-lm d’Apple de Python vers Rust, sur les liaisons officielles mlx-c d’Apple ; il viendra s’ajouter à MLX et llama.cpp et remplacera à terme le moteur Python mlx-lm, qui, avec Python et ses bibliothèques, représente l’essentiel du téléchargement actuel. Projet non officiel, sans lien avec Apple.
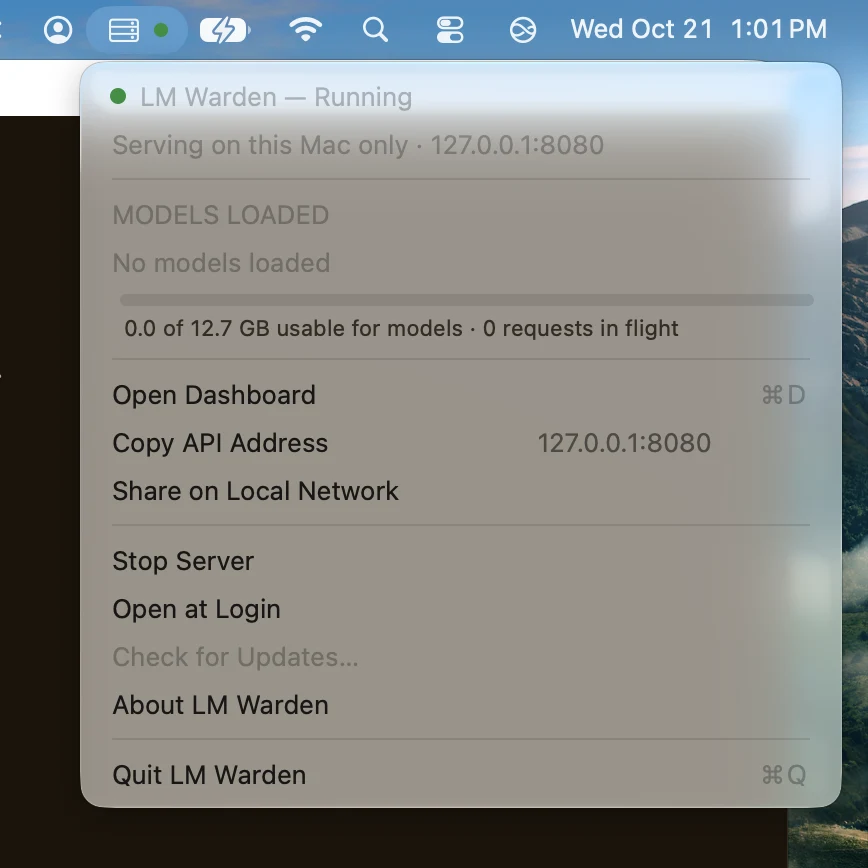
Le menu de LM Warden dans la barre des menus d’un Mac : Running, servi uniquement sur ce Mac à 127.0.0.1:8080, aucun modèle chargé, une barre de mémoire, Open Dashboard, Copy API Address, Share on Local Network
Le menu de la bêta dans la barre des menus, sur un M1 de 16 Go.

Windows sera la prochaine plateforme. Pas encore de date.

Nous y travaillons et publierons ici une build dès qu’elle existera, plutôt qu’un formulaire d’inscription en attendant. D’ici là, deux solutions réalistes :

  • Faites tourner LM Warden sur une machine GPU sous Linux et utilisez-le depuis Windows : tous les clients OpenAI, Claude Code et Codex s’y connectent par le réseau.
  • Suivez les versions sur GitHub pour être informé de la première build Windows.
  • Les GPU AMD Radeon et Intel suivront ; dites-nous lesquels vous utiliseriez : Radeon · Intel.

Le boîtier : bientôt disponible, pas encore de date.

Une quatrième façon de faire tourner LM Warden, sur une machine dédiée à cette seule tâche.

  • Vous insérez une clé USB dans un châssis équipé de GPU. Elle installe un Linux minimal qui ne fait qu’une chose : exécuter LM Warden.
  • Il configure pour vous le réseau et le stockage des modèles.
  • Les mises à jour arrivent par le réseau, ou le boîtier fonctionne en isolement complet (air gap).
  • Conçu pour un serveur LLM dédié et sécurisé : une équipe qui veut une machine verrouillée, ou un site sans aucune connexion vers l’extérieur.

En attendant sa sortie, l’installation Linux ci-dessus fait le même travail sur un hôte que vous configurez vous-même, y compris l’installation hors ligne / isolée du réseau. Suivez les versions sur GitHub.

Pas encore d’image : il n’y a ni nom de produit ni matériel à montrer, et nous n’en inventerons pas.

Vous l’utilisez déjà ? Sous Linux, la mise à jour se fait sur place : récupérez les nouvelles images, redémarrez, et la base de données est migrée automatiquement. Étapes · Journal des modifications.

L’auto-hébergement pose huit problèmes. Voici, pour chacun, à quoi ressemble la solution.

Un moteur d’inférence, à lui seul, sert un modèle sur un port. Voici les briques qui l’entourent, avec nos propres chiffres quand nous en avons.

  1. Ce modèle tiendra-t-il sur mon GPU ?

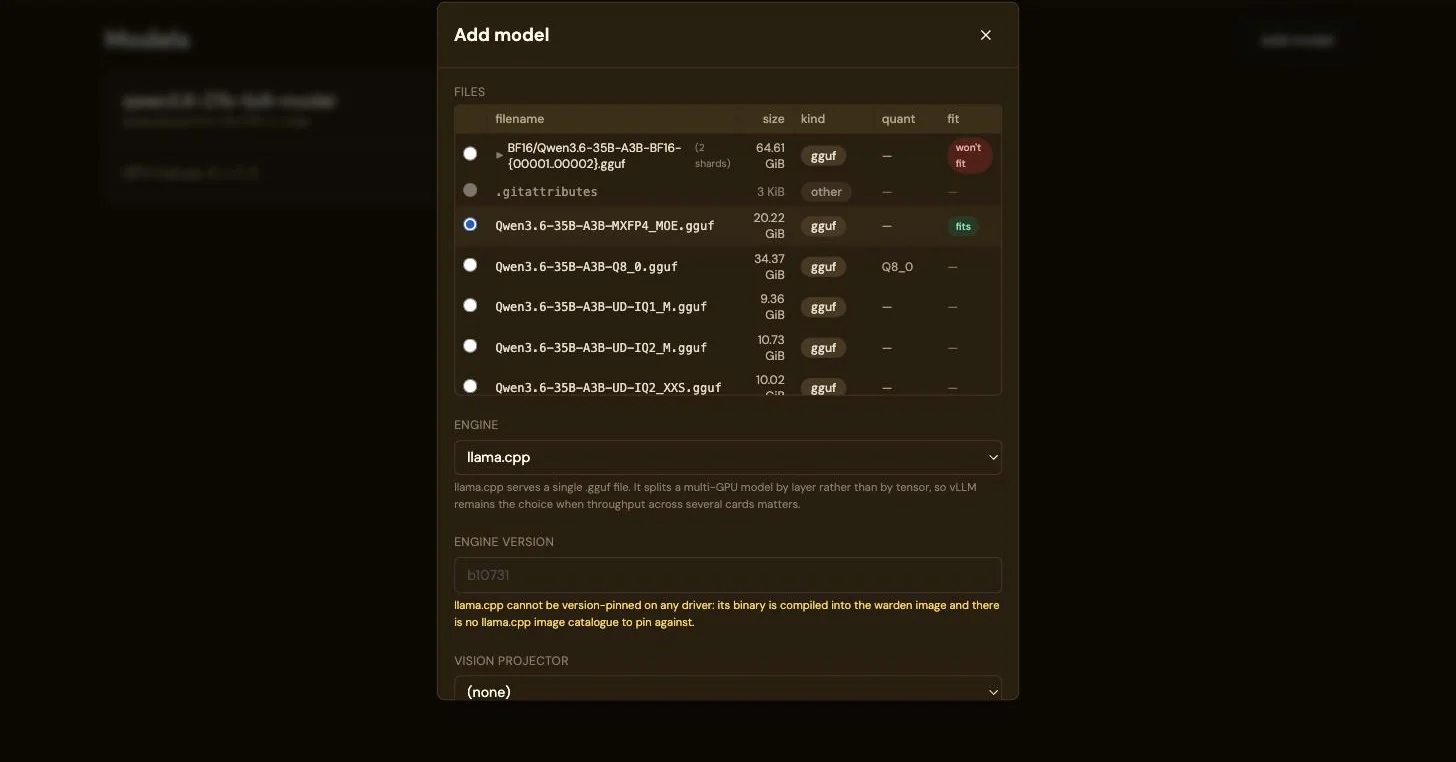
    Collez l’adresse d’un dépôt Hugging Face dans Add model. Chaque fichier est listé avec un verdict selon les cartes que vous cochez : tient, marge serrée ou ne tient pas. Cochez d’autres cartes et leur mémoire s’additionne. Rien n’est téléchargé tant qu’aucun fichier ne tient.

    Le même fichier de 20,22 Gio, signalé comme tenant en mémoire une fois quatre GPU sélectionnés
  2. Vous avez acheté des GPU. Travaillent-ils ou attendent-ils ?

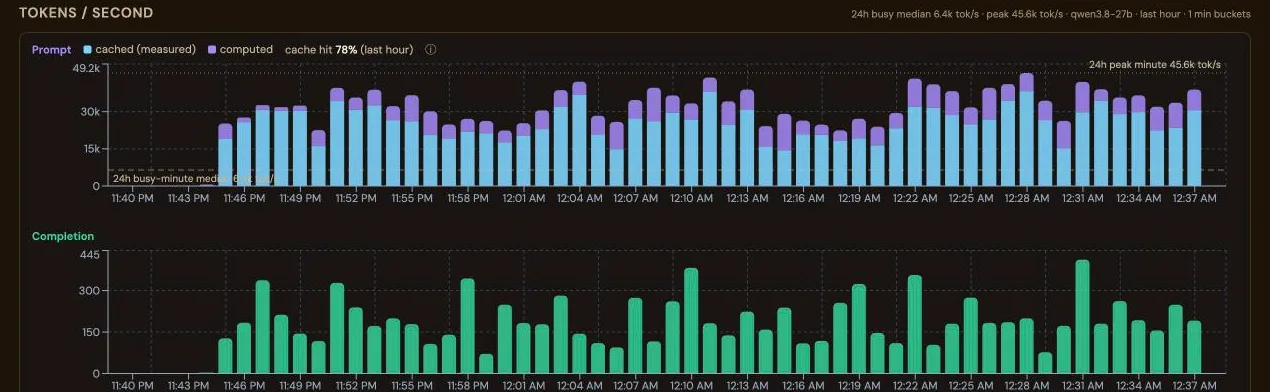
    Le débit, c’est concurrence × longueur du prompt × réutilisation du cache, et un moteur seul ne montre jamais tout cela ensemble. La page Stats, si, sur 1 h à 7 jours : VRAM, utilisation du GPU, puissance (Linux), jetons par seconde avec les jetons de prompt répartis entre lus dans le cache et calculés, latence p50/p95, taux de succès du cache de prompts, préemptions, requêtes par clé et par IP client. Une utilisation qui stagne alors que des requêtes attendent : augmentez la concurrence. Une faible part servie par le cache : fixez les sessions sur leur réplica.
    Jetons par seconde : jetons de prompt répartis entre lus dans le cache et calculés, jetons de complétion en dessous
  3. Essayez le modèle avant de brancher quoi que ce soit.

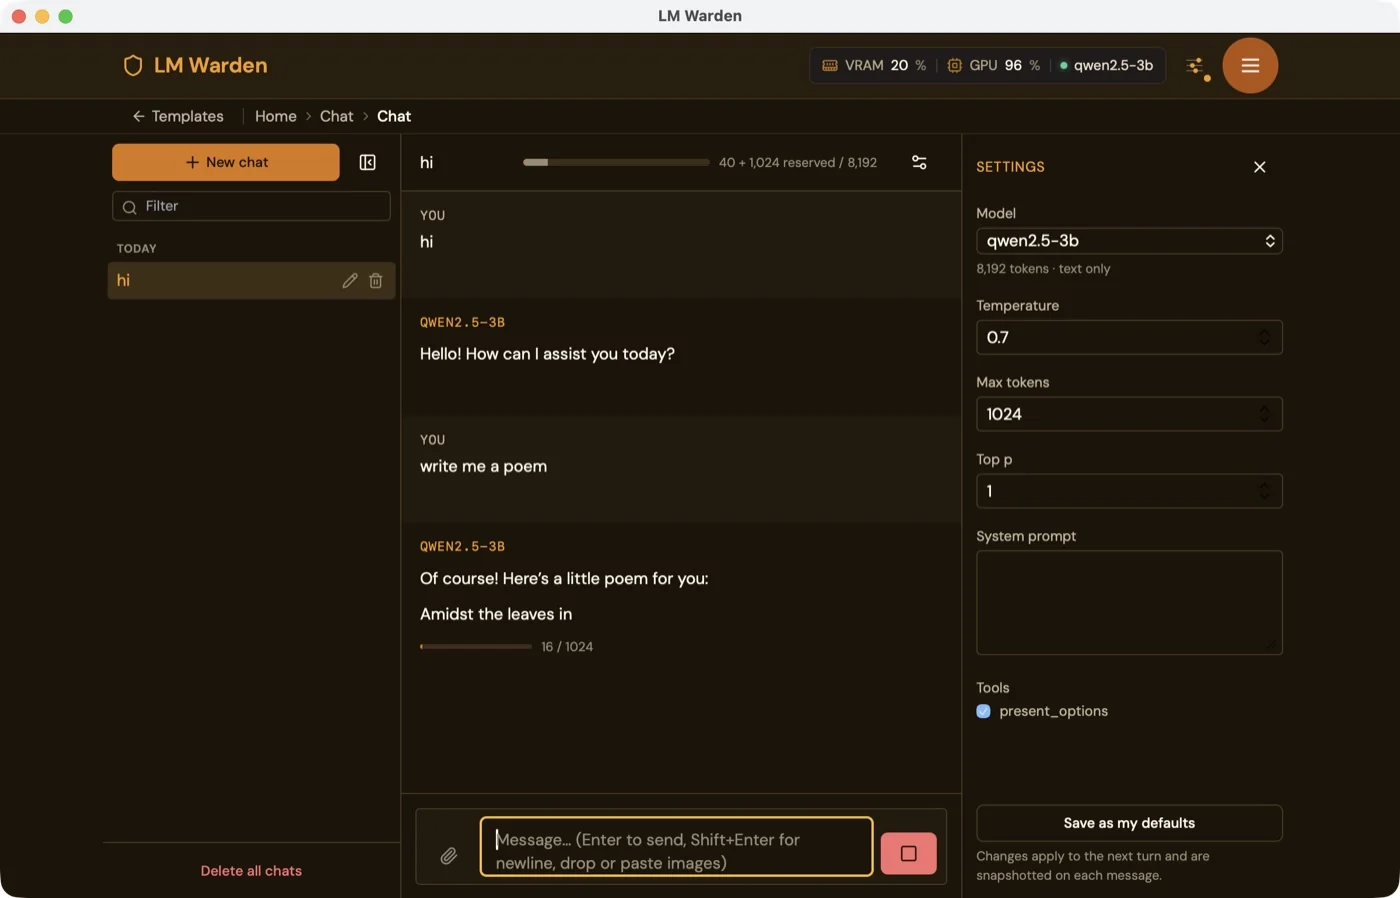
    Le chat se trouve dans la même fenêtre que tout le reste. Rendu Markdown en continu, avec coloration du code et formules mathématiques ; jusqu’à huit images PNG, JPEG ou WebP par message pour un modèle de vision ; température, top-p, nombre maximal de jetons et prompt système réglables par conversation et enregistrés comme valeurs par défaut ; conversations conservées, titrées et duplicables. Les appels d’outils du modèle sont affichés : vous vérifiez qu’ils fonctionnent avant qu’un agent en dépende.

    Le chat dans la fenêtre du tableau de bord de l’app Mac, en streaming depuis qwen2.5-3b avec GPU 96 % dans l’en-tête
  4. Qu’a vraiment reçu le modèle, et qu’a-t-il répondu ?

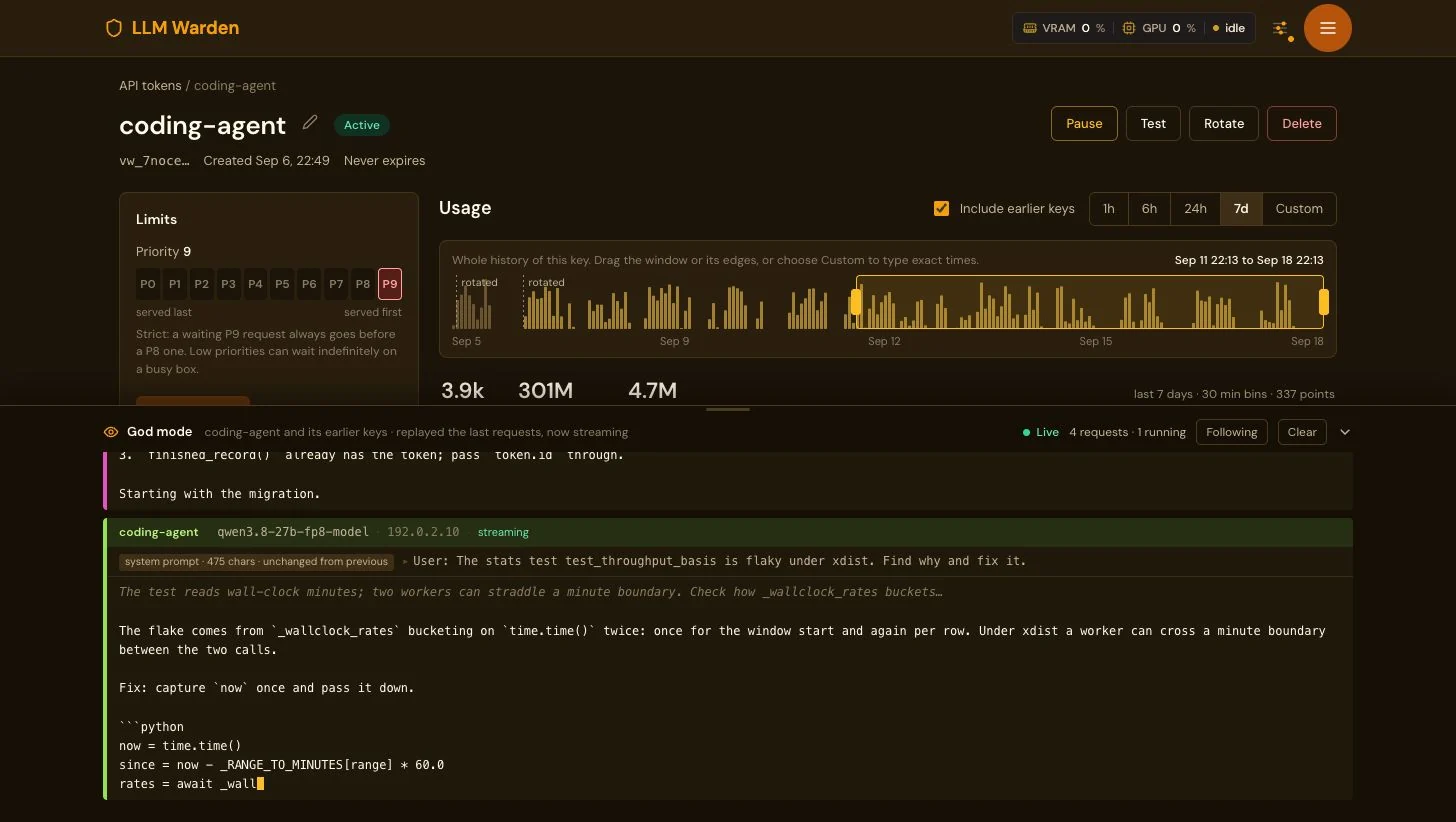
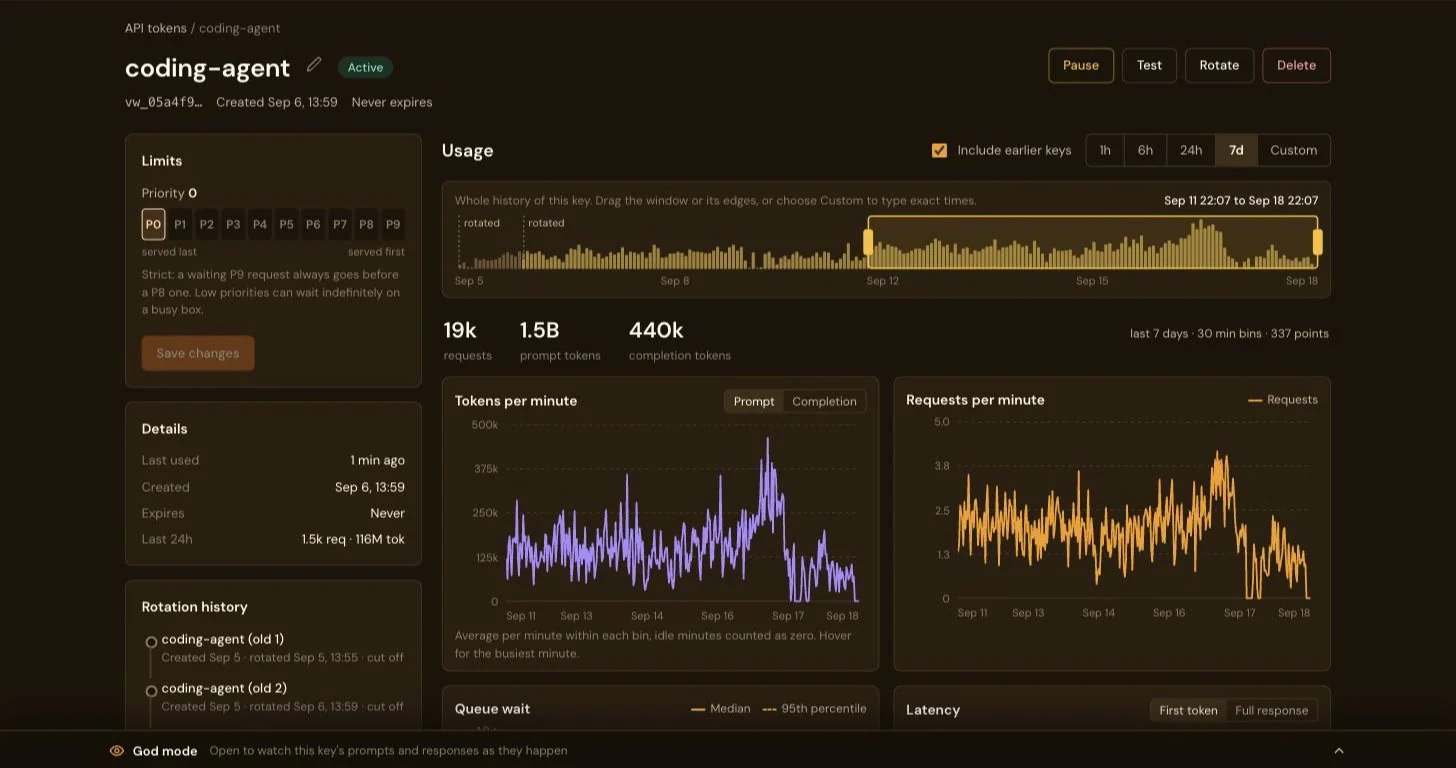
    God mode, pour déboguer les prompts : quand VW_GODMODE_ENABLED est activé sur le déploiement, la page de chaque clé gagne un panneau qui affiche en direct les prompts et les complétions de cette clé. Désactivé par défaut, et invisible tant qu’il l’est. Un tampon circulaire borné, en mémoire : rien n’est écrit en base de données ni sur disque, tout disparaît au redémarrage. Toute personne disposant de la session admin peut l’ouvrir ; le warden ne connaît qu’un seul rôle, celui d’administrateur.

    La page de la clé API coding-agent avec le panneau God mode ouvert en bas : Live, 4 requests, 1 running ; une requête qwen3.8-27b-fp8 venant de 192.0.2.10 en cours de streaming, qui montre le prompt de l’utilisateur sur un test de statistiques instable et la réponse du modèle, un correctif Python, au fur et à mesure de sa génération

À chaque tour d’un agent, toute la conversation est relue.

Un agent renvoie tout son historique à chaque tour, si bien qu’une longue conversation se compose surtout d’un préfixe que le moteur a déjà lu. vLLM conserve ce travail dans son cache de préfixes, mais seulement sur le réplica qui l’a effectué, et son propre répartiteur de charge envoie chaque tour au réplica dont la file d’attente est la plus courte. LM Warden place chaque nouvelle conversation sur le réplica le moins chargé et l’y maintient, grâce à l’identifiant de session que Claude Code envoie déjà. Il ne déplace une requête que lorsque ce réplica dépasse son seuil de débordement.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Quatre tours d’une conversation sur un modèle à quatre réplicas. Avec le répartiteur de vLLM, chaque tour repasse par le prefill (le moteur lit le prompt et remplit son cache) presque depuis zéro, sur le réplica qui l’a reçu. Avec LM Warden, la conversation reste sur le réplica 2 et seul le nouveau tour passe par le prefill. Un schéma du mécanisme, pas une mesure.

Mesuré sur notre machine à quatre cartes (4 × RTX A4000, Qwen3-4B en quatre réplicas d’une carte chacun, sessions synthétiques du type Claude Code, affinité désactivée puis activée, en deux séries consécutives) : avec les conversations fixées sur leur réplica, la part des jetons de prompt servis par le cache est passée de 56 à 86 % à 4 sessions simultanées, et le délai médian avant le premier octet est tombé de 2,05 à 0,38 s. Le nombre de jetons de sortie par minute était plus élevé à chaque palier testé, et le délai p95 avant le premier octet (les 5 % les plus lents) plus bas à chaque palier. Le nombre de réplicas réellement actifs a à peine bougé (2,71 contre 2,83 sur quatre à 4 sessions) : le gain vient de la réutilisation du cache, non d’un plus grand nombre de cartes sollicitées.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Taux de succès du cache de préfixes à chaque palier : jetons de prompt servis par le cache rapportés aux jetons de prompt demandés, les quatre réplicas cumulés, d’après la variation des propres compteurs de vLLM sur le palier. Le gain se maintient tant qu’il reste de la marge et disparaît à 32 sessions, quand les conversations débordent vers d’autres réplicas.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Délai avant le premier octet de 4 à 32 sessions simultanées, médiane et p95, sur une échelle logarithmique pour que les paliers inférieurs à la seconde restent lisibles à côté de ceux qui atteignent la minute. Avec l’affinité, la médiane est bien plus basse jusqu’à 16 sessions (0,38 contre 2,05 s à 4) et plus haute à 24 et 32 ; le p95 est plus bas à chaque palier, même si à 16 l’écart (24,9 contre 26,2 s) reste dans le bruit d’une seule exécution par série. Mesuré côté client, via Internet, jusqu’au premier jeton reçu en streaming.

Chaque palier de la montée en charge, affinité désactivée → activée

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Mesuré sur notre machine à quatre cartes avec un petit modèle, affinité d’abord désactivée puis activée, sans redémarrer vLLM entre les deux : la seconde série a démarré avec un cache de préfixes déjà chaud, et les deux ont tiré leurs prompts de la même graine. Chaque palier ne dure que 3 minutes, si bien qu’il ne termine que 9 à 31 sessions et qu’une session de plus ou de moins fait varier de 20 le nombre de sessions par heure ; la colonne la plus stable est celle des jetons de sortie par minute. Votre modèle, vos cartes et votre charge de travail seront différents ; le panneau des réplicas, sur la page d’un modèle, affiche les mêmes compteurs pour les vôtres.

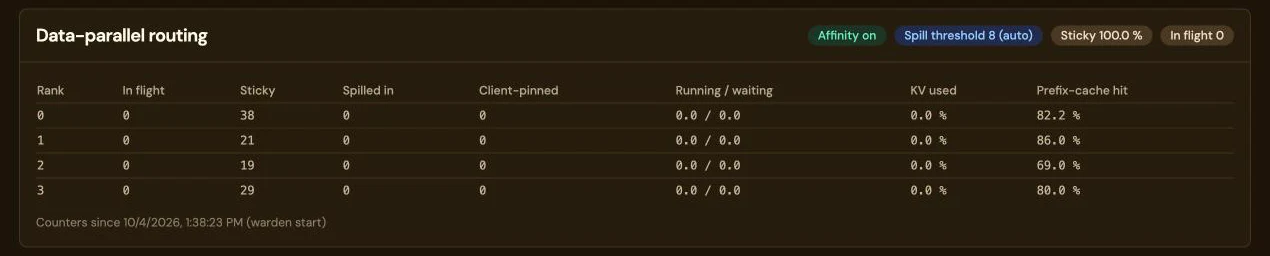
Le panneau Data-parallel routing sur la page d’un modèle, avec les badges Affinity on, Spill threshold 8 (auto), Sticky 100.0% et In flight 0. Un tableau liste les réplicas 0 à 3 avec in flight, sticky (38, 21, 19 et 29), spilled in, client-pinned, running et waiting, le KV utilisé et le taux de succès du cache de préfixes (82,2 ; 86,0 ; 69,0 et 80,0 %), et une ligne indiquant que les compteurs comptent depuis le démarrage du warden.
Les mêmes compteurs sur la page d’un modèle : une ligne par réplica avec les requêtes qu’il détient, le nombre de conversations restées sur place (sticky) ou arrivées par débordement, ce qui s’exécute et ce qui attend, le cache KV utilisé et le taux de succès du cache de préfixes. Relevé le 4 octobre 2026 avec l’affinité activée et le seuil de débordement à 8 (auto) : sticky 100 %, et un taux de succès du cache de préfixes de 82,2 ; 86,0 ; 69,0 et 80,0 % sur les réplicas 0 à 3. C’est une capture du panneau, pas un résultat de mesure. Touchez l’image pour l’agrandir.

Ses limites. Les paliers à 24 et 32 sessions sont une surcharge délibérée de quatre petites cartes, et chaque réplica est saturé. Le débit de sortie reste plus élevé (11 178 contre 9 048 et 16 638 contre 14 760 jetons par minute) et les requêtes les plus lentes attendent bien moins (p95 38 contre 59 s, et 39 contre 83 s), mais le délai médian avant le premier octet est moins bon avec l’affinité : 13,1 contre 5,1 s à 24 sessions, 27,7 contre 12,3 s à 32. Nous n’en avons pas isolé la cause, et abaisser le seuil de débordement de 8 à 4 n’a rien changé.

Sur une machine chargée, mesurez les deux. L’avantage est maximal tant qu’il reste de la marge ; sur une machine qui tourne à sa limite, mesurez les deux réglages, sachant que l’affinité peut être désactivée modèle par modèle. Les réplicas, et donc ce routage, font partie de l’installation Linux avec GPU NVIDIA ; l’app Mac (bêta) n’offre ni parallélisme de tenseurs ni parallélisme de données.

La méthode complète : la charge de travail, le banc de test, le seuil de débordement, et une machine à sept GPU qui fonctionne ainsi depuis →

Branchez votre agent de codage sur vos propres GPU.

Dix agents de codage se connectent avec une URL de base et une clé ; deux d’entre eux peuvent en plus continuer à s’appuyer sur un abonnement Claude payant pour les tâches difficiles.

Gardez votre abonnement Claude, confiez les appels de routine à vos GPU

Claude Code et l’Anthropic SDK, via le routeur. Une règle désigne les modèles Claude que vos GPU remplacent ; tout le reste part chez Anthropic avec vos propres identifiants ou votre clé API.

Où va une requête Claude Code L’agent envoie chaque requête au routeur de LM Warden. Les requêtes destinées aux modèles claude-haiku sont envoyées à un modèle sur votre GPU, qui répond sous le nom du modèle demandé. Tous les autres modèles, Opus compris, sont transmis à Anthropic avec vos propres identifiants. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Où va une requête Claude Code L’agent envoie chaque requête au routeur de LM Warden. Les requêtes destinées aux modèles claude-haiku sont envoyées à un modèle sur votre GPU, qui répond sous le nom du modèle demandé. Tous les autres modèles, Opus compris, sont transmis à Anthropic avec vos propres identifiants. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
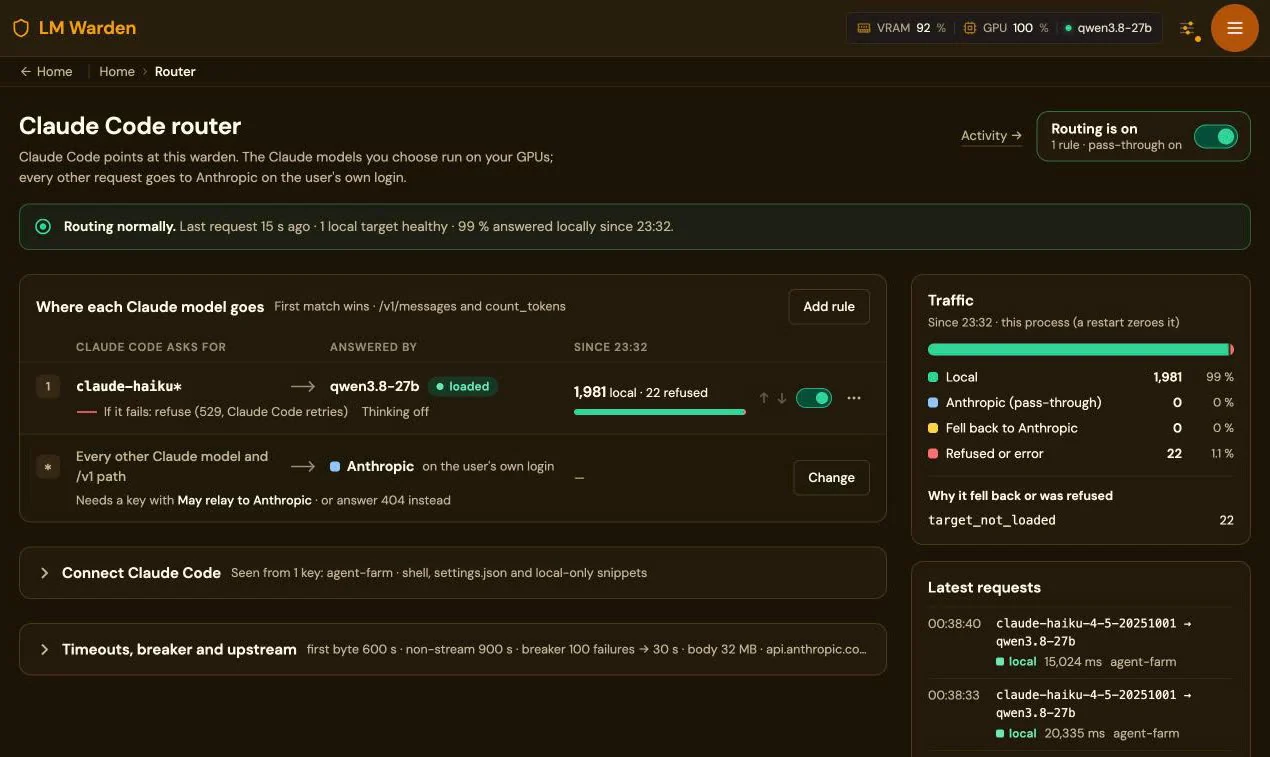
1 981requêtes traitées localement, soit 99 % du trafic Claude Code de la machine depuis son redémarrage. Relevé sur la page Router de notre machine à sept GPU le 21 octobre 2026 ; 22 requêtes refusées tant que le modèle cible n’était pas chargé.
La page du routeur Claude Code : routage activé, 99 % des requêtes traitées localement depuis 23 h 32 ; la règle 1 envoie claude-haiku* vers qwen3.8-27b, 1 981 en local et 22 refusées ; tous les autres modèles Claude partent chez Anthropic avec les identifiants de l’utilisateur
Claude Code 2.1.227 ou version ultérieure : ANTHROPIC_BASE_URL pointant vers le warden, la clé du warden dans ANTHROPIC_CUSTOM_HEADERS, vos identifiants inchangés. Nous n’avons pas évalué la qualité des réponses : confiez au modèle local les tâches routinières et bien définies.

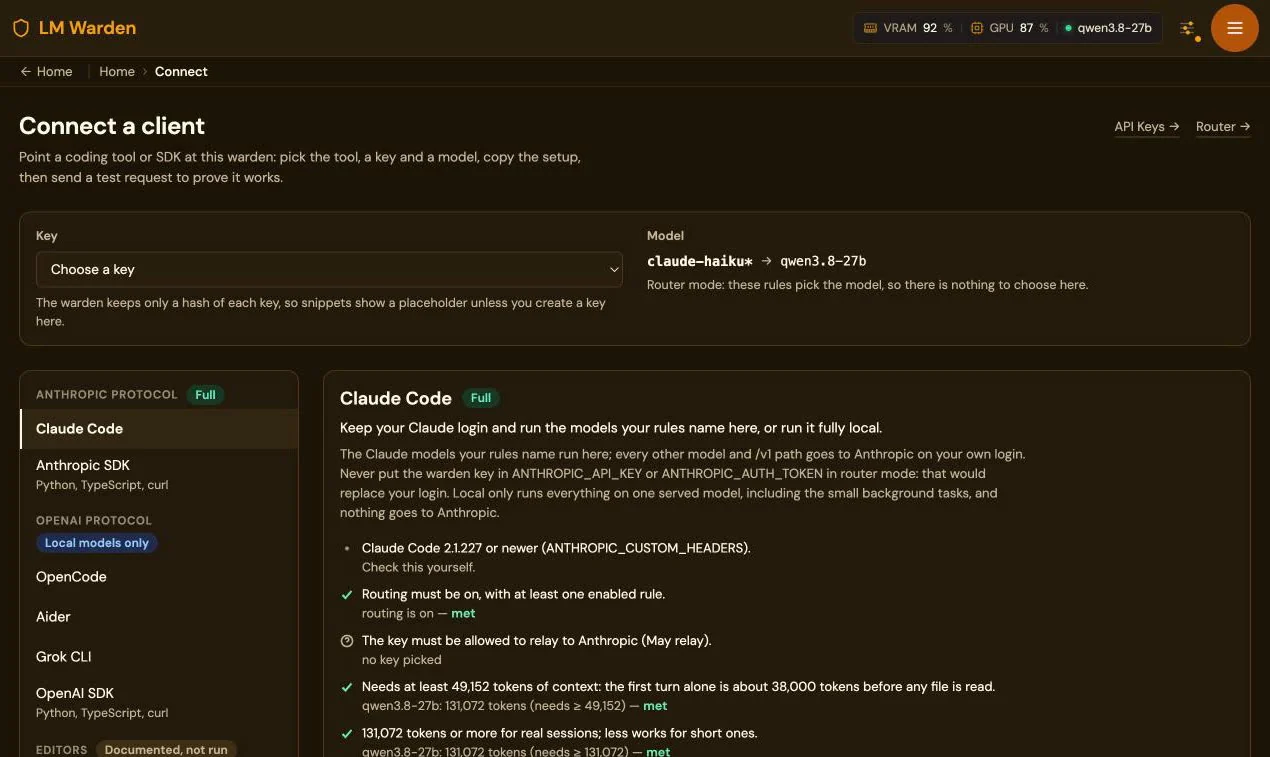
Connect génère la configuration de chaque client et envoie une requête de test.

Choisissez le client, une clé et un modèle chargé dans la console ; elle vérifie chaque prérequis par rapport à ce qui est réellement chargé (fenêtre de contexte, appel d’outils, routeur activé) et vous fournit les fichiers à coller. Tous les agents de codage : une page par client, avec ce qui fonctionne et ce que nous avons constaté.

La page Connect a client : un sélecteur de clé, la règle de routeur claude-haiku* vers qwen3.8-27b, les clients groupés par protocole, et le panneau Claude Code avec ses prérequis vérifiés

Confiez le réglage de vos GPU à l’IA que vous payez déjà.

Choisir un modèle pour vos cartes, c’est choisir une quantification, un moteur, la répartition entre les GPU, la taille du contexte et le type de cache KV ; chaque essai coûte un téléchargement et un chargement. Tout ce que fait la console passe par un appel d’API : Claude Code, Codex ou tout autre agent disposant d’un shell peut donc mener cette recherche pour vous, sur votre matériel et avec votre charge de travail.

La boucle

La boucle de réglage Inventorier les GPU, présélectionner les modèles grâce à l’aperçu de capacité avant tout téléchargement, charger les répartitions candidates, les mesurer avec de vraies requêtes, ajuster les réglages et garder la meilleure configuration chargée. Mesure et ajustement se répètent jusqu’à ce que l’agent soit satisfait. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner La boucle de réglage Inventorier les GPU, présélectionner les modèles grâce à l’aperçu de capacité avant tout téléchargement, charger les répartitions candidates, les mesurer avec de vraies requêtes, ajuster les réglages et garder la meilleure configuration chargée. Mesure et ajustement se répètent jusqu’à ce que l’agent soit satisfait. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

Ce que l’agent appelle : GET /api/system/gpus, POST /api/models/fit-preview avant tout téléchargement, l’enregistrement et suggest-config, le téléchargement et le chargement, un test de charge qui détermine puis applique le plafond de contexte réel, GET /api/stats/v2/throughput et latency, et une clé d’inférence qu’il crée lui-même pour envoyer du trafic de test. Il lit d’abord /agent-guide.md, une courte description de ces appels rédigée pour un modèle de langage.

Un chargement de modèle en cours sur la page Models : chaque étape avec son temps écoulé et sa durée habituelle
Ce que l’agent surveille pendant le chargement d’une répartition : chaque étape avec la durée habituelle relevée lors des chargements précédents. Un chargement qui ne progresse plus est interrompu et ses GPU libérés.

Quatre prompts à coller, et ce que vous obtenez

  1. Inventaire et présélection. À demander : liste mes GPU, présélectionne trois modèles à poids ouverts pour le codage agentique qui tiennent en mémoire avec au moins 65 536 jetons de contexte, vérifie chacun avec fit-preview, ne télécharge rien. Vous obtenez : un tableau avec modèle, quantification, moteur, GPU, contexte et justification.
  2. Moteur et répartition pour un modèle. À demander : choisis entre vLLM et llama.cpp, et entre parallélisme de tenseurs et réplicas en parallélisme de données sur mes cartes ; charge les deux meilleures répartitions, envoie à chacune les mêmes 20 requêtes en streaming, compare-les avec une concurrence de 1 puis de 8. Vous obtenez : le délai avant le premier jeton et les jetons par seconde pour les deux, la meilleure laissée chargée, l’autre déchargée, la clé de test révoquée.
  3. Trouver les vraies limites et les appliquer. À demander : lance un test de charge sur le modèle chargé, applique le contexte mesuré, puis mesure avec une concurrence de 1, 4 et 16 et des prompts d’environ 2 k et 30 k jetons. Vous obtenez : le plafond de contexte inscrit dans les réglages du modèle et un tableau du délai avant le premier jeton et des jetons par seconde, par niveau de concurrence et taille de prompt.
  4. Comparer deux candidats sur votre propre travail. À demander : rejoue les prompts de ./workload/*.txt sur le modèle A et le modèle B avec une concurrence de 4, évalue chaque réponse. Vous obtenez : model-comparison.md avec latence, jetons par seconde, exactitude selon le jugement de l’agent et une recommandation ; le modèle recommandé reste chargé.

Avant de commencer. Un jeton admin a tous les droits d’administration sur le warden (modèles, clés, réglages ; il n’existe pas encore de portées plus restreintes) : donnez-lui une durée de validité courte et révoquez-le dans Settings → Access Tokens une fois le travail terminé. Un test de charge fait volontairement planter un moteur pour trouver sa limite : exécutez ces prompts sur un warden dont personne d’autre ne dépend. Les téléchargements sont volumineux ; les prompts vérifient que le modèle tient en mémoire avant de le télécharger, mais surveillez votre disque.

Les choix de moteur et de répartition (vLLM, parallélisme de tenseurs ou de données) concernent l’installation Linux ; sur un Mac, le choix se limite à MLX ou llama.cpp sur un seul GPU. Le modèle qui effectue le réglage peut être celui que vous payez déjà ; le modèle réglé est celui qui tourne sur vos cartes. La page Réglage par un agent : les quatre prompts en entier.

Une machine GPU partagée entre toute votre équipe, votre famille et vos agents.

Créez autant de clés API que nécessaire et distribuez-les : un collègue, un membre de la famille, une tâche de CI, une ferme d’agents, chacun avec sa propre clé, sa propre priorité et sa propre page de consommation. Le matériel travaille pour tout le monde, et le travail important n’attend jamais.

Votre matériel tel qu’il est : d’un Mac à huit B300.

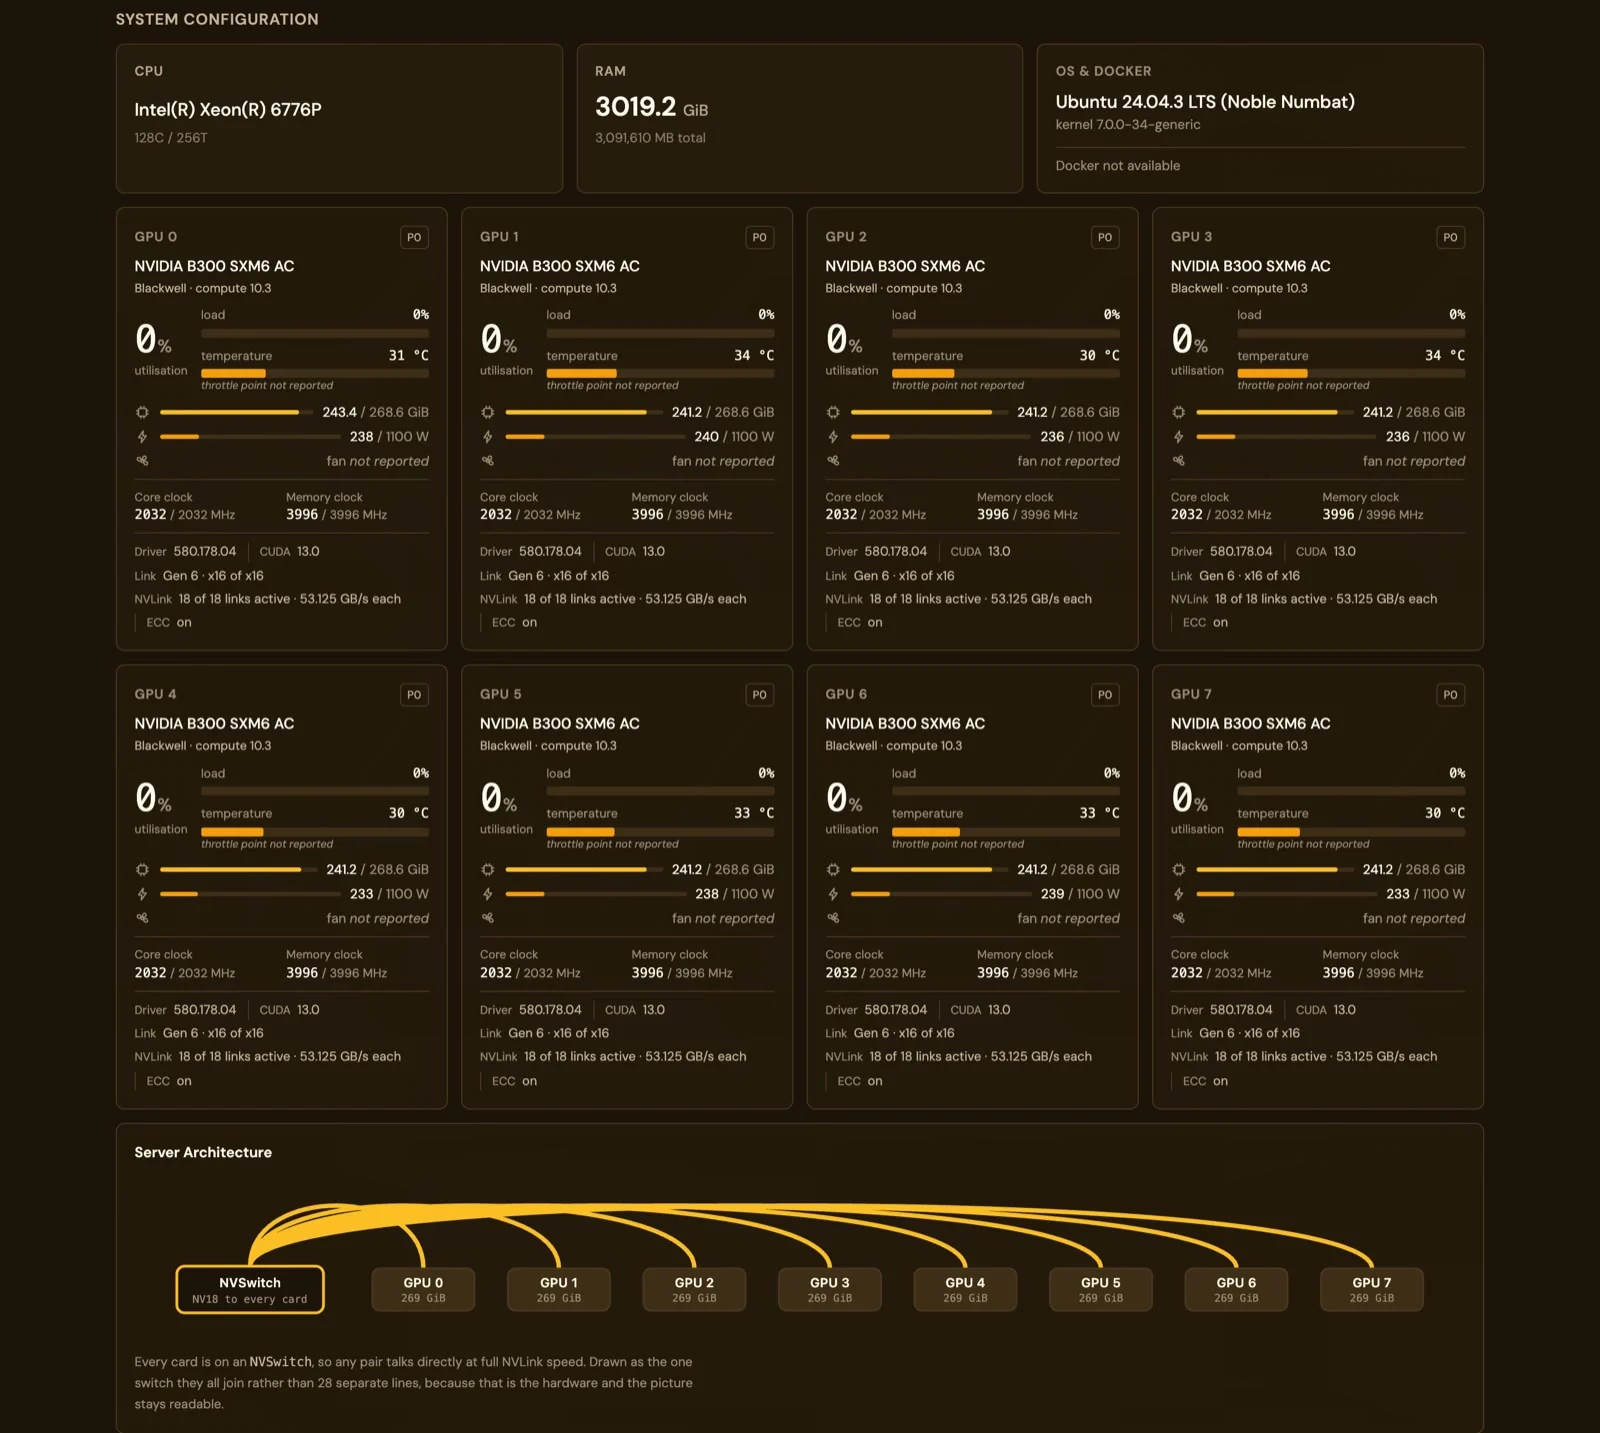
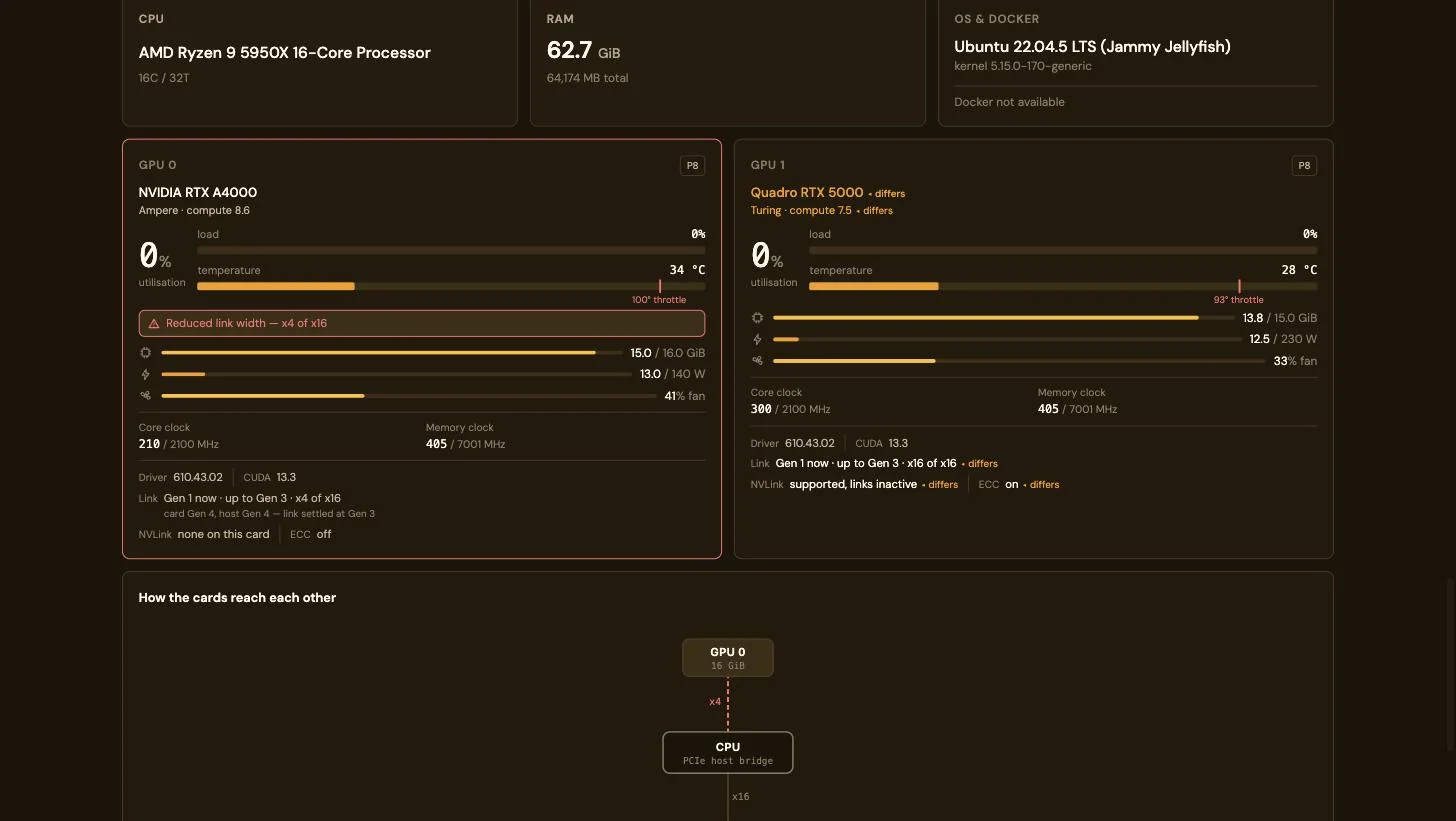
La même console prend en charge un M1 de 16 Go, deux cartes dépareillées dans une tour de bureau et un serveur NVSwitch 8 × B300, et elle désigne le goulot d’étranglement au lieu de le noyer dans une moyenne : un lien PCIe négocié en x4 au lieu de x16, des liens NVLink inactifs, un ECC configuré différemment d’une carte à l’autre.

Configuration système d’un serveur 8 × B300 : Intel Xeon 6776P, 3 019 Gio de RAM, huit panneaux NVIDIA B300 SXM6 avec chacun 241 sur 268,6 Gio utilisés, Link Gen 6 x16 of x16, NVLink 18 liens actifs sur 18 à 53,125 Go/s chacun, ECC activé, et un schéma d’architecture serveur montrant un NVSwitch relié à chaque carte
Huit cartes B300 SXM6 sur un NVSwitch : 18 liens NVLink actifs sur 18 par carte, ECC activé, PCIe Gen 6 x16, 241 sur 268,6 Gio utilisés par carte pendant le service de GLM-5.2 NVFP4 en parallélisme de tenseurs de degré 8.
Deux GPU dépareillés : une NVIDIA RTX A4000 portant l’avertissement rouge Reduced link width x4 of x16 et Link Gen 1 actuellement, Gen 3 au maximum, à côté d’une Quadro RTX 5000 dont l’architecture, la VRAM, la limite de puissance, le lien, le NVLink et l’ECC portent chacun la mention differs ; en dessous, un schéma montrant comment les cartes sont reliées au CPU par des liens x4 et x16
Deux cartes achetées à des années d’écart : le lien de l’A4000 n’est négocié qu’en x4 au lieu de x16, ce qui est signalé en rouge ; l’architecture, la limite de puissance, le NVLink (pris en charge, liens inactifs) et l’ECC de la Quadro portent chacun la mention differs. Le schéma montre quel emplacement PCIe est de largeur réduite.
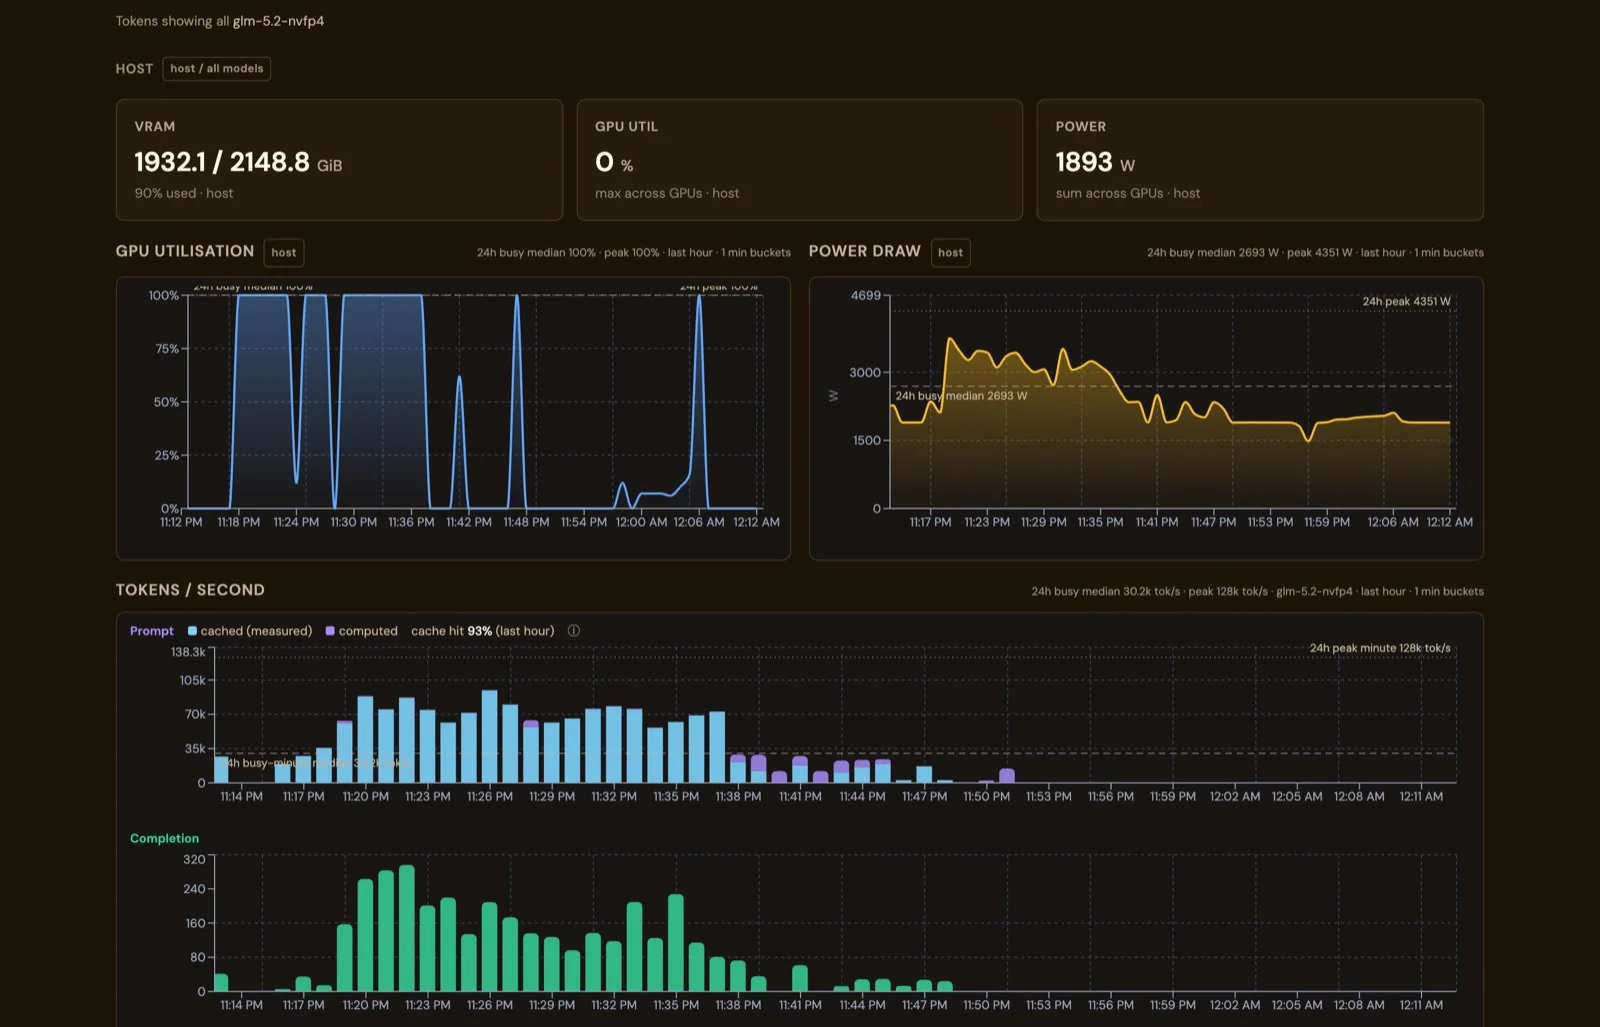
Stats sur le serveur 8 × B300 : VRAM 1 932,1 sur 2 148,8 Gio, puissance cumulée de 1 893 W sur l’ensemble des cartes, utilisation du GPU et consommation électrique sur la dernière heure, et jetons de prompt par seconde répartis entre lus dans le cache et calculés, avec un taux de succès de cache de 93 %
La même page Stats, à l’autre extrémité de la gamme : 1 932 sur 2 149 Gio de VRAM, 1 893 W sur l’ensemble des cartes, un pic de 4 351 W dans l’heure, et 93 % des jetons de prompt servis par le cache.
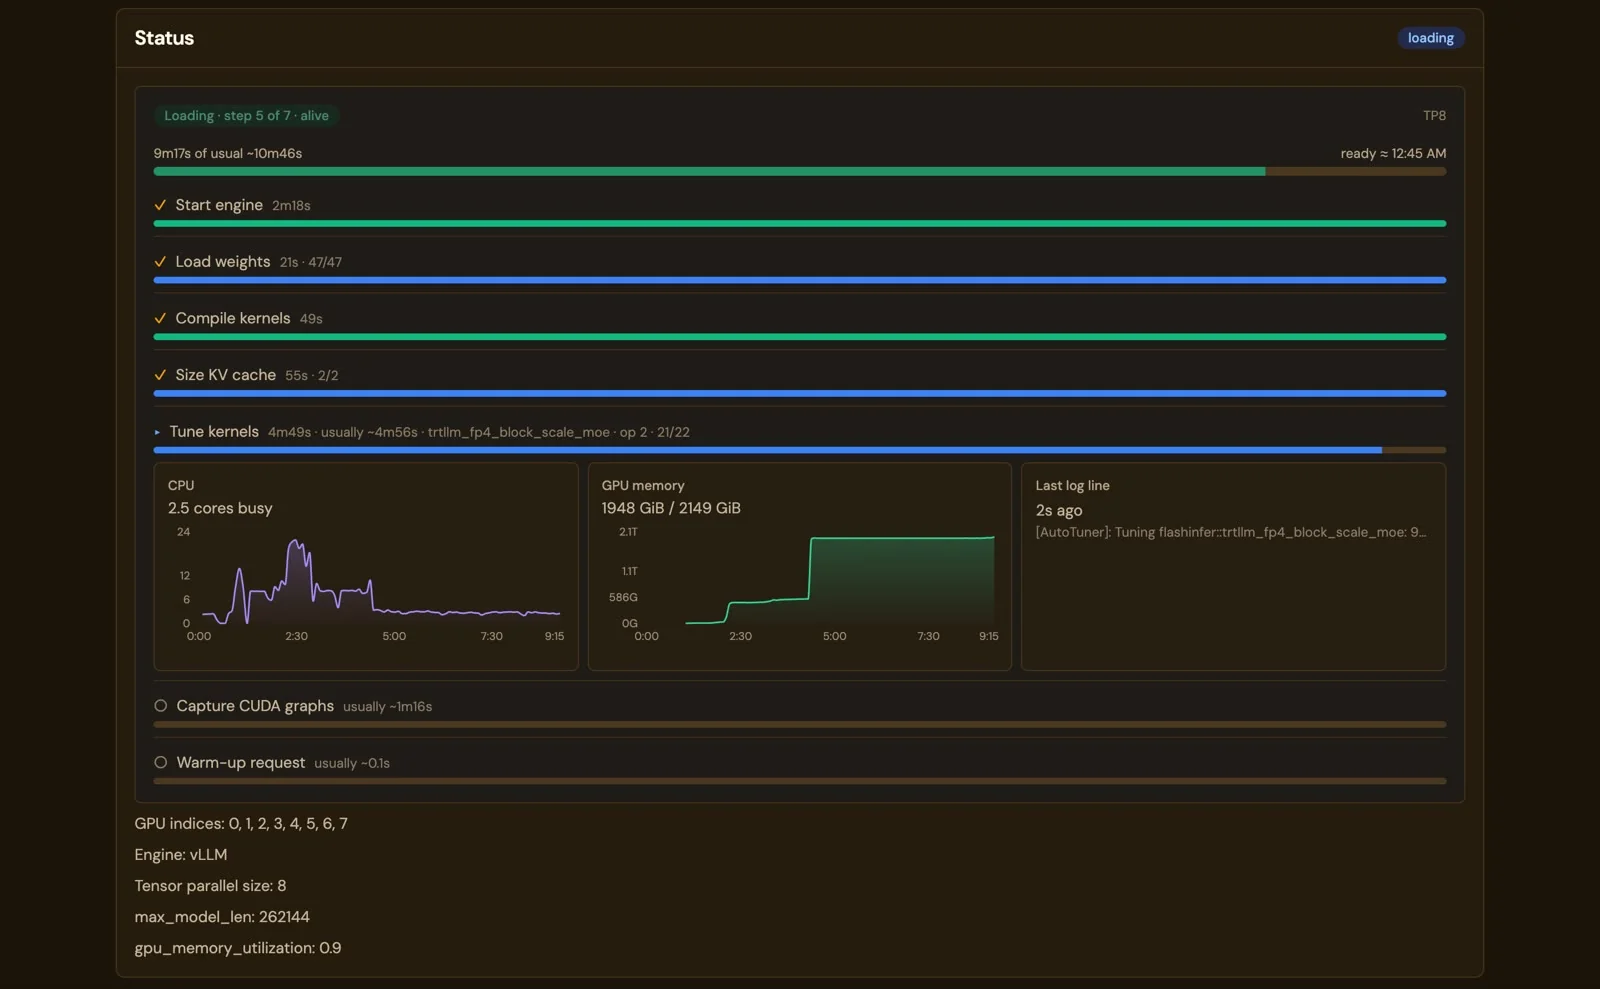
La page du modèle pendant le chargement de GLM-5.2 NVFP4 sur huit B300 : 9 min 17 s écoulées pour une durée habituelle de 10 min 46 s, étapes Start engine, Load weights 47 of 47, Compile kernels et Size KV cache terminées, Tune kernels à op 21 of 22, avec des graphiques du CPU et de la mémoire GPU et la dernière ligne du journal
Un chargement de 10 minutes, étape par étape : GLM-5.2 NVFP4 sur huit B300, 9 min 17 s écoulées pour une durée habituelle de 10 min 46 s, et rien en rouge tant que le chargement progresse.

Ce que chaque panneau affiche par carte : la température par rapport à son propre seuil de bridage, la puissance par rapport à sa limite, les fréquences, le ventilateur, la génération et la largeur PCIe négociées à cet instant, l’ECC et le NVLink quand la carte en dispose, et le processus qui occupe la mémoire. Le schéma d’interconnexion est tiré de nvidia-smi topo -m. Sur un Mac : l’utilisation du GPU et le budget mémoire indiqué par Metal, sans la puissance. Enfin, le moteur lui-même est surveillé via son propre /health, et non via la table des processus : un moteur planté alors que son processus parent tourne encore est rechargé, et les éléments de diagnostic sont conservés.

Ce qu’il affiche

Surveillance des GPU

Chaque carte a ses propres indicateurs.

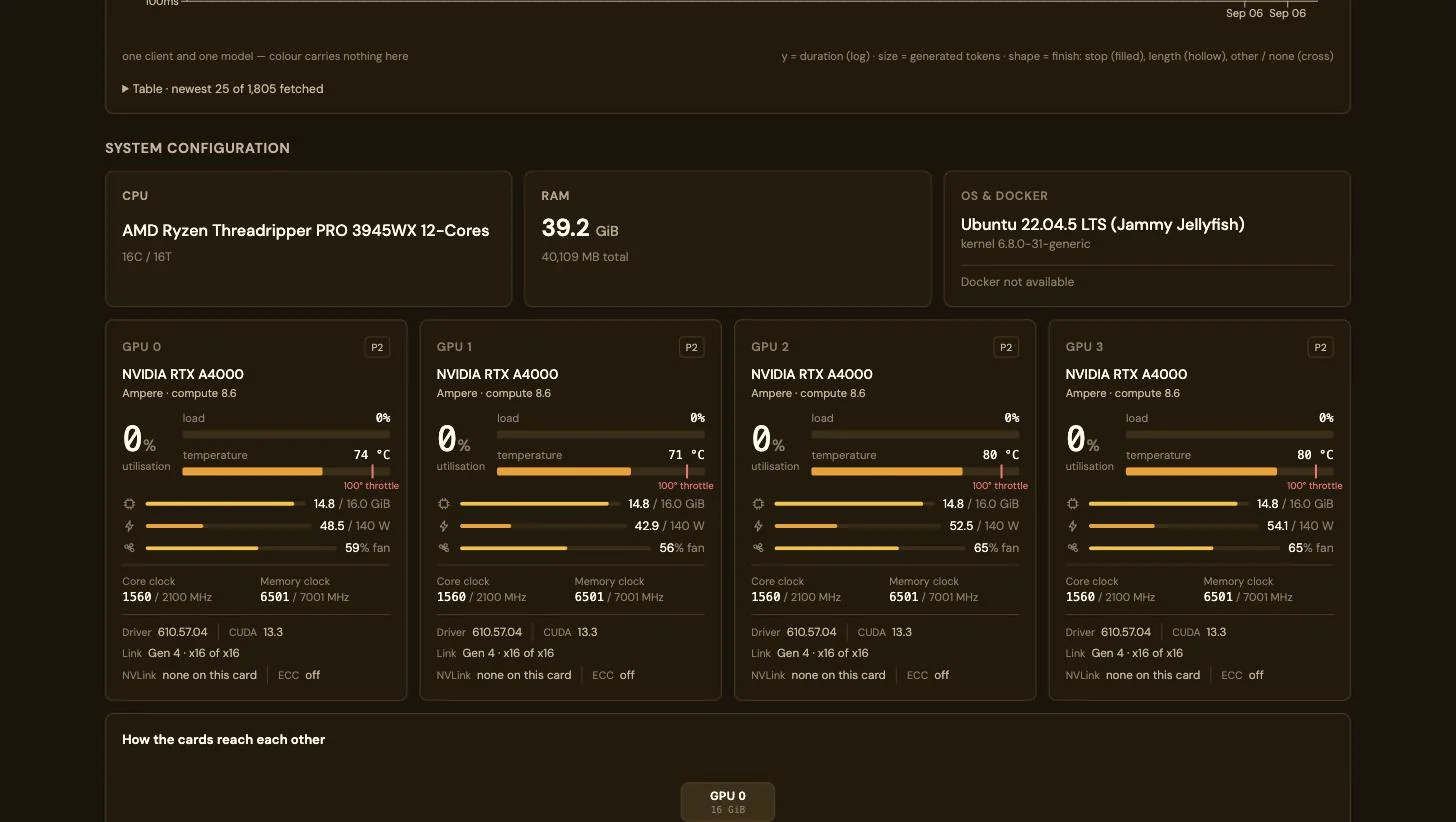
Utilisation, température par rapport au seuil de bridage propre à la carte, puissance par rapport à sa limite, VRAM, fréquences, lien PCIe et processus qui occupe la mémoire. Pas une moyenne sur toute la machine.

Configuration système et quatre panneaux GPU pour des cartes NVIDIA RTX A4000, avec utilisation, température, VRAM, puissance, ventilateur et fréquences par carte

Requêtes en cours

Voyez ce que fait chaque agent en ce moment.

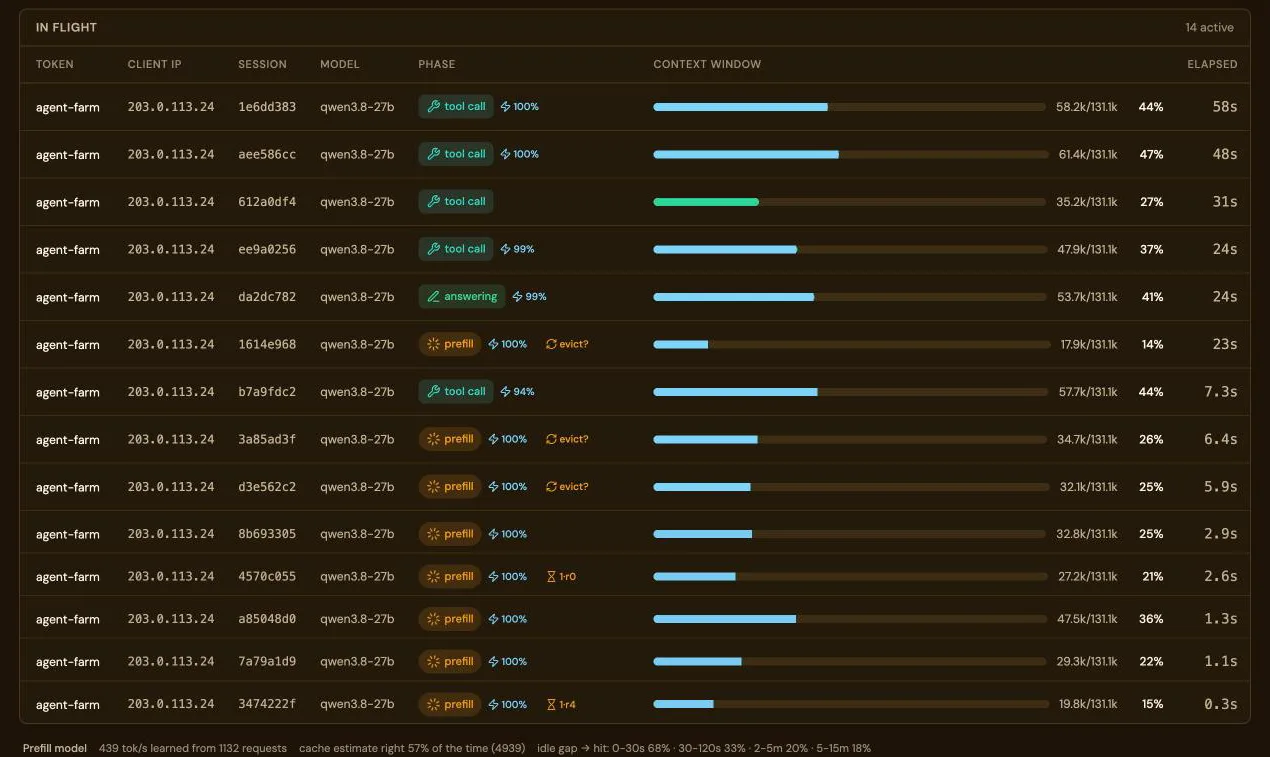
Chaque requête avec sa clé, sa session et sa phase : en file, prefill, réflexion, appel d’outil, réponse. La part de chaque prompt servie par le cache de préfixes, mesurée requête par requête.

Le tableau des requêtes en cours : dix requêtes actives, chacune avec sa clé, sa session, sa phase et ses jetons

Agents de codage

Claude Code, Codex et OpenCode, connectés depuis une seule page.

Connect génère la configuration de chaque outil avec l’adresse de ce warden, une clé et un modèle chargé, vérifie les prérequis par rapport à ce qui est réellement chargé et envoie une requête de test.

La page Connect a client avec Claude Code sélectionné et ses prérequis vérifiés

Libre, open source et développé au grand jour.

LM Warden est sous Apache-2.0 sur GitHub : le script d’installation et le fichier Compose constituent tout le déploiement, et vous pouvez lire les deux. Ni compte, ni vérification de licence, ni télémétrie. vLLM, llama.cpp et MLX sont des projets amont que nous exécutons sans modification.

mlx-rust-lm bientôt disponible

Un portage de mlx-lm d’Apple de Python vers Rust, sur les liaisons officielles mlx-c d’Apple. Développé et maintenu par l’équipe LM Warden comme projet open source indépendant, il servira de troisième moteur Mac à LM Warden et remplacera à terme le moteur Python mlx-lm, qui représente l’essentiel du téléchargement Mac actuel. Projet non officiel, sans lien avec Apple.