LM Warden

Ваши GPU — как облачный API.

LM Warden запускает vLLM, llama.cpp или MLX на вашем собственном оборудовании и открывает к ним доступ через единый OpenAI-совместимый порт: отдельный ключ для каждого приложения, учет использования по каждому ключу и панель мониторинга каждого GPU в реальном времени. Работает на компьютере под Linux с видеокартами NVIDIA или на Mac с Apple silicon.

Открытый код, Apache-2.0Без регистрации и телеметрииLinux + NVIDIA · macOS (бета) · Windows — в планах

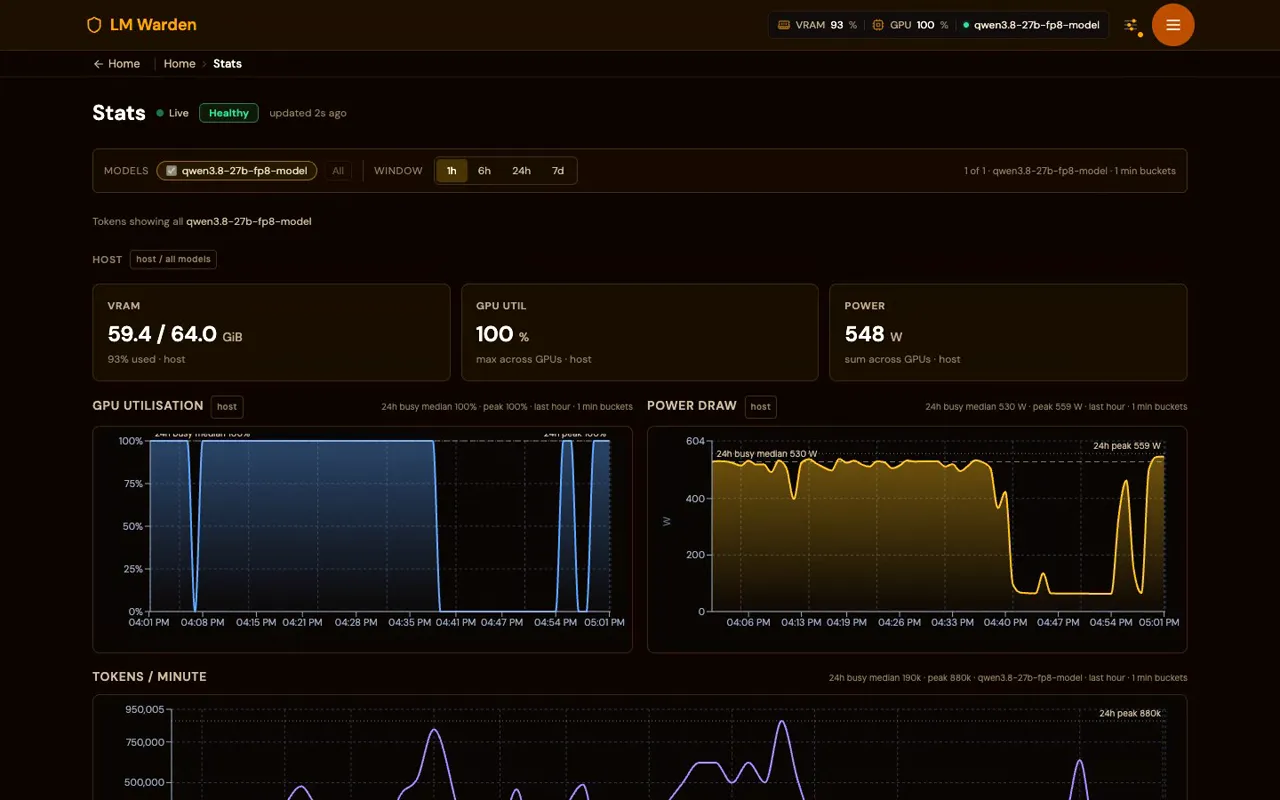
Страница Stats загруженного экземпляра LM Warden: VRAM 59,4 из 64 ГиБ, загрузка GPU 100 %, энергопотребление 548 Вт и графики загрузки GPU, энергопотребления и токенов в минуту за последний час
  • Linux · NVIDIA vLLM v0.32.0 и llama.cpp b11719 на CUDA
  • macOS на Apple silicon MLX и llama.cpp на Metal
  • API OpenAI, Anthropic Messages и Responses на одном порту
  • Агенты для кода Claude Code, Codex CLI, OpenCode и еще 7 настраиваются автоматически

Для чего его используют

Где вы будете его запускать?

Выберите платформу выше, чтобы увидеть инструкцию, или покажите все четыре.

Одна команда на сервере с GPU.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • Компьютер x86_64, Docker Compose v2.24+, NVIDIA Container Toolkit и видеокарта поколения Turing или новее.
  • Затем откройте http://HOST:8080/ui/, пройдите мастер первого запуска, добавьте модель и создайте ключ. Ваш эндпоинт: http://HOST:8080/v1.
  • Несколько GPU в одном сервере: тензорный параллелизм или по реплике на каждую карту с маршрутизацией с учетом кэша.
  • Пока поддерживается только NVIDIA. Поддержка AMD ROCm и GPU Intel появится, но сроков пока нет. Расскажите, на чем бы вы его запускали: Radeon · Intel.
  • Инструкция · Без интернета · Из исходников · Обновление
Загрузка модели на странице Models: для каждого шага указаны затраченное и типичное время
Загрузка модели после установки: для каждого шага показано типичное время по предыдущим загрузкам.

Приложение в строке меню, бета-версия.

Скачать для Mac (бета)

  • Около 110 МБ. Apple silicon (M1 или новее), macOS 14 или новее. SHA-256 · примечания к выпуску.
  • Движки: MLX и llama.cpp, собранный с поддержкой Metal. Та же консоль и тот же OpenAI API; нет vLLM и данных об энергопотреблении.
  • Честно о бета-версии: приложение подписано ad-hoc и не прошло нотаризацию Apple, поэтому при первом запуске macOS попросит разрешить его в разделе «Конфиденциальность и безопасность»; для обновления нужно скачать новую версию. Как выполнить первый запуск.
  • Доступно только по адресу 127.0.0.1, пока вы не выберете Share on Local Network.
  • Скоро: mlx-rust-lm, третий движок. Команда LM Warden переносит mlx-lm от Apple с Python на Rust поверх официальных привязок Apple mlx-c. Новый движок будет работать наряду с MLX и llama.cpp и со временем заменит движок mlx-lm на Python, который вместе с самим Python и его библиотеками сейчас занимает большую часть дистрибутива. Это неофициальный проект, не связанный с Apple.
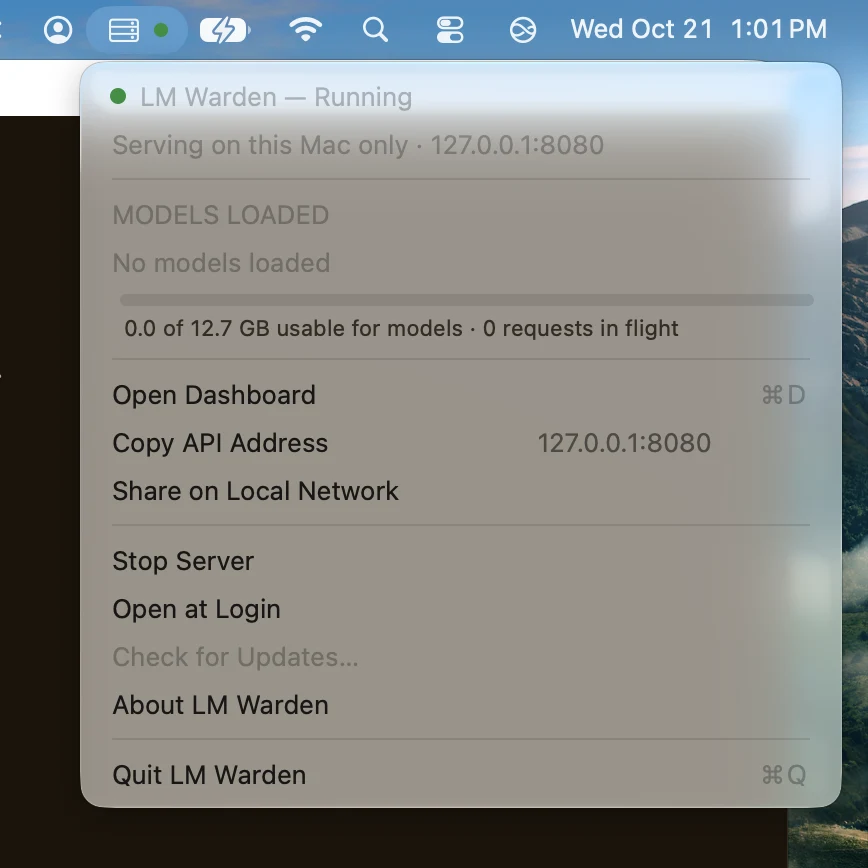
Меню LM Warden в строке меню Mac: Running, доступ только с этого Mac по адресу 127.0.0.1:8080, модели не загружены, индикатор памяти, Open Dashboard, Copy API Address, Share on Local Network
Меню бета-версии в строке меню на M1 с 16 ГБ.

Следующая на очереди — Windows. Сроков нет.

Мы работаем над ней прямо сейчас и выложим сборку здесь в тот же день, когда она будет готова, — без листов ожидания и предварительной регистрации. А пока есть два рабочих варианта:

  • Запустите LM Warden на Linux-сервере с GPU и работайте с ним из Windows: любые клиенты OpenAI, а также Claude Code и Codex подключаются по сети.
  • Следите за выпусками на GitHub, чтобы узнать о первой сборке для Windows.
  • Затем появится поддержка GPU AMD Radeon и Intel. Расскажите, на чем бы вы его запускали: Radeon · Intel.

Готовый сервер: скоро, но без сроков.

Четвертый способ запустить LM Warden — для сервера, который больше ничем не занят.

  • Вы вставляете USB-накопитель в компьютер с GPU, и с него устанавливается минимальный Linux, единственная задача которого — запускать LM Warden.
  • Он сам настраивает сеть и хранилище для моделей.
  • Сервер либо получает обновления по сети, либо работает в полностью изолированной сети.
  • Для защищенного выделенного LLM-сервера: для команды, которой нужен сервер со строго ограниченным доступом, или для площадки без выхода во внешнюю сеть.

Пока его нет, установка для Linux, описанная выше, решает ту же задачу на сервере, который вы настраиваете сами, в том числе установку без интернета в изолированной сети. Следите за выпусками на GitHub.

Изображения пока нет: у продукта еще нет ни названия, ни оборудования, которое можно было бы показать, а рисовать макет мы не будем.

Уже пользуетесь? В Linux обновление выполняется на месте: скачайте новые образы и перезапустите — база данных автоматически перейдет на новую схему. Инструкция · Список изменений.

Восемь проблем собственного LLM-сервера — и как мы решаем каждую.

Сам по себе движок обслуживает одну модель на одном порту. Ниже — все, чего ему не хватает, и наши собственные замеры там, где они есть.

  1. Поместится ли эта модель на мой GPU?

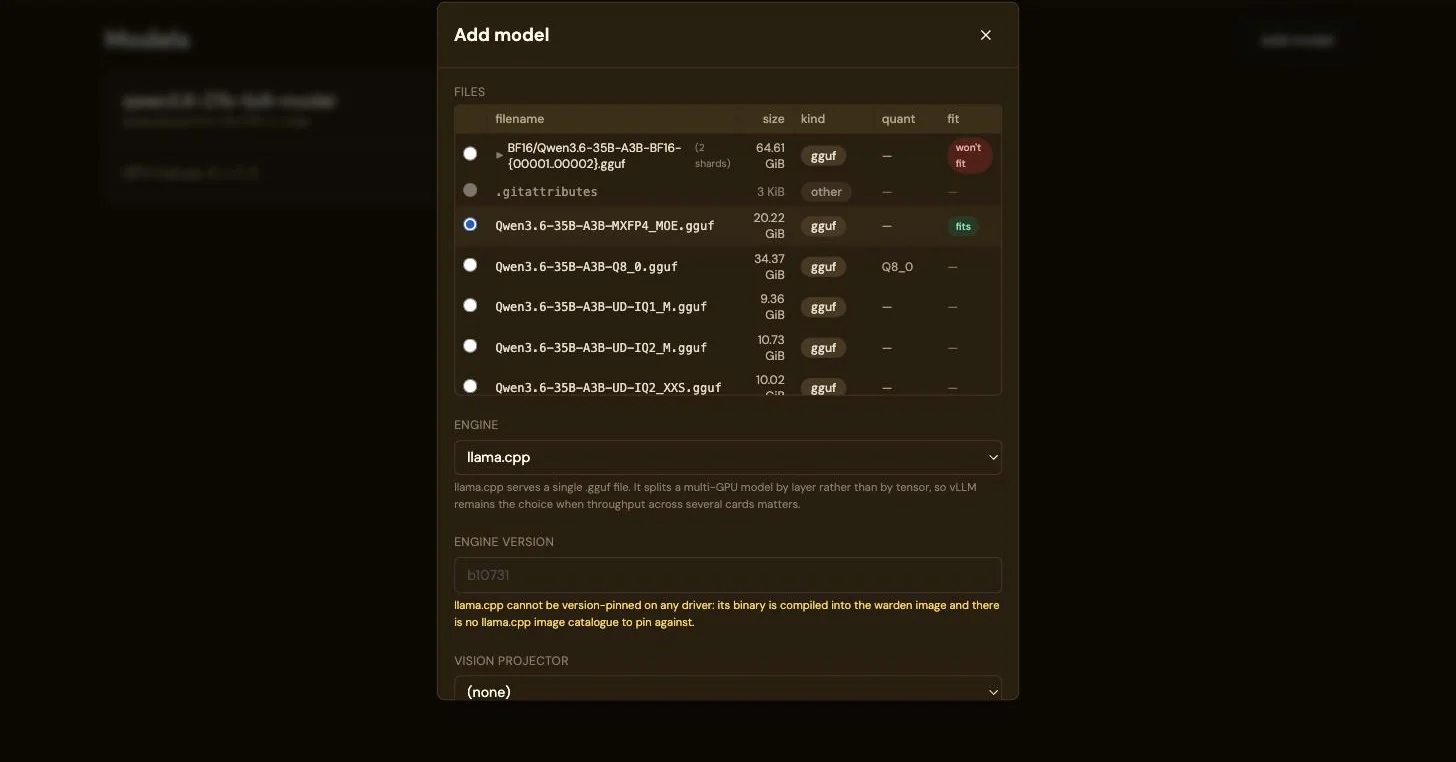
    Вставьте ссылку на репозиторий Hugging Face в Add model. Для каждого файла выводится оценка для отмеченных карт: поместится, поместится впритык или не поместится. Отметьте больше карт — их память суммируется. Ничего не скачивается, пока не найдется подходящий вариант.

    Тот же файл на 20,22 ГиБ помечен как подходящий, когда выбраны четыре GPU
  2. Вы купили GPU. Они работают или простаивают?

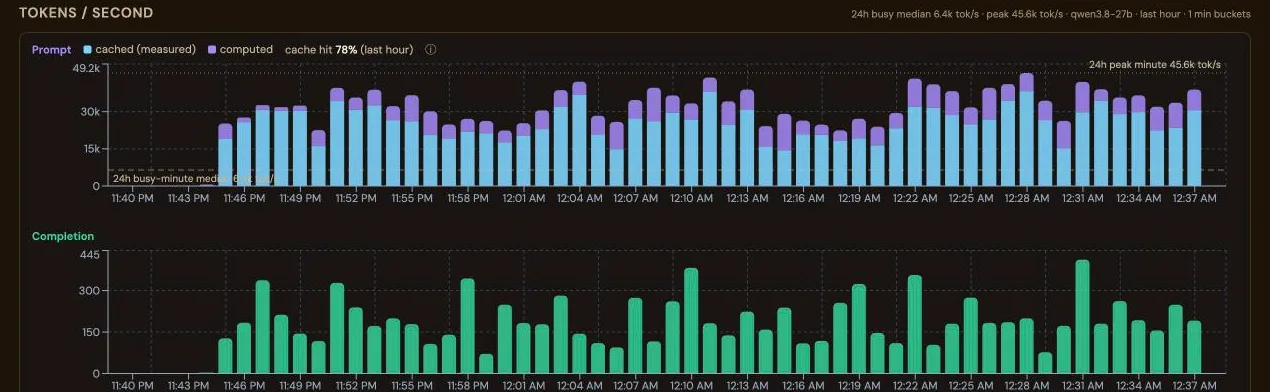
    Пропускная способность — это параллелизм × длина промпта × повторное использование кэша, а сам по себе движок не показывает эти величины вместе. Страница Stats показывает их за период от 1 ч до 7 дней: VRAM, загрузку GPU, энергопотребление (Linux), токены в секунду с разделением токенов промпта на кэшированные и вычисленные, задержку p50/p95, долю попаданий в кэш промптов, вытеснения запросов, запросы по ключам и по IP-адресам клиентов. Если загрузка GPU не растет, а запросы стоят в очереди, нужно больше параллелизма; низкая доля попаданий в кэш — повод закрепить сессии за репликами.
    Токены в секунду: токены промпта разделены на кэшированные и вычисленные, ниже токены ответа
  3. Поговорите с моделью, прежде чем что-либо подключать.

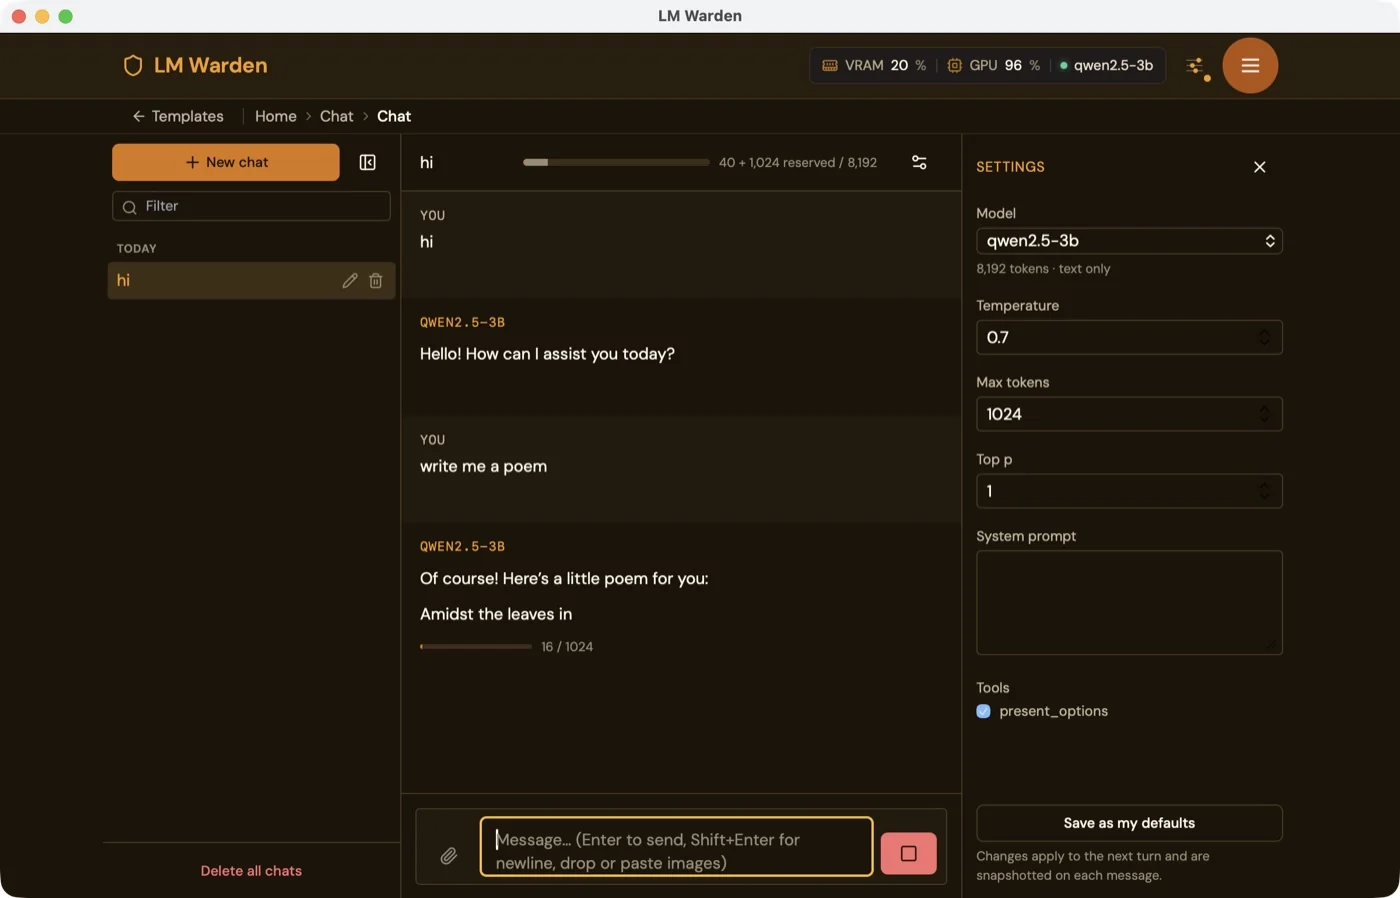
    Чат находится в том же окне, что и все остальное. Потоковый вывод Markdown с подсветкой кода и формулами; до восьми изображений PNG, JPEG или WebP в одном сообщении для мультимодальной модели; температура, top-p, максимум токенов и системный промпт задаются для каждого чата и сохраняются как значения по умолчанию; чаты сохраняются, получают названия, от них можно ответвлять новые. Вызовы инструментов видны прямо в чате, поэтому можно убедиться, что модель вызывает их правильно, прежде чем доверить ее агенту.

    Чат в окне консоли приложения для Mac, потоковый ответ qwen2.5-3b, в заголовке GPU 96 %
  4. Что модель на самом деле получила и что ответила?

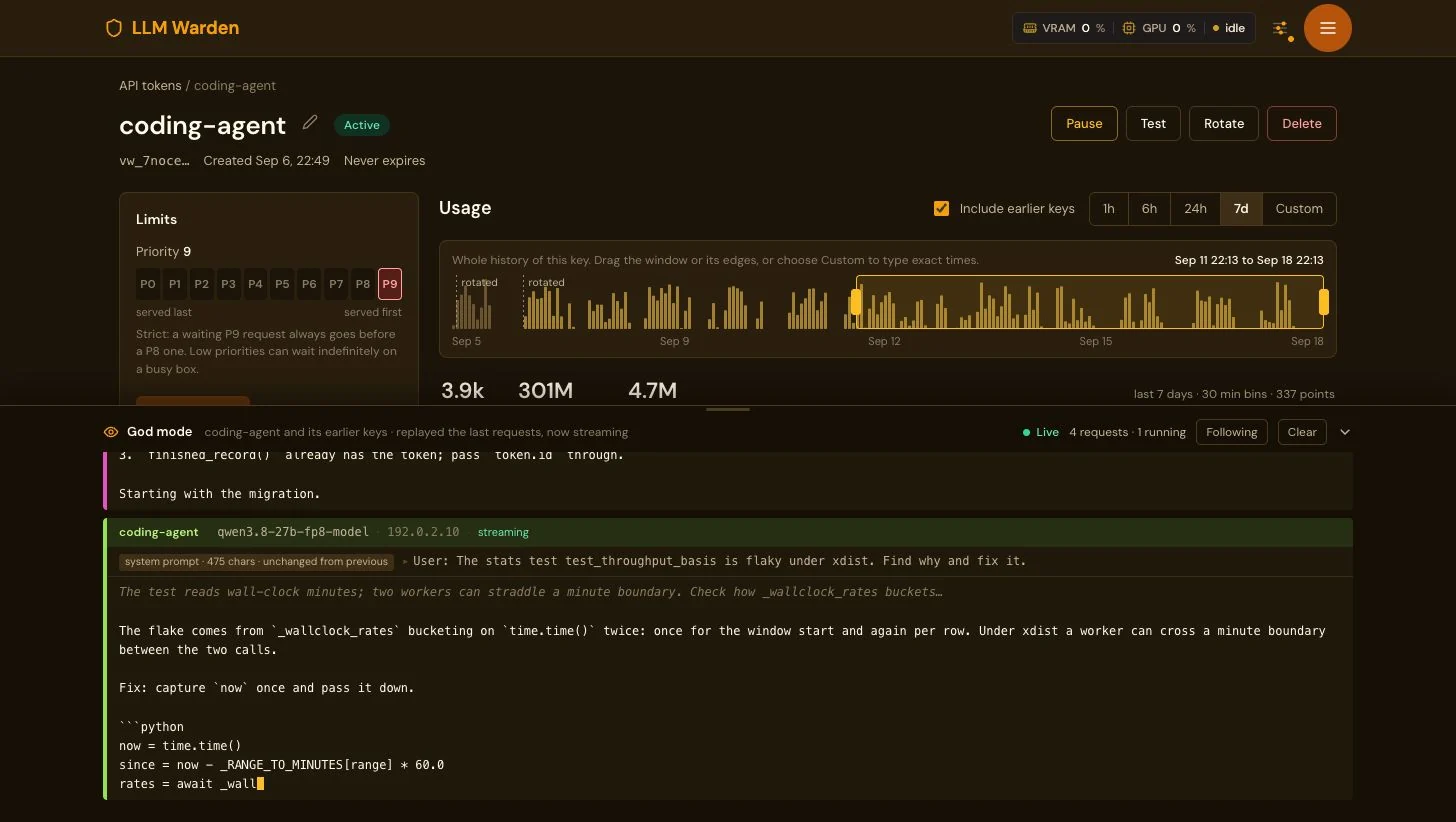
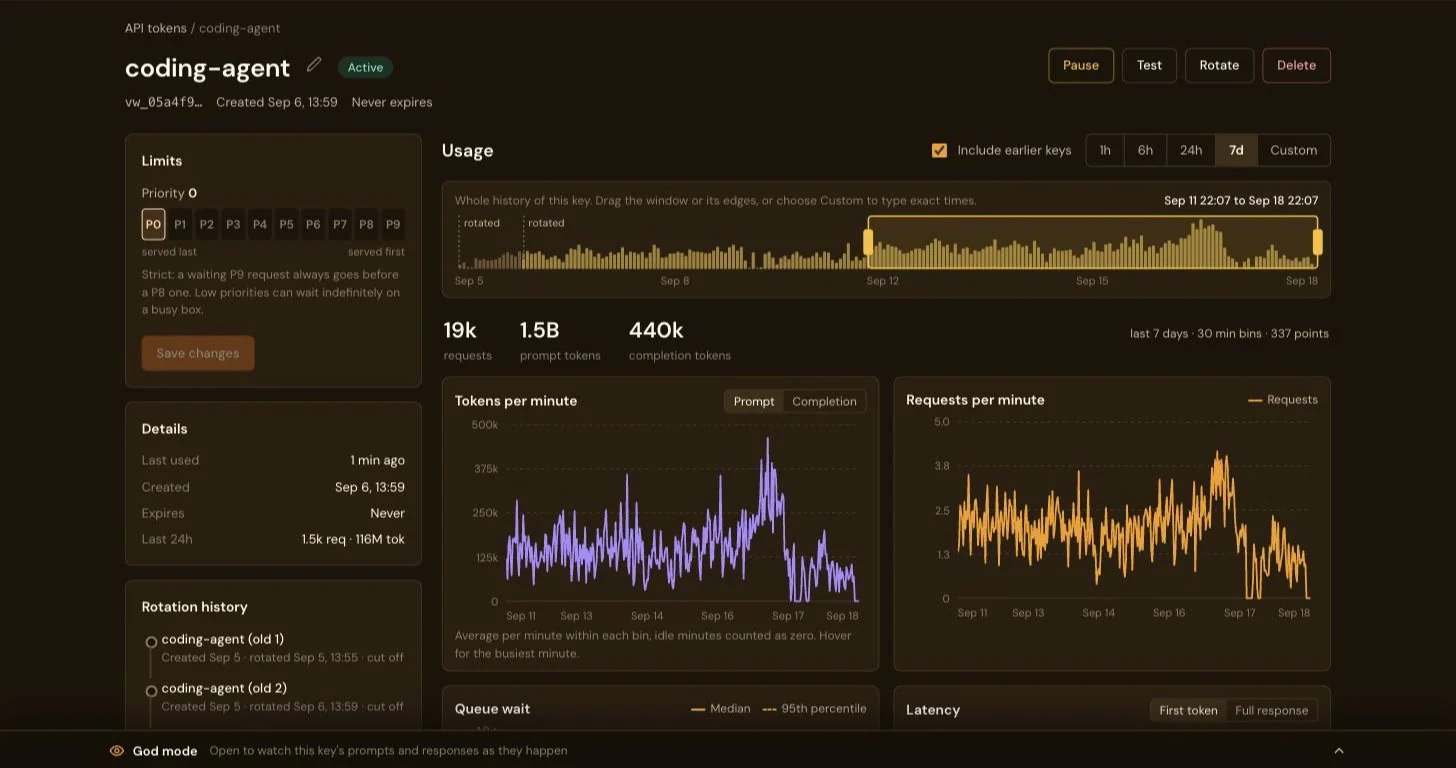
    God mode для отладки промптов: если в развертывании включен VW_GODMODE_ENABLED, на странице каждого ключа появляется панель, которая в реальном времени показывает промпты и ответы по этому ключу. По умолчанию режим выключен, а в выключенном состоянии панели нет вовсе. Данные хранятся в кольцевом буфере ограниченного размера в памяти: в базу данных и на диск ничего не пишется, после перезапуска все стирается. Открыть панель может любой, у кого есть сессия администратора; других ролей, кроме администратора, в LM Warden нет.

    Страница ключа API coding-agent с открытой внизу панелью God mode: Live, 4 запроса, 1 выполняется; идет потоковый ответ на запрос к qwen3.8-27b-fp8 с адреса 192.0.2.10: виден промпт пользователя о нестабильном тесте статистики и ответ модели с исправлением на Python по мере его написания

На каждом шаге агент заново читает весь диалог.

Агент на каждом шаге заново отправляет всю историю, поэтому длинный диалог — это в основном префикс, который движок уже обработал. vLLM сохраняет эту работу в кэше префиксов, но только на той реплике, которая ее выполнила, а собственный балансировщик vLLM отправляет каждый шаг на реплику с самой короткой очередью. LM Warden размещает каждый новый диалог на наименее загруженной реплике и закрепляет его там по идентификатору сессии, который Claude Code и так отправляет. На другую реплику запрос уходит, только когда нагрузка на текущую превышает порог переноса.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Четыре шага одного диалога на модели с четырьмя репликами. С балансировщиком vLLM каждый шаг проходит prefill (чтение промпта в кэш) почти с нуля на той реплике, которой он достался. С LM Warden диалог остается на реплике 2, и prefill проходит только новый шаг. Это схема механизма, а не результат замера.

Замеры на нашем сервере с четырьмя картами (4 × RTX A4000, Qwen3-4B в виде четырех реплик по одной карте, синтетические сессии в стиле Claude Code, прогоны с выключенной и включенной привязкой сразу друг за другом): при закрепленных диалогах доля токенов промпта, взятых из кэша, выросла с 56 до 86 % при 4 одновременных сессиях, а медианное время до первого байта сократилось с 2,05 до 0,38 с. Выходных токенов в минуту было больше на каждой ступени нагрузки, а время до первого байта p95 (самые медленные 5 %) — ниже на каждой ступени. Число занятых реплик почти не изменилось (2,71 против 2,83 из четырех при 4 сессиях): выигрыш дает повторное использование кэша, а не то, что работает больше карт.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Доля попаданий в кэш префиксов на каждой ступени: отношение токенов промпта, взятых из кэша, ко всем запрошенным токенам промпта, суммарно по четырем репликам, по приросту собственных счетчиков vLLM за ступень. Выигрыш сохраняется, пока есть запас мощности, и исчезает при 32 сессиях, когда диалоги начинают уходить на другие реплики.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Время до первого байта при 4–32 одновременных сессиях, медиана и p95, в логарифмической шкале, чтобы на одном графике уместились значения и меньше секунды, и в несколько минут. С привязкой медиана намного ниже вплоть до 16 сессий (0,38 против 2,05 с при 4) и выше при 24 и 32; p95 ниже на каждой ступени, хотя при 16 разница (24,9 против 26,2 с) не выходит за пределы шума при одном прогоне на вариант. Измерено на стороне клиента, через интернет, до первого токена потокового ответа.

Все ступени нагрузки, привязка выкл. → вкл.

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Замеры на нашем сервере с четырьмя картами и небольшой моделью: сначала с выключенной привязкой, затем с включенной, без перезапуска vLLM между прогонами. Поэтому второй прогон начинался с прогретым кэшем префиксов; промпты в обоих прогонах генерировались с одним и тем же начальным значением (seed). Каждая ступень длится 3 минуты, так что за нее успевает завершиться лишь от 9 до 31 сессии, и одна сессия больше или меньше сдвигает показатель «сессий в час» на 20; выходные токены в минуту — более устойчивый показатель. Ваши модель, карты и нагрузка будут другими; карточка реплик на странице модели показывает те же счетчики для вашей системы.

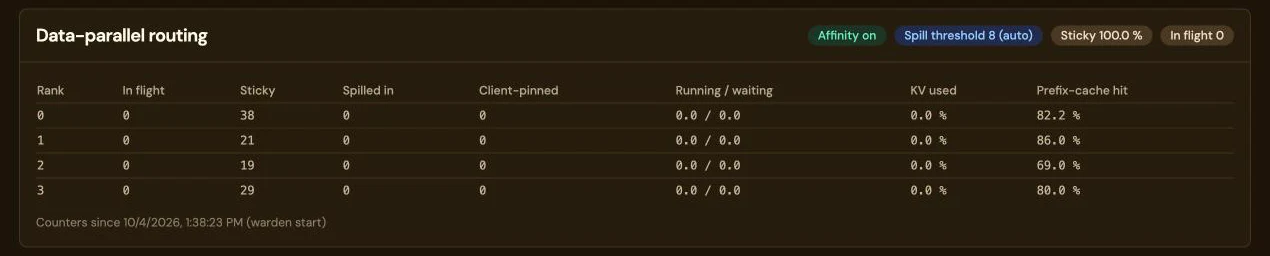
Карточка Data-parallel routing на странице модели с метками Affinity on, Spill threshold 8 (auto), Sticky 100.0% и In flight 0. В таблице реплики с 0 по 3 со столбцами in flight, sticky (38, 21, 19 и 29), spilled in, client-pinned, running и waiting, занятый KV и доля попаданий в кэш префиксов (82,2; 86,0; 69,0 и 80,0 %), а также строка о том, что счетчики ведутся с момента запуска LM Warden.
Те же счетчики на странице модели: по строке на реплику — запросы, которые она обрабатывает, сколько диалогов на ней осталось (sticky) и сколько перенесено с других реплик, выполняющиеся и ожидающие запросы, занятый KV-кэш и доля попаданий в кэш префиксов. Снимок от 4 октября 2026 г. с включенной привязкой и порогом переноса 8 (auto): sticky 100 % и доля попаданий в кэш префиксов 82,2; 86,0; 69,0 и 80,0 % на репликах с 0 по 3. Это снимок карточки интерфейса, а не результат замера. Коснитесь карточки, чтобы увеличить ее.

Где привязка проигрывает. Ступени с 24 и 32 сессиями — это намеренная перегрузка четырех небольших карт, когда каждая реплика загружена полностью. Выходных токенов все равно больше (11 178 против 9 048 и 16 638 против 14 760 токенов в минуту), а хвост медленных запросов намного короче (p95 38 против 59 с и 39 против 83 с), но медианное время до первого байта с привязкой хуже: 13,1 против 5,1 с при 24 сессиях и 27,7 против 12,3 с при 32. Причину мы пока не выяснили, и снижение порога переноса с 8 до 4 ничего не изменило.

На загруженном сервере проверьте оба варианта. Преимущество максимально, пока есть запас мощности; если сервер работает на пределе, стоит измерить обе настройки, а привязку можно отключить для каждой модели отдельно. Реплики, а значит и эта маршрутизация, есть только в установке для Linux с GPU NVIDIA; в приложении для Mac (бета) нет ни тензорного параллелизма, ни параллелизма по данным.

Полная методика: нагрузка, тестовый стенд, порог переноса и сервер с семью GPU, который с тех пор работает в этом режиме →

Подключите агента для программирования к своим GPU.

Десять инструментов подключаются по базовому URL и ключу; два из них при этом могут по-прежнему отправлять сложные задачи в Claude по вашей платной подписке.

Сложное — по подписке Claude, рутину — на ваши GPU

Claude Code и Anthropic SDK — через маршрутизатор. В правиле указываются модели Claude, на запросы к которым отвечают ваши GPU; все остальное уходит в Anthropic через вашу учетную запись или ключ.

Куда идет запрос Claude Code Агент отправляет каждый запрос в маршрутизатор LM Warden. Запросы к моделям claude-haiku уходят к модели на вашем GPU, и она отвечает от имени запрошенной модели. Запросы ко всем остальным моделям, включая Opus, передаются в Anthropic через вашу учетную запись. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Куда идет запрос Claude Code Агент отправляет каждый запрос в маршрутизатор LM Warden. Запросы к моделям claude-haiku уходят к модели на вашем GPU, и она отвечает от имени запрошенной модели. Запросы ко всем остальным моделям, включая Opus, передаются в Anthropic через вашу учетную запись. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
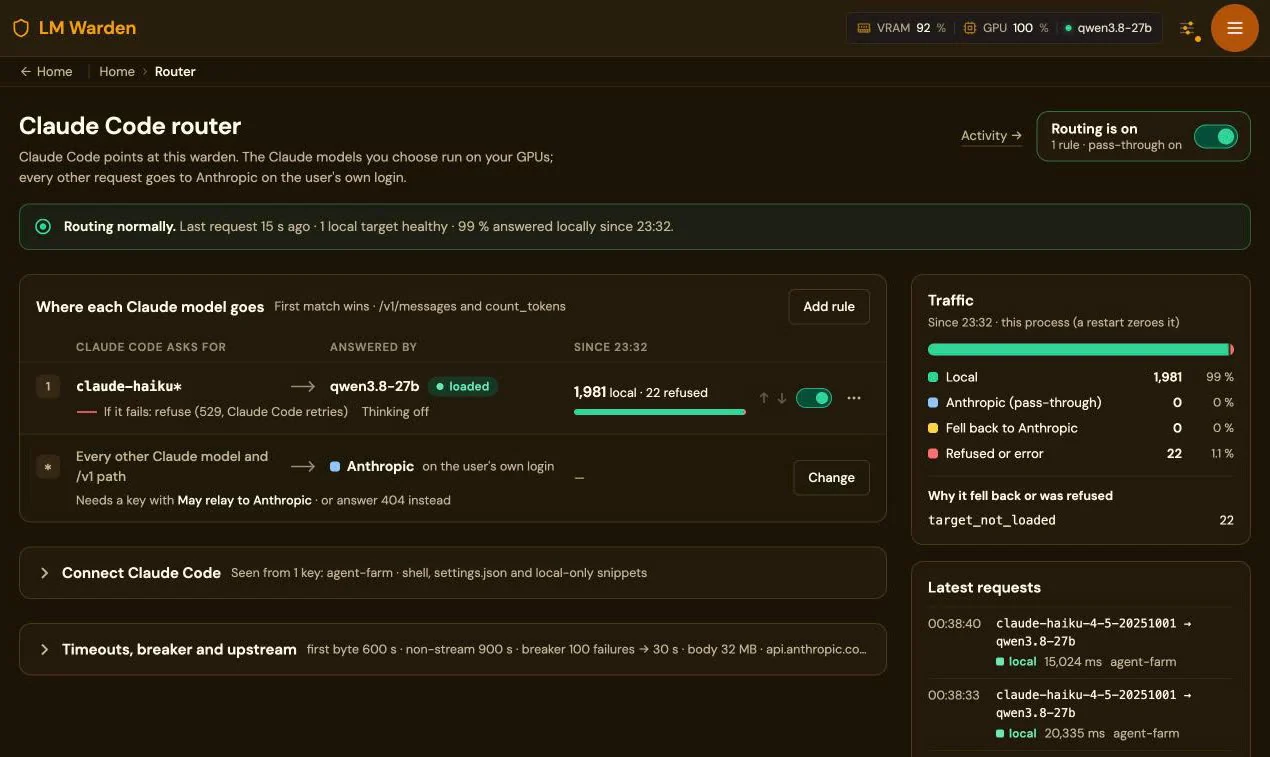
1 981запрос обработан локально — 99 % трафика Claude Code на этом сервере с момента его перезапуска. Данные со страницы Router нашего собственного сервера с семью GPU на 21 октября 2026 г.; еще 22 запроса были отклонены, пока целевая модель не была загружена.
Страница маршрутизатора Claude Code: маршрутизация включена, с 23:32 локально обработано 99 % запросов; правило 1 направляет claude-haiku* на qwen3.8-27b, 1 981 запрос обработан локально и 22 отклонены; все остальные модели Claude уходят в Anthropic через учетную запись пользователя
Claude Code 2.1.227 или новее: ANTHROPIC_BASE_URL указывает на LM Warden, ключ LM Warden передается в ANTHROPIC_CUSTOM_HEADERS, ваша учетная запись остается как есть. Качество ответов мы не сравнивали: поручайте локальной модели рутинные задачи с четкой постановкой.

Connect создает конфигурацию для каждого клиента и отправляет тестовый запрос.

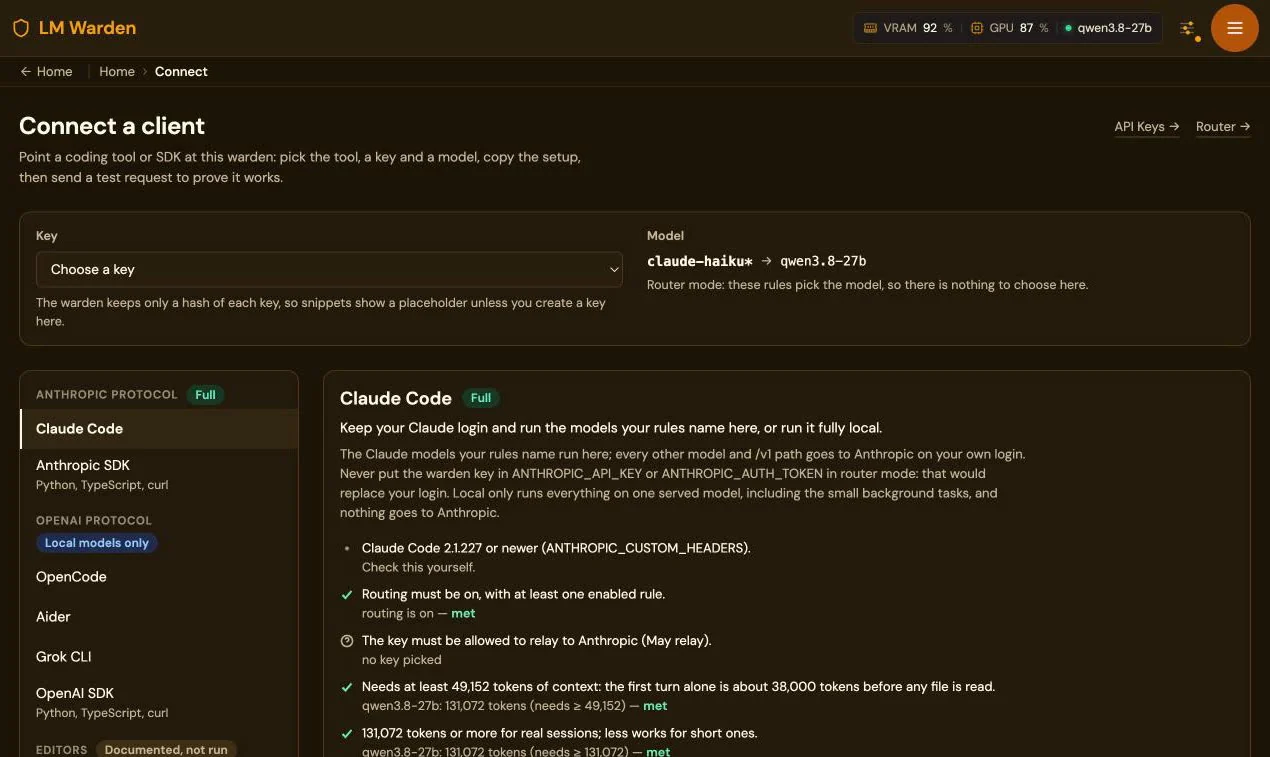
Выберите в консоли клиент, ключ и загруженную модель — консоль сверит каждое требование с тем, что действительно загружено (контекстное окно, вызов инструментов, включенный маршрутизатор), и выдаст готовые файлы, которые останется вставить. Все агенты для программирования: по странице на каждый клиент — что работает и что мы увидели в собственных тестах.

Страница Connect a client: выбор ключа, правило маршрутизатора claude-haiku* → qwen3.8-27b, клиенты, сгруппированные по протоколам, и панель Claude Code с проверенными требованиями

Пусть ИИ, за который вы уже платите, настроит ваши GPU.

Подобрать модель под ваши карты — значит выбрать квантование, движок, способ разделения модели между GPU, размер контекста и тип KV-кэша; каждая ошибка оборачивается лишним скачиванием и загрузкой. Все, что делает консоль, доступно через API, поэтому Claude Code, Codex или другой агент с доступом к командной строке может провести этот перебор за вас — на вашем оборудовании и с вашей нагрузкой.

Цикл настройки

Цикл настройки Изучить GPU, отобрать модели с помощью проверки совместимости еще до скачивания, загрузить кандидатов в разных схемах размещения, провести бенчмарки на реальных запросах, скорректировать настройки и оставить загруженным лучший вариант. Бенчмарк и корректировка повторяются, пока результат не устроит агента. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner Цикл настройки Изучить GPU, отобрать модели с помощью проверки совместимости еще до скачивания, загрузить кандидатов в разных схемах размещения, провести бенчмарки на реальных запросах, скорректировать настройки и оставить загруженным лучший вариант. Бенчмарк и корректировка повторяются, пока результат не устроит агента. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

Чем пользуется агент: GET /api/system/gpus; POST /api/models/fit-preview — еще до скачивания; регистрация модели и suggest-config; скачивание и загрузка; стресс-тест, который находит и применяет реальный предел контекста; GET /api/stats/v2/throughput и latency; а также ключ для инференса, который агент сам создает для тестового трафика. Сначала он читает /agent-guide.md — краткое описание этих вызовов, написанное для языковой модели.

Загрузка модели на странице Models: для каждого шага указаны затраченное и типичное время
Что отслеживает агент, пока модель загружается в выбранной схеме размещения: для каждого шага — типичное время по предыдущим загрузкам. Зависшая загрузка прерывается, а ее GPU освобождаются.

Четыре готовых промпта и что вы получите

  1. Изучить и отобрать. Промпт: перечисли мои GPU, отбери три модели с открытыми весами для агентного программирования, которые поместятся с контекстом не менее 65 536 токенов, проверь каждую через fit-preview, ничего не скачивай. Результат: таблица с моделью, квантованием, движком, GPU, контекстом и обоснованием выбора.
  2. Движок и схема размещения для одной модели. Промпт: выбери между vLLM и llama.cpp, а также между тензорным параллелизмом и репликами с параллелизмом по данным на моих картах; загрузи две лучшие схемы размещения, отправь каждой одни и те же 20 потоковых запросов, сравни при параллелизме 1 и 8. Результат: время до первого токена и токены в секунду для обеих схем; лучшая остается загруженной, другая выгружена, тестовый ключ отозван.
  3. Найти реальные пределы и применить их. Промпт: проведи стресс-тест загруженной модели, примени измеренный размер контекста, затем проведи бенчмарк при параллелизме 1, 4 и 16 с промптами примерно на 2 тыс. и 30 тыс. токенов. Результат: предел контекста записан в настройки модели, и есть таблица времени до первого токена и токенов в секунду для каждого уровня параллелизма и размера промпта.
  4. Сравнить двух кандидатов на ваших задачах. Промпт: прогони промпты из ./workload/*.txt на модели A и модели B при параллелизме 4, оцени каждый ответ. Результат: model-comparison.md с задержкой, токенами в секунду, правильностью ответов по оценке агента и рекомендацией; рекомендованная модель остается загруженной.

Прежде чем начать. Административный токен дает полные права администратора в LM Warden (модели, ключи, настройки; более узких прав доступа пока нет): задайте ему короткий срок действия и отзовите в Settings → Access Tokens, когда работа будет закончена. Стресс-тест намеренно доводит движок до сбоя, чтобы найти его предел, поэтому запускайте эти промпты на сервере LM Warden, от которого больше никто не зависит. Скачивать придется много; промпты проверяют совместимость до скачивания, но следите за свободным местом на диске.

Выбор движка и схемы размещения (vLLM, тензорный параллелизм или параллелизм по данным) доступен в установке для Linux; на Mac выбор — MLX или llama.cpp на одном GPU. Настройкой может заниматься любая платная модель, которой вы уже пользуетесь, а настраивается модель, работающая на ваших картах. Страница о настройке с помощью агента: все четыре промпта целиком.

Один сервер с GPU для всей вашей команды, семьи и агентов.

Создайте столько ключей API, сколько нужно, и раздайте их: коллеге, члену семьи, задаче CI, ферме агентов — у каждого свой ключ, свой приоритет и своя страница статистики. Оборудование работает на всех, а важные задачи никогда не ждут.

Ваше оборудование без прикрас: от Mac до восьми B300.

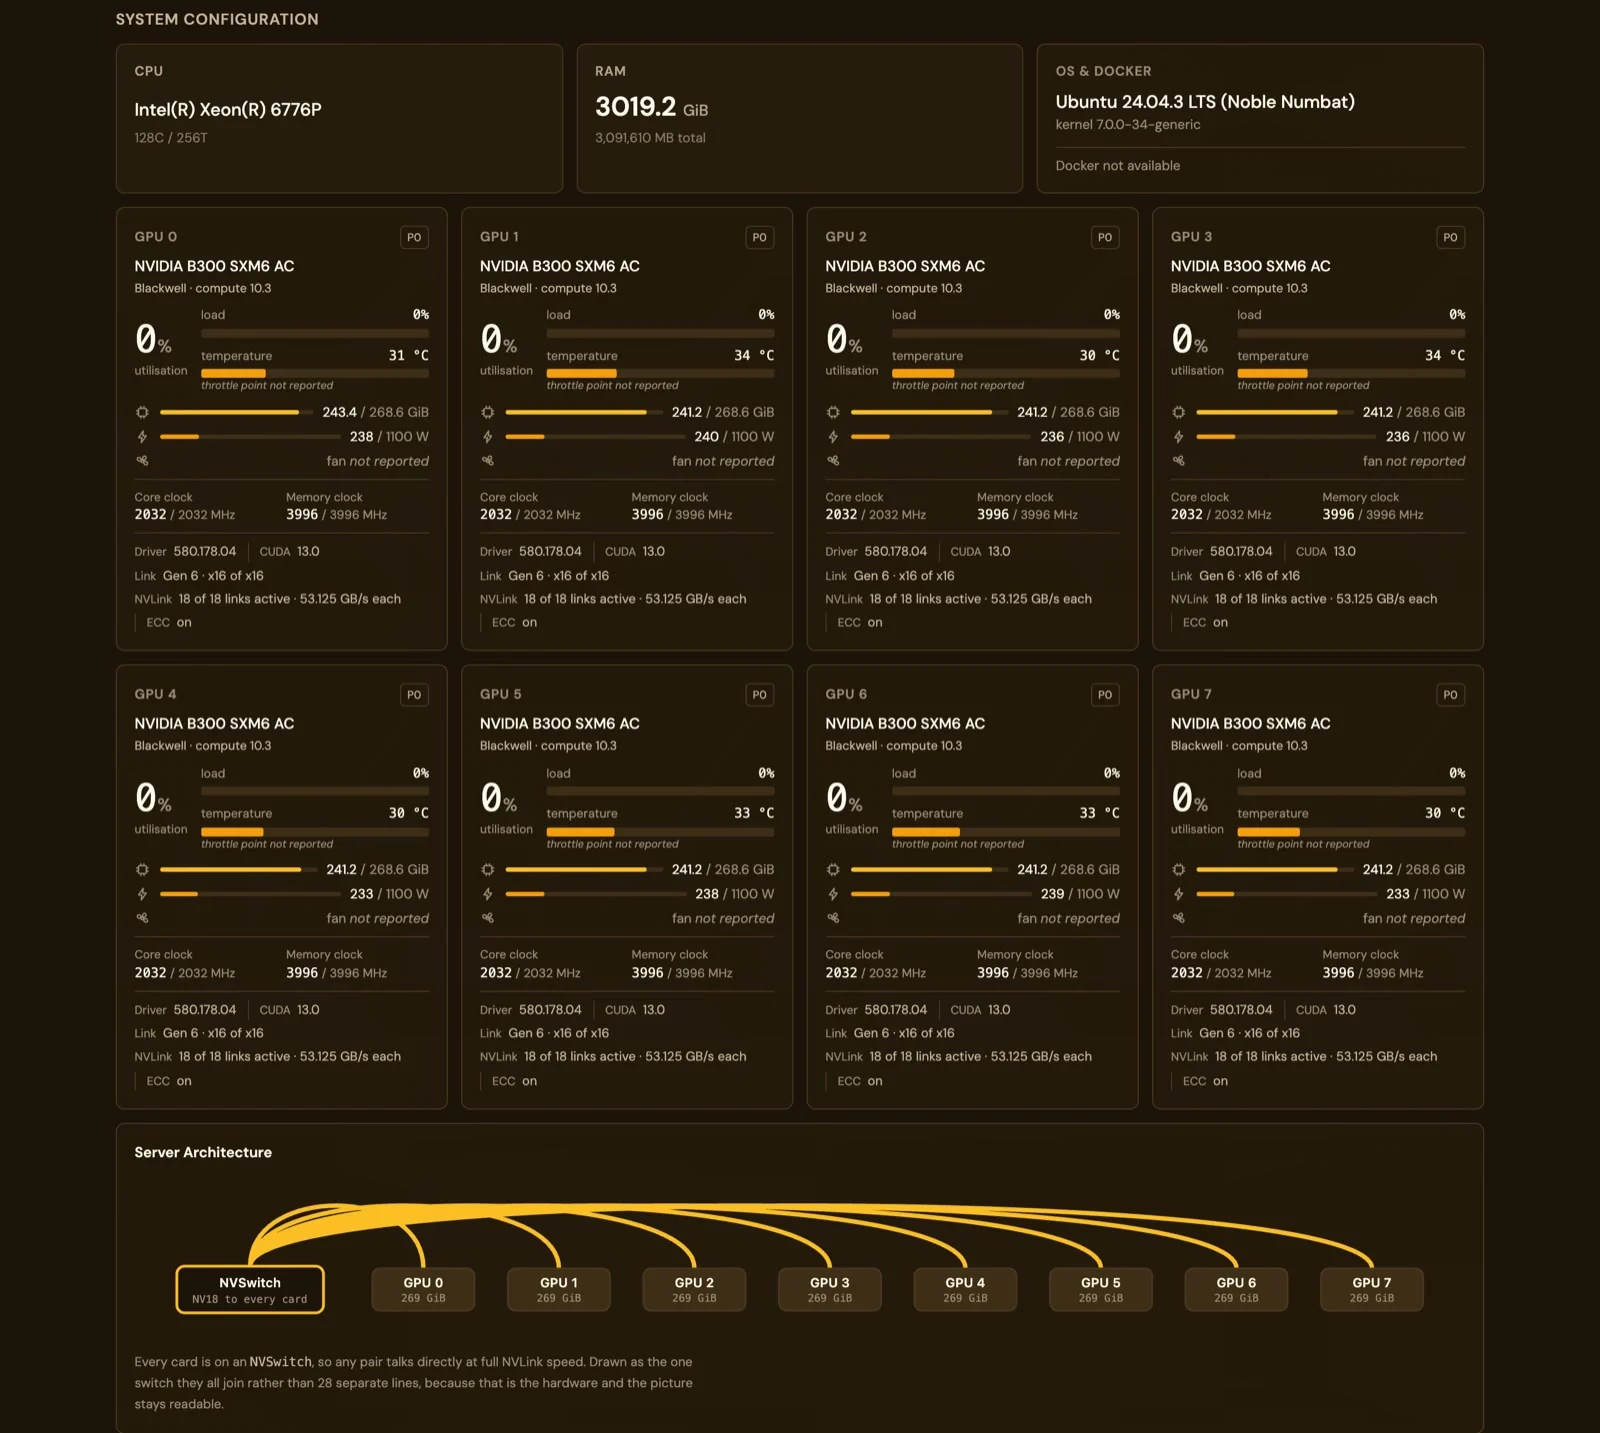
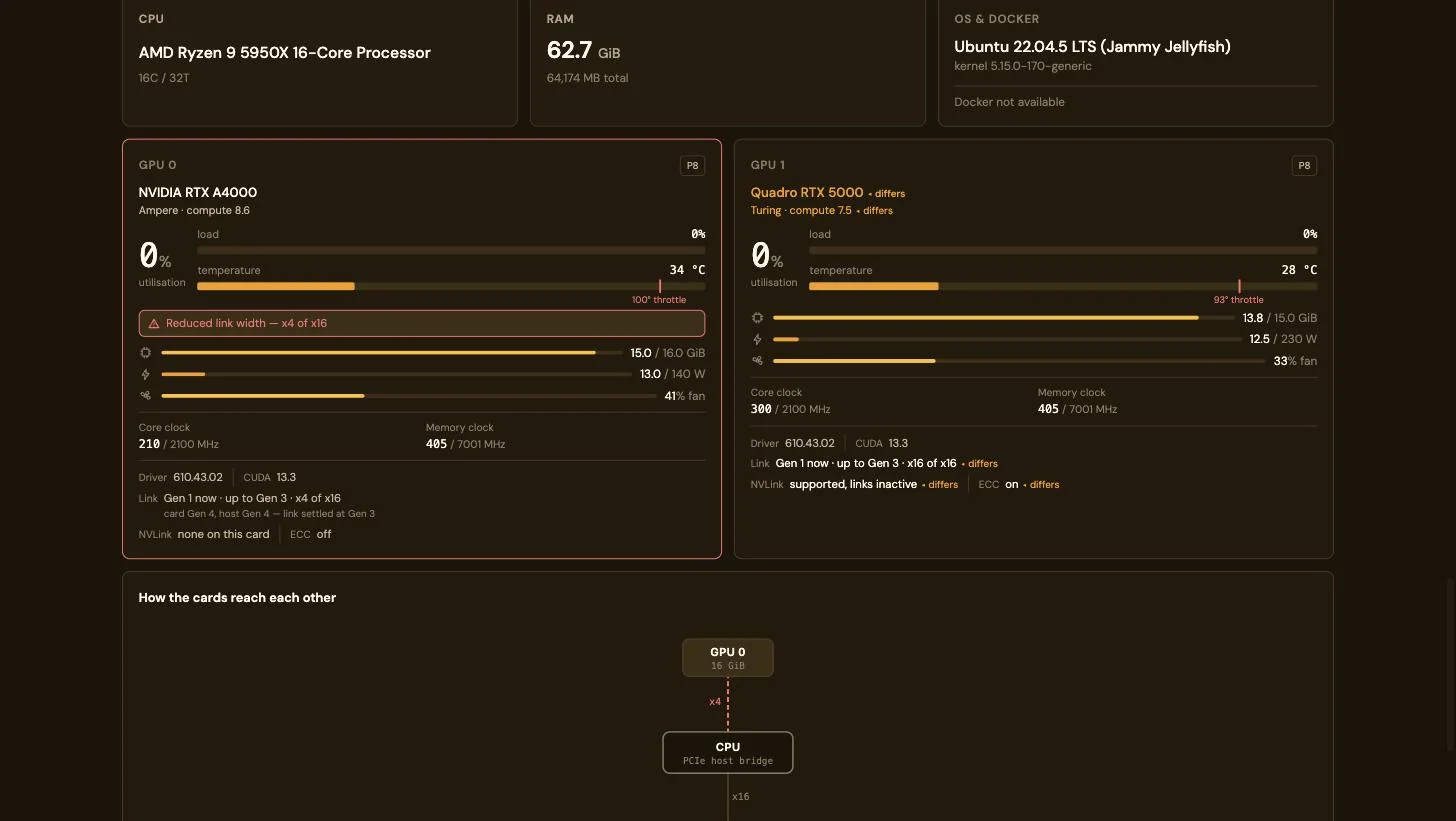
Одна и та же консоль работает с M1 с 16 ГБ, с парой разных карт под столом и с сервером 8 × B300 на NVSwitch — и прямо указывает на узкое место, а не размывает его в среднем значении: канал PCIe, работающий в режиме x4 вместо x16, неактивные каналы NVLink, разные настройки ECC на разных картах.

Конфигурация системы на сервере 8 × B300: Intel Xeon 6776P, 3 019 ГиБ ОЗУ, восемь панелей NVIDIA B300 SXM6, на каждой занято 241 из 268,6 ГиБ, Link Gen 6 x16 из x16, активны 18 из 18 каналов NVLink по 53,125 ГБ/с каждый, ECC включен, и схема архитектуры сервера: один NVSwitch, соединенный с каждой картой
Восемь карт B300 SXM6 на одном NVSwitch: на каждой карте активны 18 из 18 каналов NVLink, ECC включен, PCIe Gen 6 x16, занято 241 из 268,6 ГиБ при обслуживании GLM-5.2 NVFP4 с тензорным параллелизмом 8.
Два разных GPU: NVIDIA RTX A4000 с красным предупреждением Reduced link width x4 of x16 и Link Gen 1 сейчас, до Gen 3, а рядом Quadro RTX 5000, у которой архитектура, VRAM, лимит мощности, канал, NVLink и ECC помечены как отличающиеся; ниже схема подключения карт к CPU через каналы x4 и x16
Две карты, купленные с разницей в несколько лет: канал A4000 согласован на x4 вместо x16 и отмечен красным; архитектура, лимит мощности, NVLink (поддерживается, каналы неактивны) и ECC у Quadro помечены как отличается. Схема показывает, какой из слотов узкий.
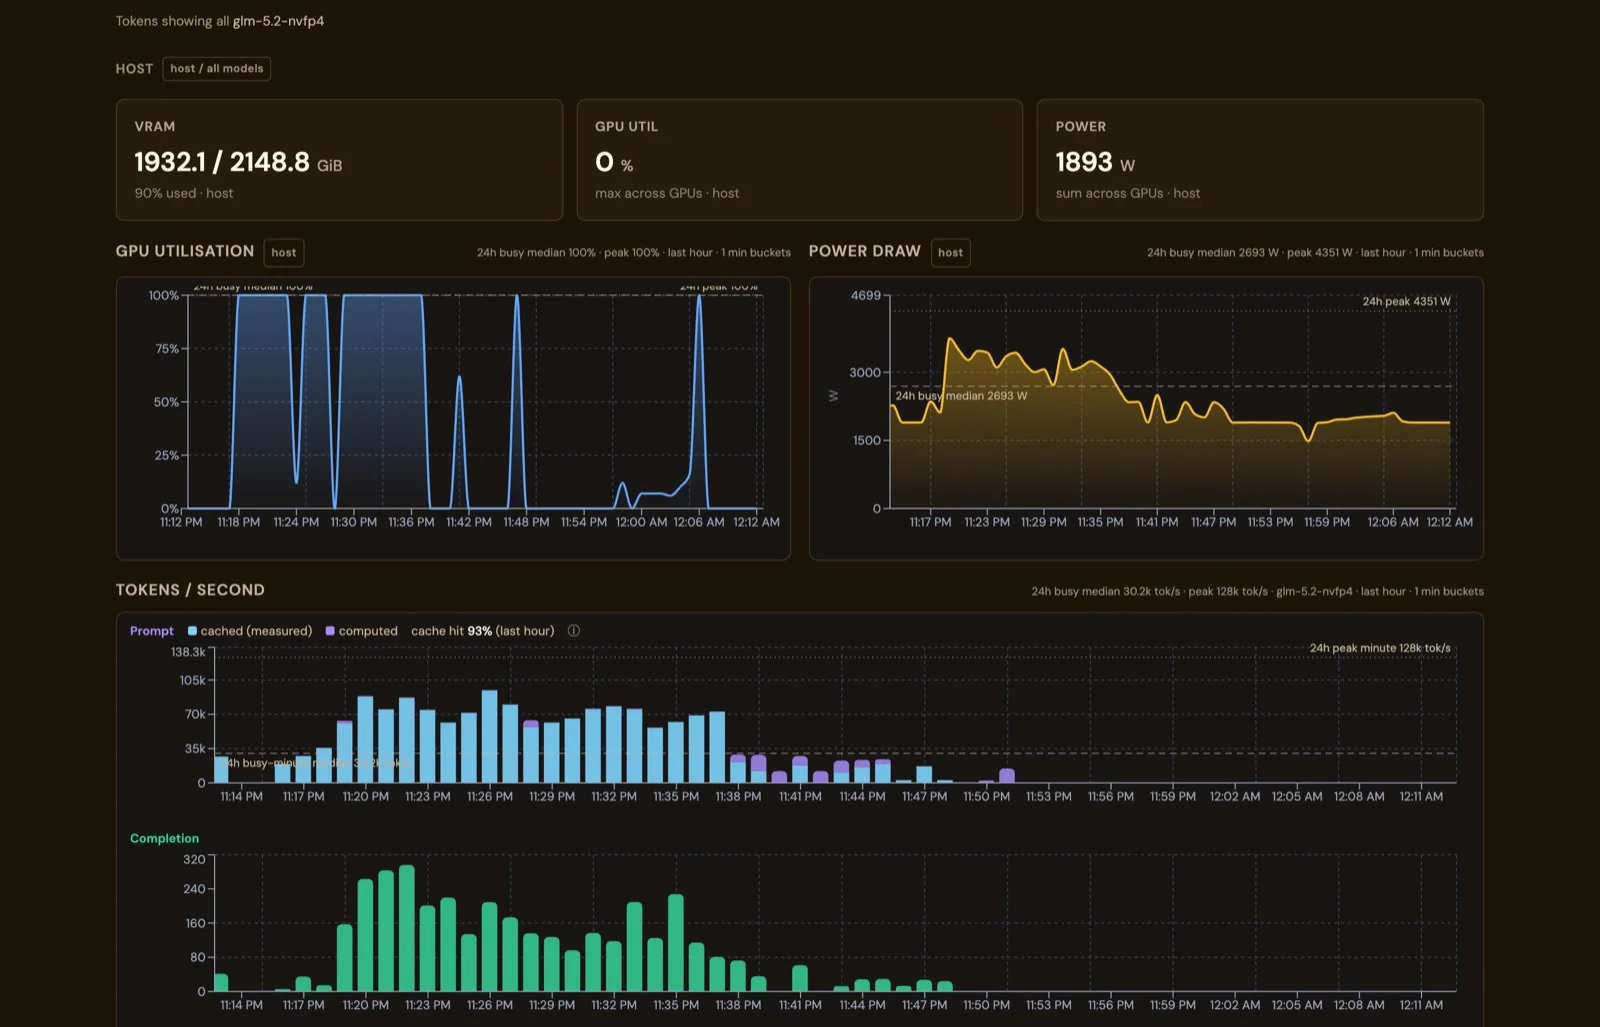
Stats на сервере 8 × B300: VRAM 1 932,1 из 2 148,8 ГиБ, энергопотребление 1 893 Вт суммарно по картам, загрузка GPU и энергопотребление за последний час, а также токены промпта в секунду с разделением на кэшированные и вычисленные при 93 % попаданий в кэш
Та же страница Stats на самом мощном оборудовании: 1 932 из 2 149 ГиБ VRAM, 1 893 Вт по всем картам, пик 4 351 Вт за час и 93 % токенов промпта из кэша.
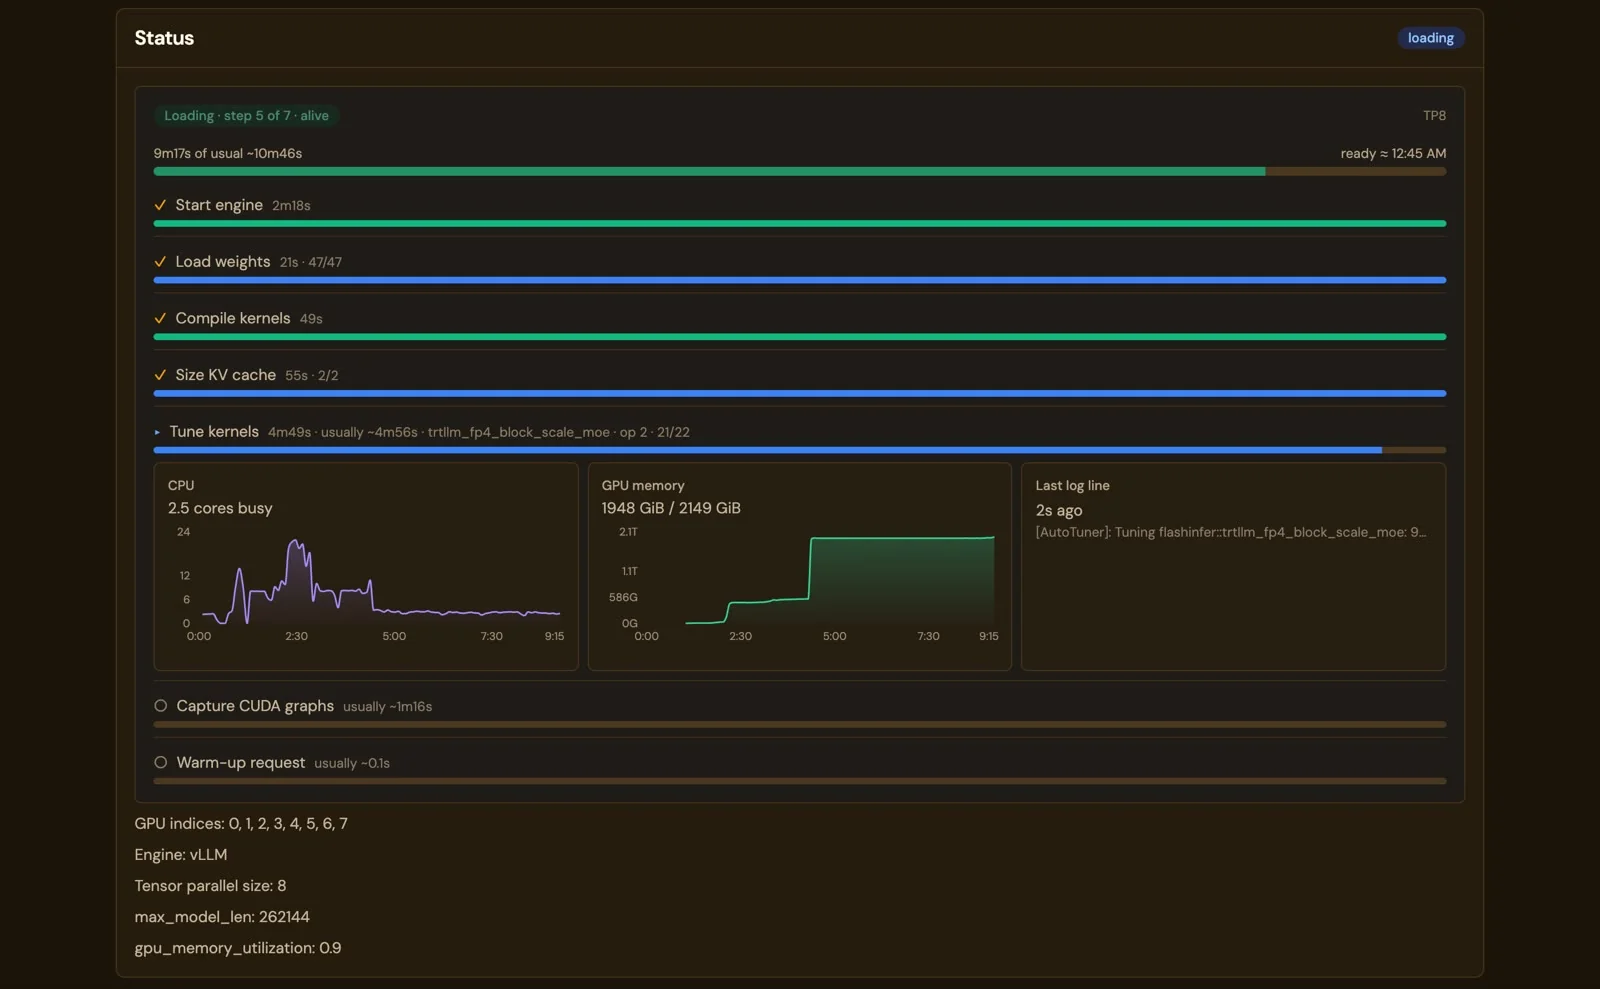
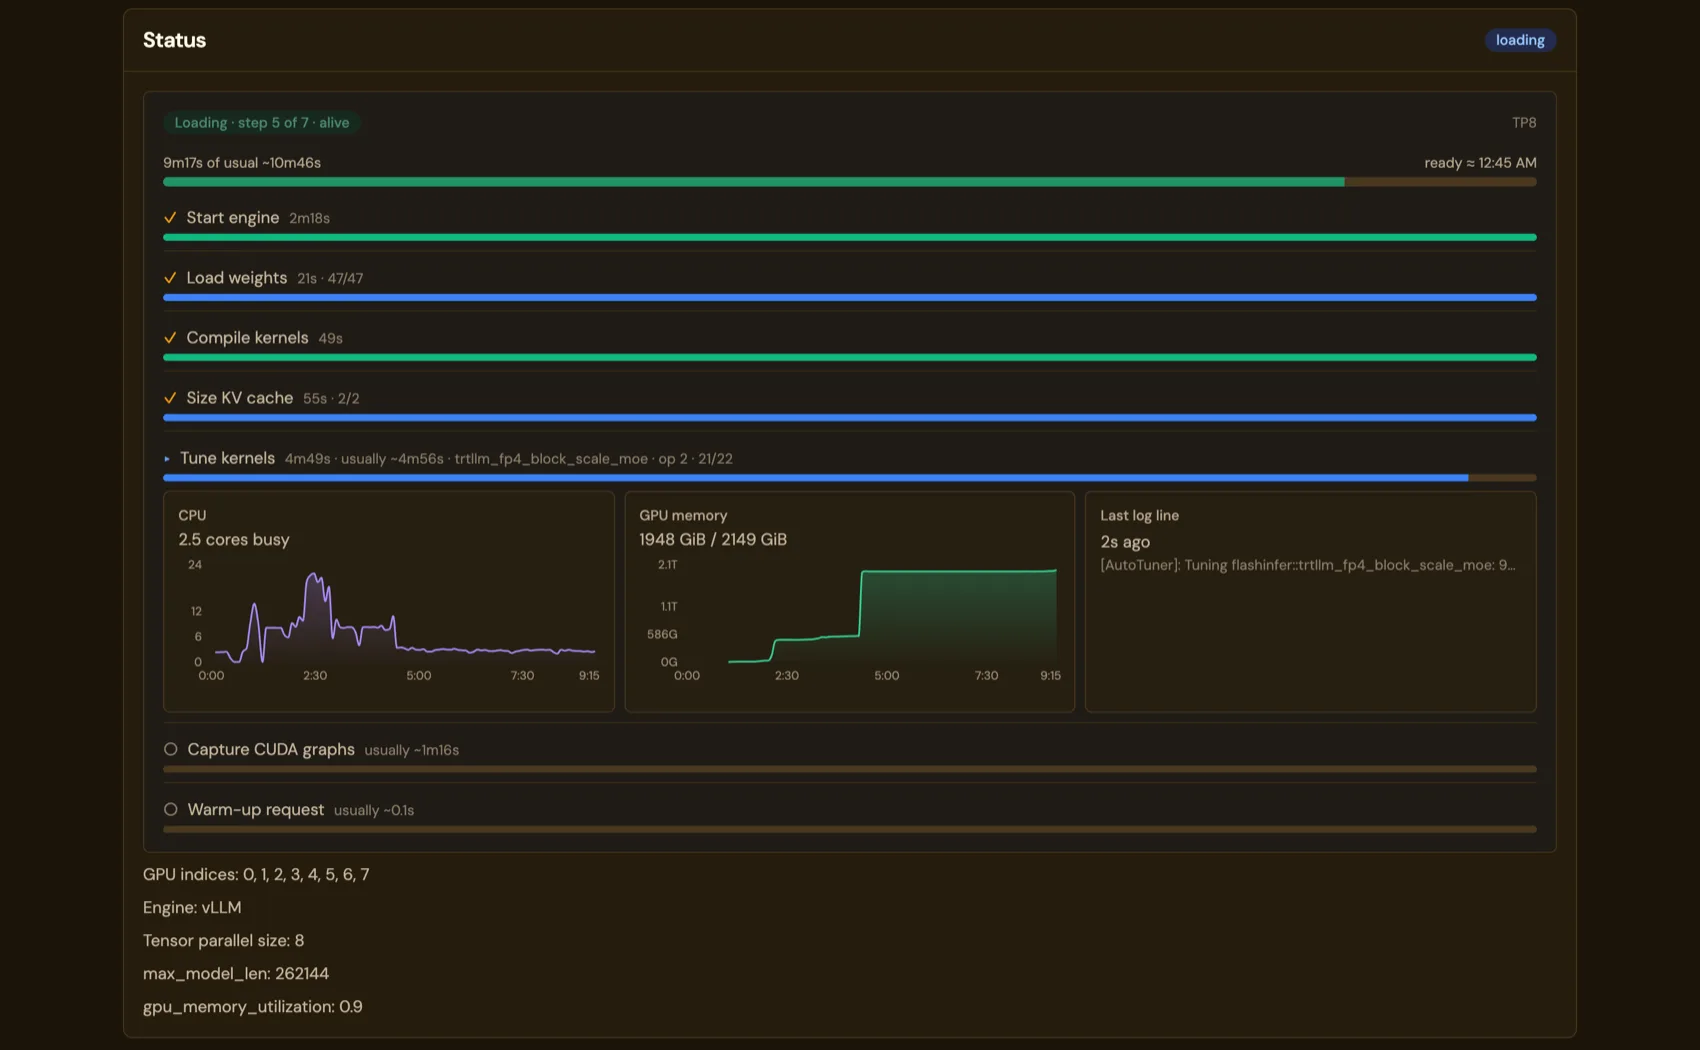
Страница модели во время загрузки GLM-5.2 NVFP4 на восемь B300: прошло 9 мин 17 с из обычных 10 мин 46 с, шаги Start engine, Load weights 47 of 47, Compile kernels и Size KV cache выполнены, Tune kernels на операции 21 из 22, с графиками CPU и памяти GPU и последней строкой журнала
10-минутная загрузка по шагам: GLM-5.2 NVFP4 на восемь B300, прошло 9 мин 17 с из обычных 10 мин 46 с. Пока загрузка продвигается, ничего не подсвечивается красным.

Что показывает панель каждой карты: температуру относительно ее собственного порога троттлинга, энергопотребление относительно лимита мощности, частоты, вентилятор, текущие поколение и ширину канала PCIe, ECC и NVLink, если они есть у карты, и процесс, занимающий память. Схема соединений строится по выводу nvidia-smi topo -m. На Mac — загрузка GPU и бюджет памяти, о котором сообщает Metal, без данных об энергопотреблении. Состояние самого движка LM Warden проверяет через его собственный /health, а не по таблице процессов: если движок перестал работать, а процесс-обертка еще жив, движок перезапускается, а диагностические данные сохраняются.

Что вы увидите

Мониторинг GPU

Каждая карта — со своими показателями.

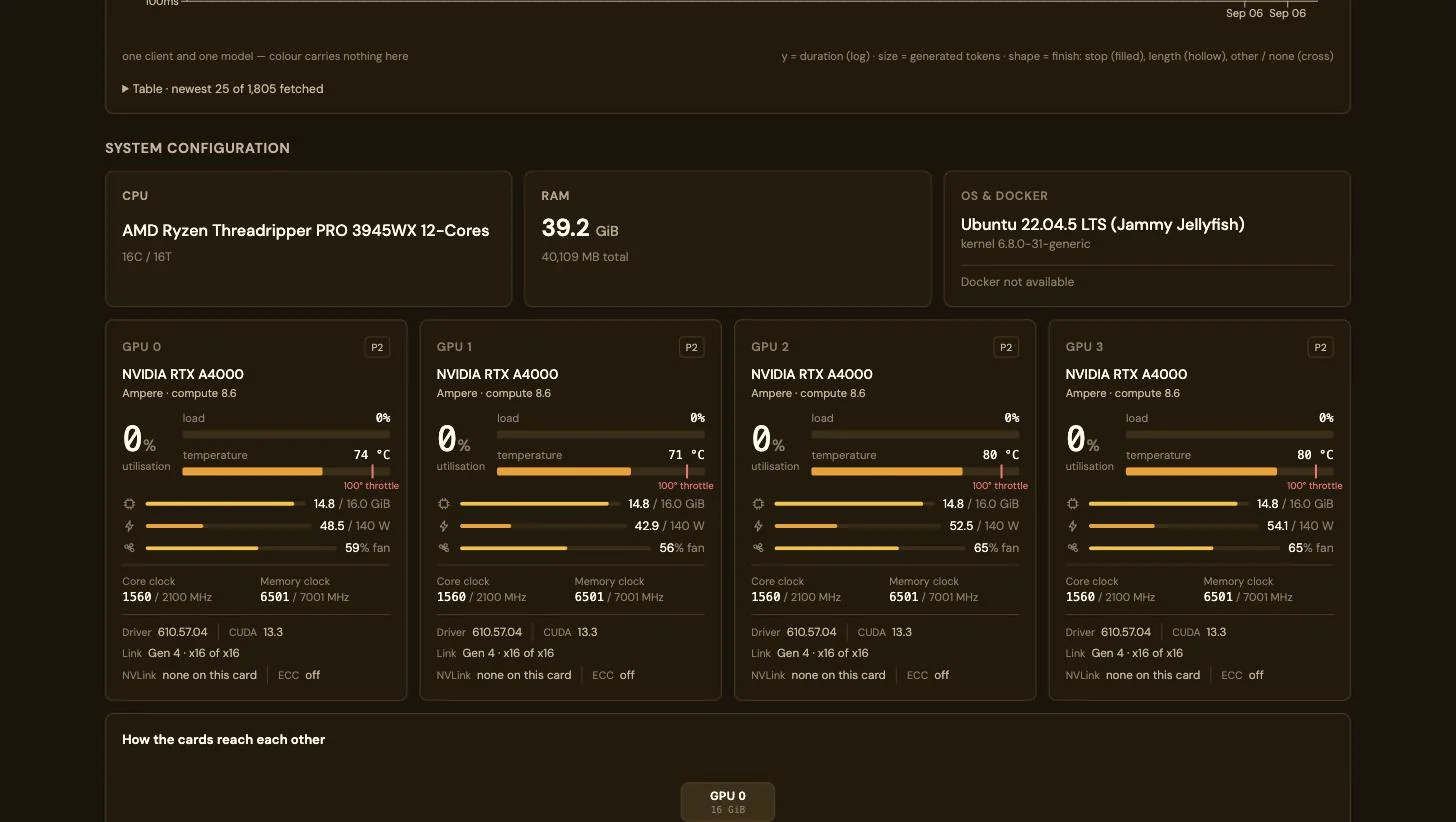
Загрузка GPU, температура относительно порога троттлинга именно этой карты, энергопотребление относительно ее лимита мощности, VRAM, частоты, канал PCIe и процесс, который занимает память, — по каждой карте, а не в среднем по серверу.

Конфигурация системы и четыре панели GPU для карт NVIDIA RTX A4000: загрузка, температура, VRAM, энергопотребление, вентилятор и частоты каждой карты

Выполняющиеся запросы

Что каждый агент делает прямо сейчас.

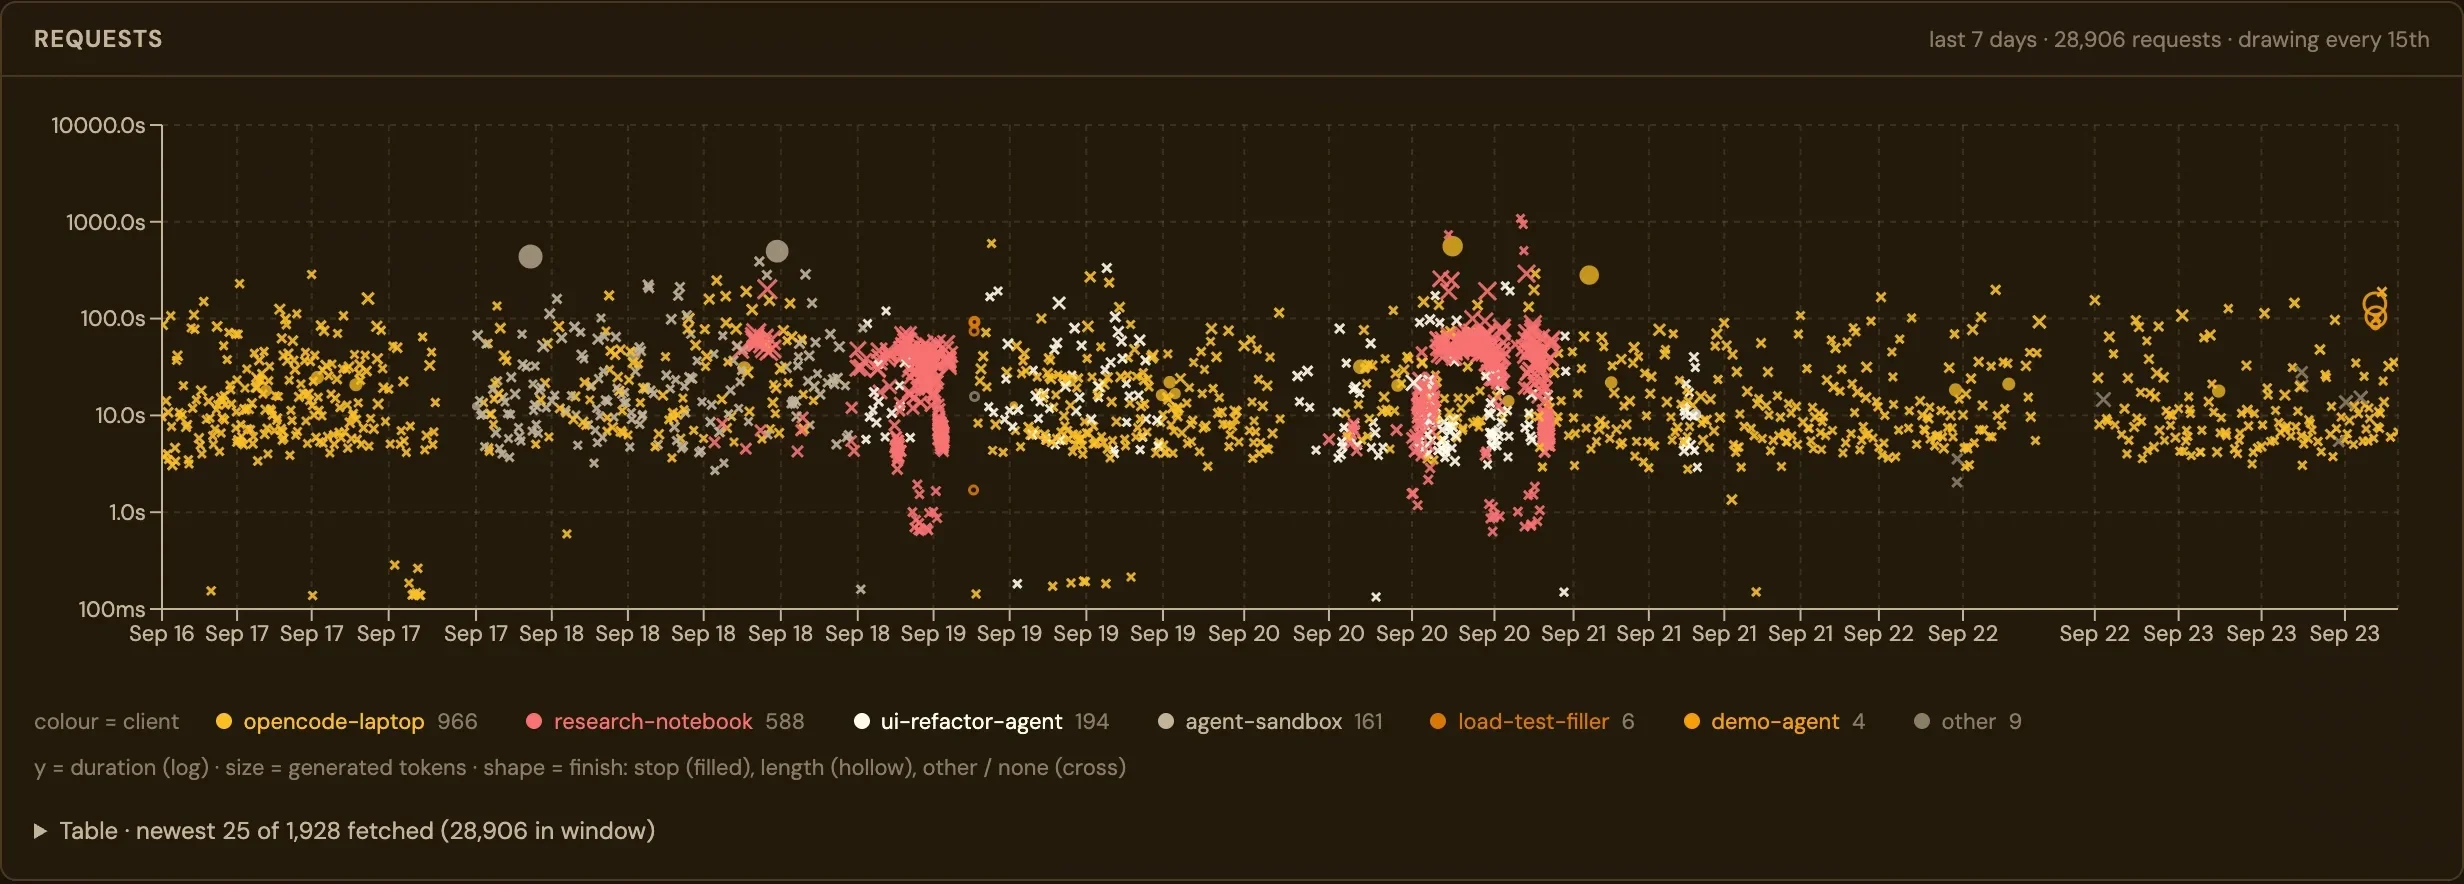
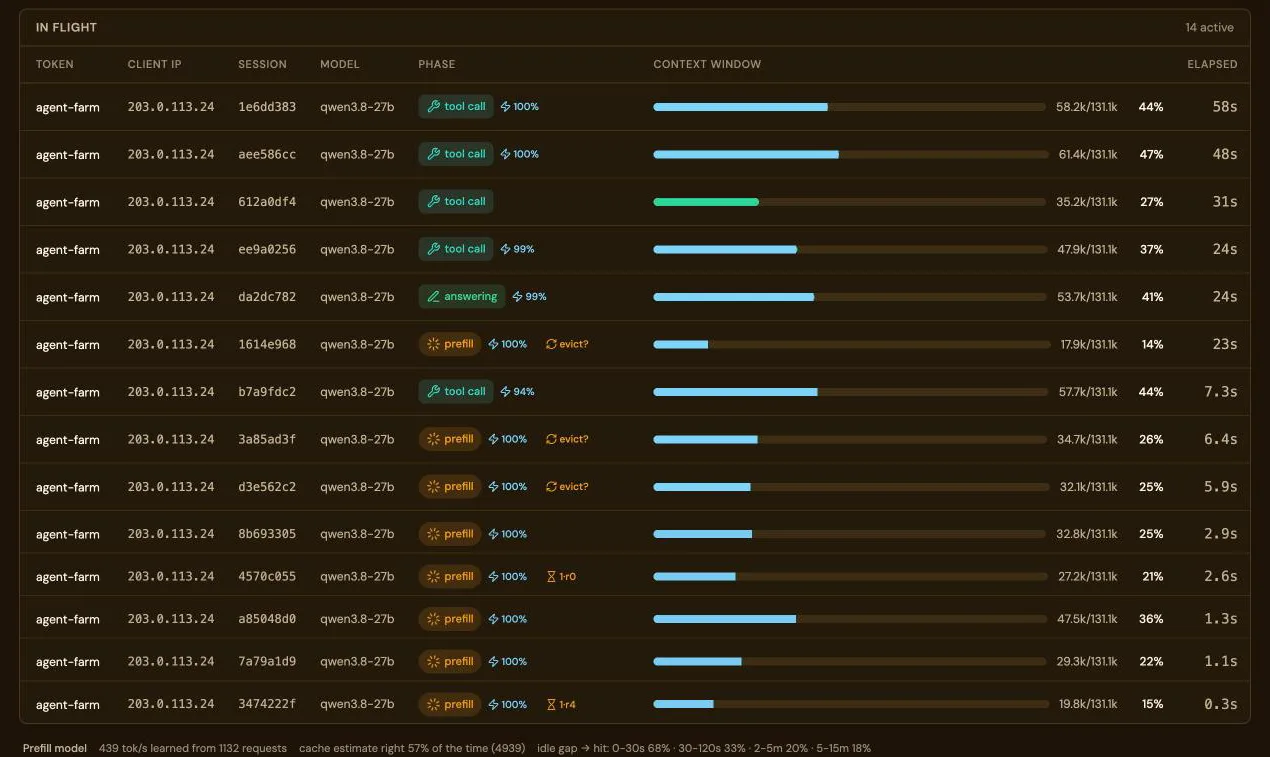
Каждый запрос с ключом, сессией и фазой: в очереди, prefill, размышление, вызов инструмента, ответ. Для каждого запроса измеряется, какая часть промпта взята из кэша префиксов.

Таблица выполняющихся запросов: десять активных запросов, у каждого ключ, сессия, фаза и токены

Агенты для программирования

Claude Code, Codex и OpenCode подключаются с одной страницы.

Connect создает конфигурацию каждого инструмента с адресом этого сервера LM Warden, ключом и загруженной моделью, сверяет требования с тем, что действительно загружено, и отправляет тестовый запрос.

Страница Connect a client с выбранным Claude Code и проверенными требованиями

Бесплатно, с открытым кодом, разработка ведется открыто.

LM Warden распространяется по лицензии Apache-2.0 на GitHub: скрипт установки и файл Compose — это и есть все развертывание, и оба открыты для проверки. Без регистрации, без проверки лицензии, без телеметрии. vLLM, llama.cpp и MLX — сторонние проекты, которые мы запускаем без изменений.

mlx-rust-lm скоро

Порт mlx-lm от Apple с Python на Rust поверх официальных привязок Apple mlx-c — отдельный проект с открытым исходным кодом, который разрабатывает и поддерживает команда LM Warden. LM Warden будет использовать его как третий движок для Mac, и со временем он заменит движок mlx-lm на Python, который сейчас занимает большую часть дистрибутива для Mac. Это неофициальный проект, не связанный с Apple.