LM Warden

Twoje karty GPU działają jak hostowane API.

LM Warden uruchamia vLLM, llama.cpp lub MLX na twoim własnym sprzęcie i udostępnia je przez jeden wspólny port zgodny z OpenAI: osobny klucz dla każdej aplikacji, statystyki użycia każdego klucza i panel na żywo dla każdej karty GPU. Na komputerze z systemem Linux i kartami NVIDIA albo na Macu z procesorem Apple.

Otwarty kod, Apache-2.0Bez konta i bez telemetriiLinux + NVIDIA · macOS (beta) · wkrótce Windows

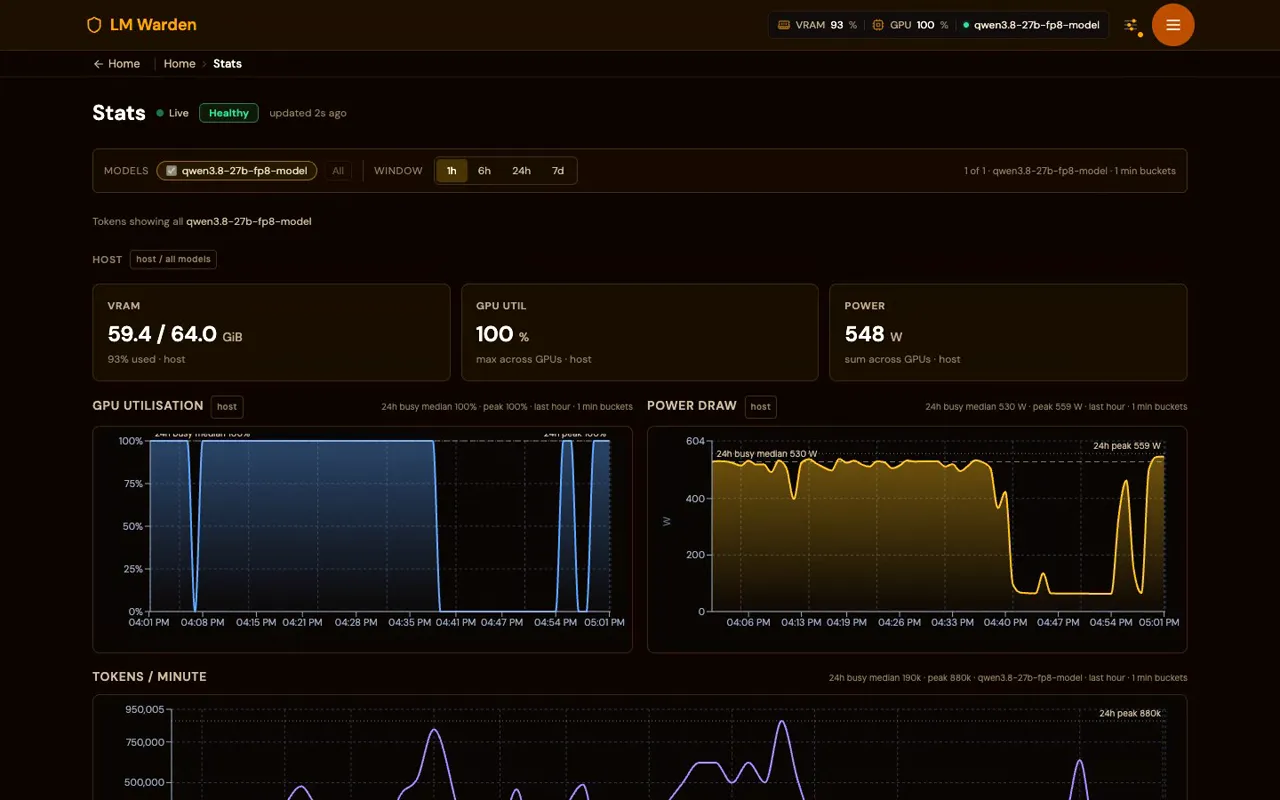
Strona Stats obciążonej instancji LM Warden: VRAM 59,4 z 64 GiB, wykorzystanie GPU 100%, moc 548 W oraz wykresy wykorzystania GPU, poboru mocy i tokenów na minutę z ostatniej godziny
  • Linux · NVIDIA vLLM v0.32.0 i llama.cpp b11719 na CUDA
  • macOS · procesor Apple MLX i llama.cpp na Metal
  • Interfejsy API OpenAI, Anthropic Messages i Responses na jednym porcie
  • Agenci do kodowania Claude Code, Codex CLI, OpenCode i 7 innych z gotową konfiguracją

Do czego ludzie go używają

Gdzie go uruchomisz?

Wybierz platformę powyżej, aby zobaczyć jej kroki, lub pokaż wszystkie cztery.

Jedno polecenie na hoście z GPU.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • Host x86_64, Docker Compose v2.24+, NVIDIA Container Toolkit, karta Turing lub nowsza.
  • Następnie otwórz http://HOST:8080/ui/, przejdź kreator pierwszego uruchomienia, dodaj model i utwórz klucz. Twój endpoint to http://HOST:8080/v1.
  • Kilka kart GPU w jednym komputerze: równoległość tensorowa albo jedna replika na kartę z routingiem uwzględniającym cache.
  • Dziś NVIDIA. Obsługa AMD ROCm i kart GPU Intel pojawi się wkrótce; na razie bez dat. Napisz nam, na czym chcesz go uruchamiać: Radeon · Intel.
  • Instalacja · Instalacja offline · Ze źródeł · Aktualizacja
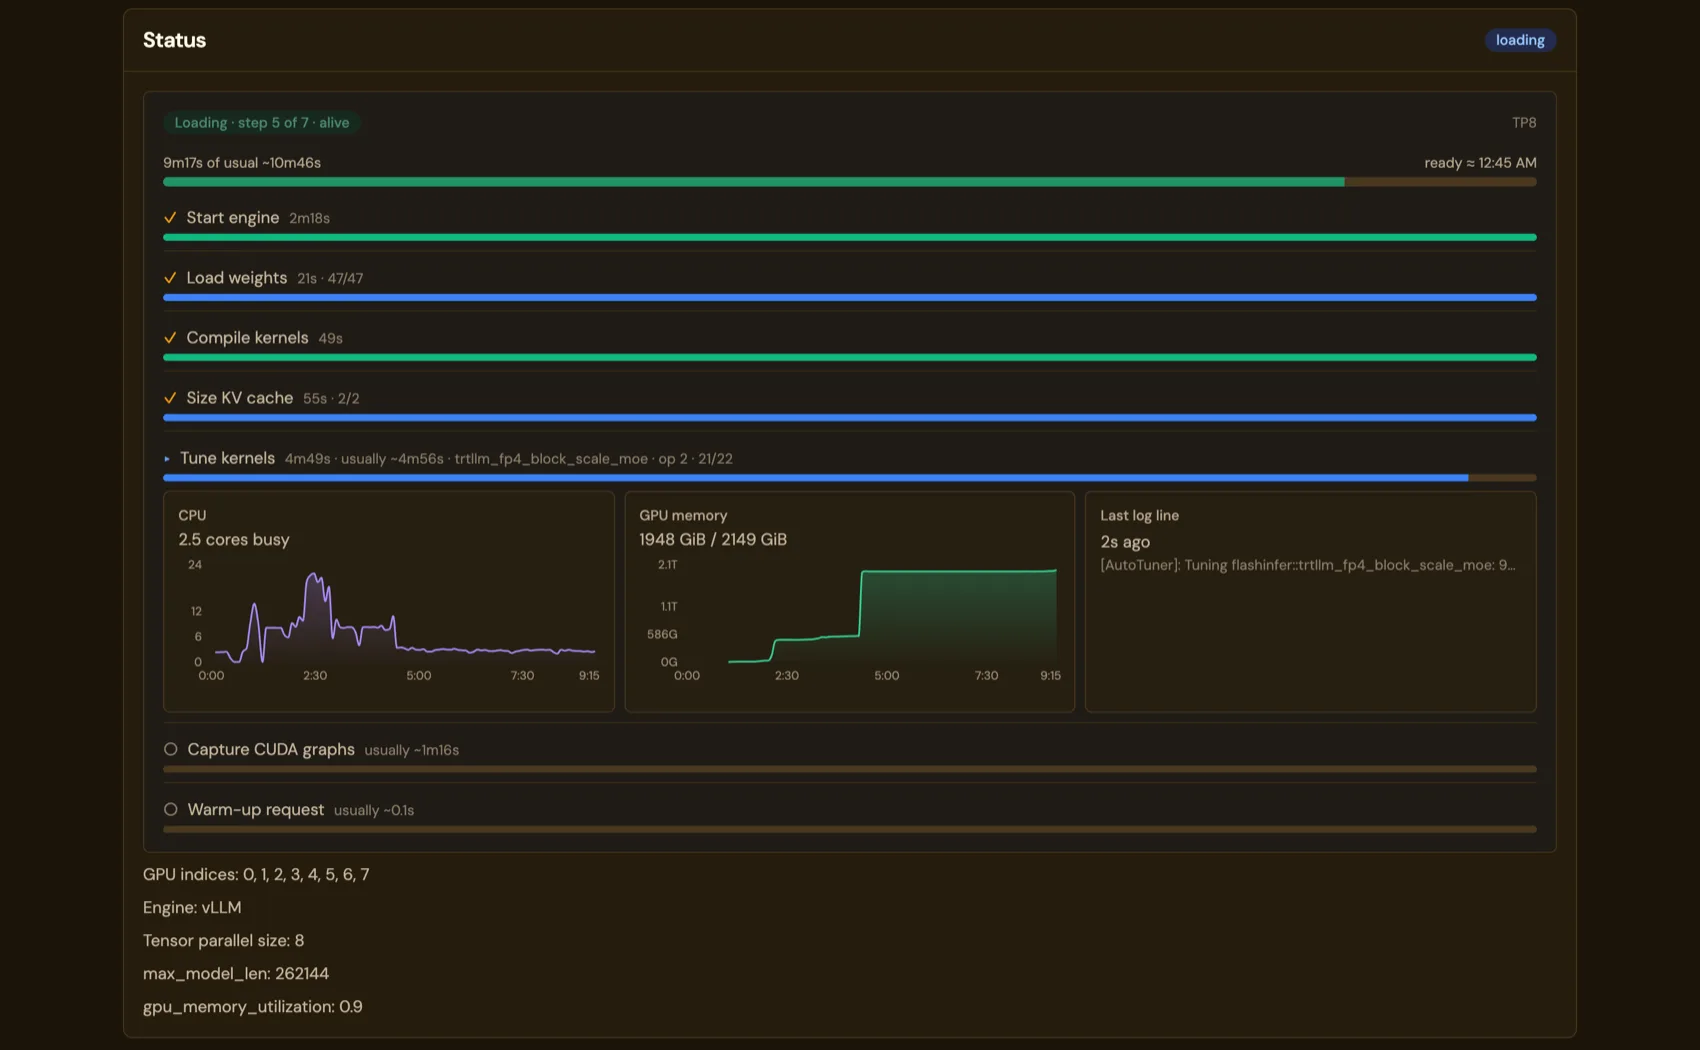
Ładowanie modelu na stronie Models: każdy krok z czasem, który upłynął, i czasem zwykłym
Model ładowany po instalacji: każdy krok ze zwykłym czasem z wcześniejszych ładowań.

Aplikacja na pasku menu, w wersji beta.

Pobierz na komputer Mac (beta)

  • Około 110 MB. Procesor Apple (M1 lub nowszy), macOS 14 lub nowszy. SHA-256 · informacje o wydaniu.
  • Silniki: MLX i llama.cpp skompilowany z Metal. Ten sam pulpit i to samo API OpenAI; bez vLLM, bez odczytu mocy.
  • Co oznacza wersja beta: podpisana ad hoc i nienotaryzowana, więc przy pierwszym uruchomieniu macOS poprosi o zezwolenie w ustawieniach Prywatność i ochrona; każda aktualizacja to ponowne pobranie. Kroki pierwszego uruchomienia.
  • Działa na 127.0.0.1, dopóki nie wybierzesz Share on Local Network.
  • Wkrótce: mlx-rust-lm, trzeci silnik. Zespół LM Warden przenosi mlx-lm firmy Apple z Pythona do Rusta w oparciu o oficjalne wiązania Apple mlx-c; będzie działać obok MLX i llama.cpp, a z czasem zastąpi silnik mlx-lm w Pythonie, który razem z Pythonem i jego bibliotekami stanowi większość dzisiejszego pobrania. Nieoficjalny, niepowiązany z Apple.
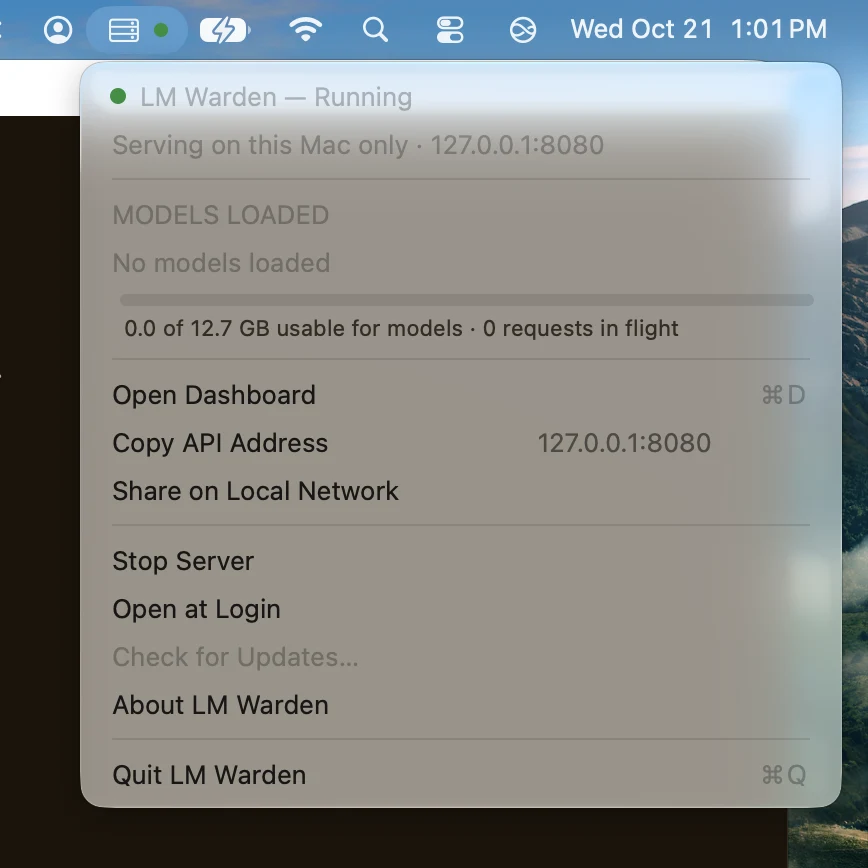
Menu LM Warden na pasku menu Maca: Running, udostępnianie tylko na tym Macu pod adresem 127.0.0.1:8080, brak załadowanych modeli, pasek pamięci, Open Dashboard, Copy API Address, Share on Local Network
Menu wersji beta na pasku menu, na M1 z 16 GB.

Następny będzie Windows. Bez konkretnej daty.

Pracujemy nad nim teraz i opublikujemy tu kompilację w dniu, w którym będzie gotowa, zamiast wcześniej wystawiać formularz zapisu. Do tego czasu masz dwie realne możliwości:

  • Uruchom LM Warden na serwerze z systemem Linux i kartami GPU i korzystaj z niego w systemie Windows: każdy klient OpenAI, Claude Code i Codex łączą się przez sieć.
  • Obserwuj wydania w serwisie GitHub, aby dowiedzieć się o pierwszej kompilacji dla systemu Windows.
  • Karty AMD Radeon i Intel będą później; napisz nam, na czym chcesz go uruchamiać: Radeon · Intel.

Urządzenie: wkrótce, bez daty.

Czwarty sposób uruchamiania LM Warden, dla serwera, który nie powinien robić nic innego.

  • Wkładasz pendrive USB do obudowy z kartami GPU. Instaluje on okrojony Linux, który robi jedno: uruchamia LM Warden.
  • Sam konfiguruje sieć i pamięć masową na modele.
  • Aktualizacje przychodzą przez sieć albo serwer działa całkowicie w sieci odizolowanej (air-gapped).
  • Do bezpiecznego, dedykowanego serwera LLM: dla zespołu, który chce mieć szczelnie zabezpieczony serwer, lub miejsca bez dostępu do internetu.

Do czasu premiery instalacja dla systemu Linux powyżej robi to samo na hoście, który konfigurujesz samodzielnie, łącznie z instalacją offline / w sieci odizolowanej. Obserwuj wydania w serwisie GitHub.

Na razie bez zdjęcia: nie ma jeszcze nazwy produktu ani sprzętu do pokazania, a rysować go nie będziemy.

Już go używasz? W systemie Linux aktualizacja nie wymaga ponownej instalacji: pobierz nowe obrazy, uruchom ponownie, a baza danych zostanie automatycznie zmigrowana do nowej wersji. Kroki · Dziennik zmian.

Samodzielny hosting ma osiem problemów. Oto jak rozwiązujemy każdy z nich.

Sam silnik udostępnia jeden model na jednym porcie. Poniżej wszystko, czego mu brakuje, z naszymi własnymi pomiarami tam, gdzie je mamy.

  1. Czy ten model zmieści się na mojej karcie GPU?

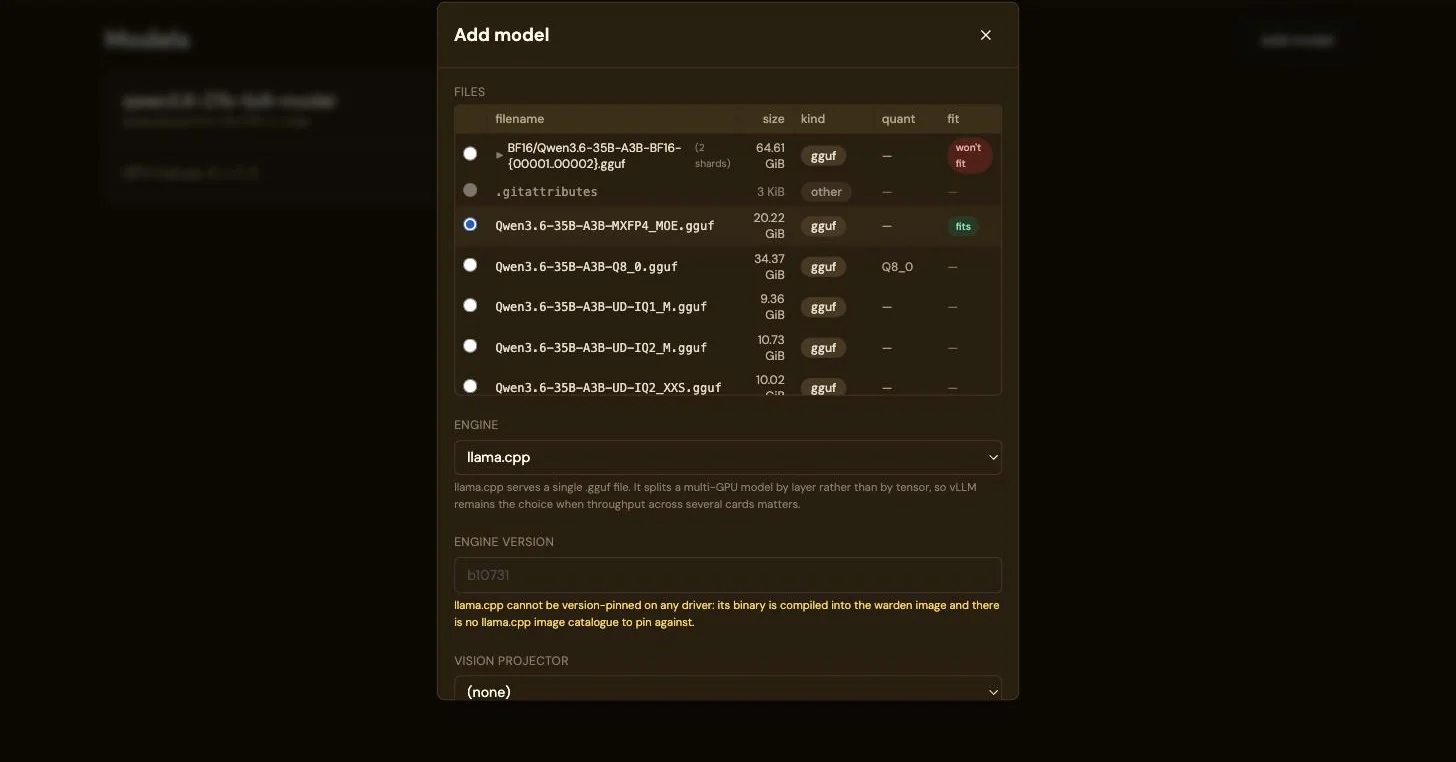
    Wklej repozytorium Hugging Face w Add model. Przy każdym pliku zobaczysz ocenę dla zaznaczonych kart: mieści się, mieści się z małym zapasem albo się nie zmieści. Zaznacz więcej kart, a ich pamięć się zsumuje. Nic nie jest pobierane, dopóki coś się nie zmieści.

    Ten sam plik 20,22 GiB oznaczony jako pasujący po zaznaczeniu czterech kart GPU
  2. Karty GPU już kupione. Czy pracują, czy czekają?

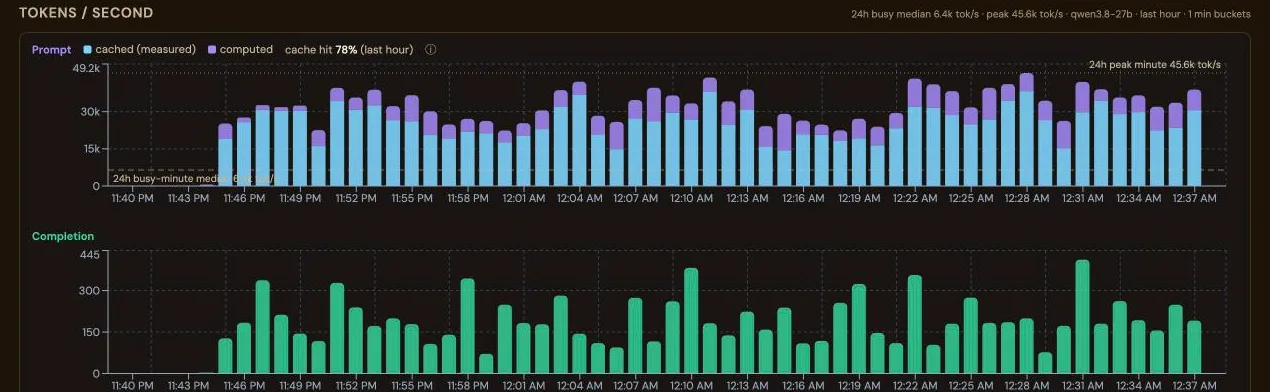
    Przepustowość to współbieżność × długość promptu × ponowne użycie cache, a sam silnik nie pokazuje tych wartości razem. Strona Stats je pokazuje, w zakresie od 1 h do 7 dni: VRAM, wykorzystanie GPU, moc (Linux), tokeny na sekundę z podziałem tokenów promptu na pobrane z cache i obliczone, opóźnienie p50/p95, współczynnik trafień w cache promptów, wywłaszczenia, żądania na klucz i na adres IP klienta. Wykorzystanie, które nie rośnie mimo kolejki, oznacza „więcej współbieżności”; niski współczynnik trafień w cache oznacza „przypnij sesje”.
    Tokeny na sekundę: tokeny promptu z podziałem na pobrane z cache i obliczone, poniżej tokeny odpowiedzi
  3. Porozmawiaj z modelem, zanim cokolwiek podłączysz.

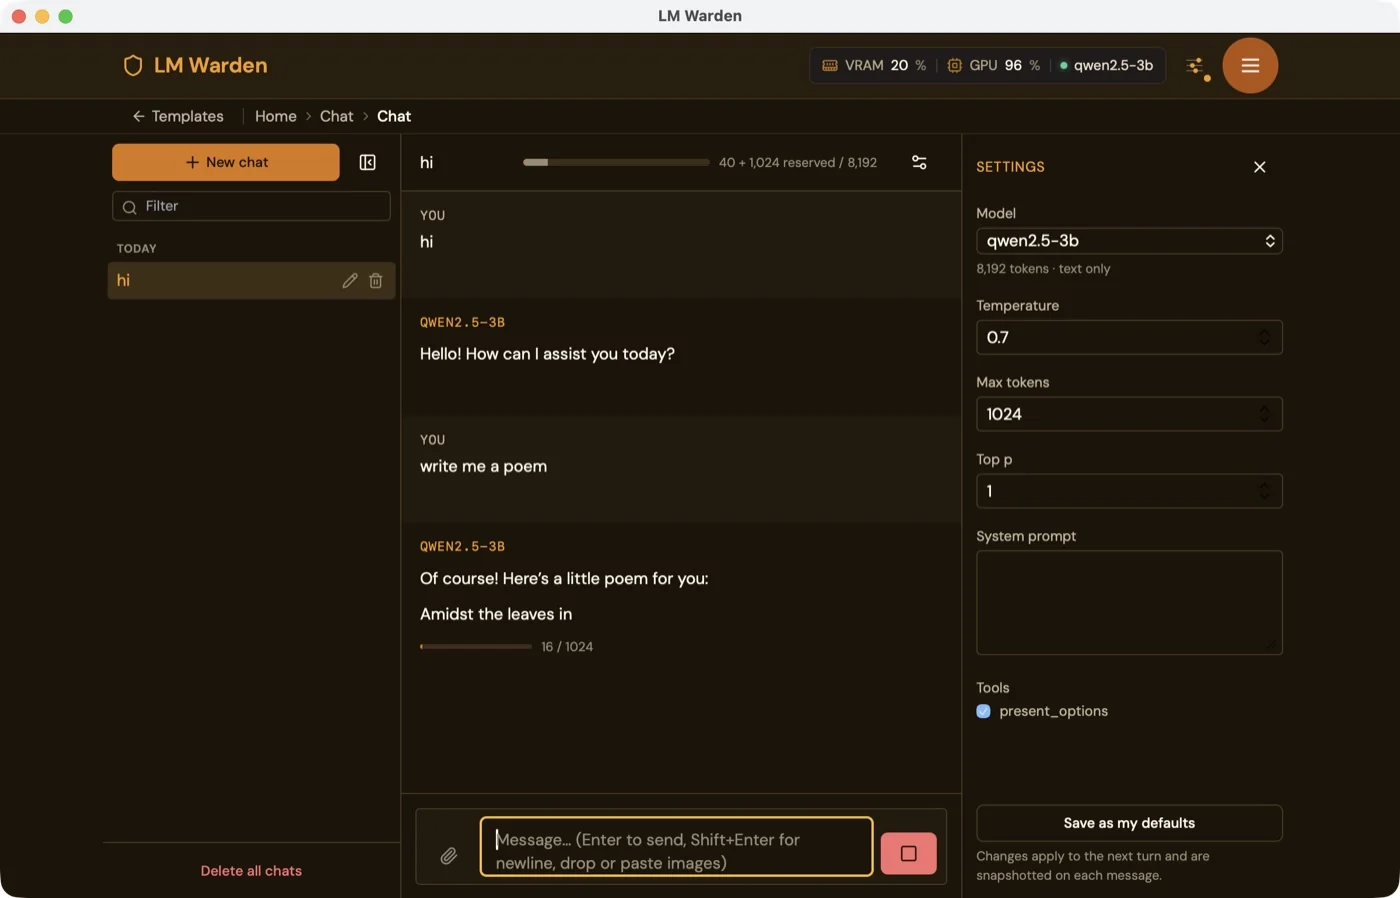
    Czat jest w tym samym oknie co cała reszta. Strumieniowany Markdown z wyróżnianiem kodu i wzorami matematycznymi; do ośmiu obrazów PNG, JPEG lub WebP w wiadomości dla modelu wizyjnego; temperatura, top-p, maksymalna liczba tokenów i prompt systemowy dla każdego czatu, zapisywane jako domyślne; czaty zachowywane, z tytułami, z możliwością rozgałęziania. Wywołania narzędzi wykonywane przez model są wyświetlane, więc możesz sprawdzić wywoływanie narzędzi, zanim agent zacznie od niego zależeć.

    Czat w oknie pulpitu aplikacji na Maca, strumieniowany z qwen2.5-3b, z GPU 96% w nagłówku
  4. Co model naprawdę dostał i co odpowiedział?

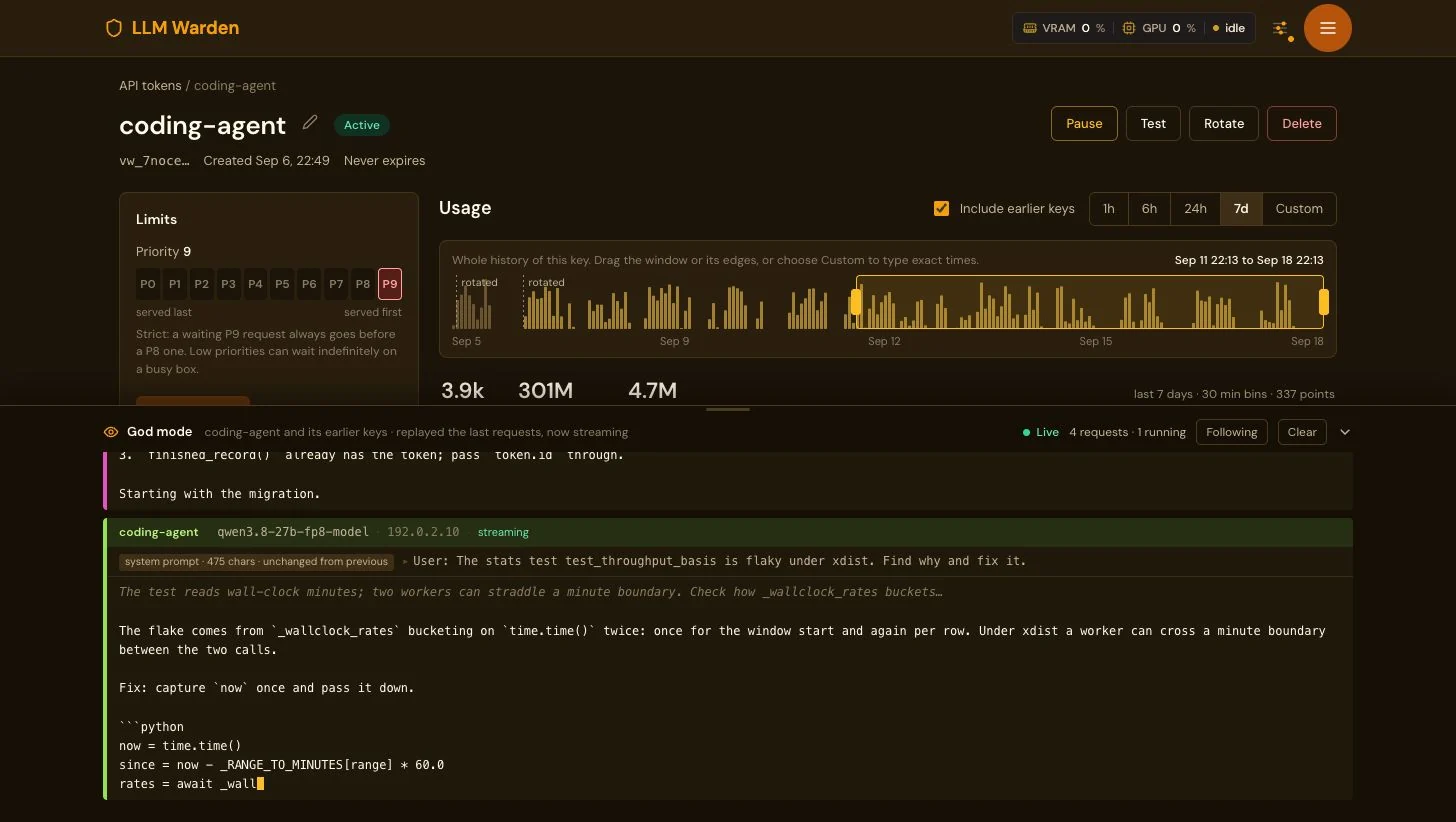
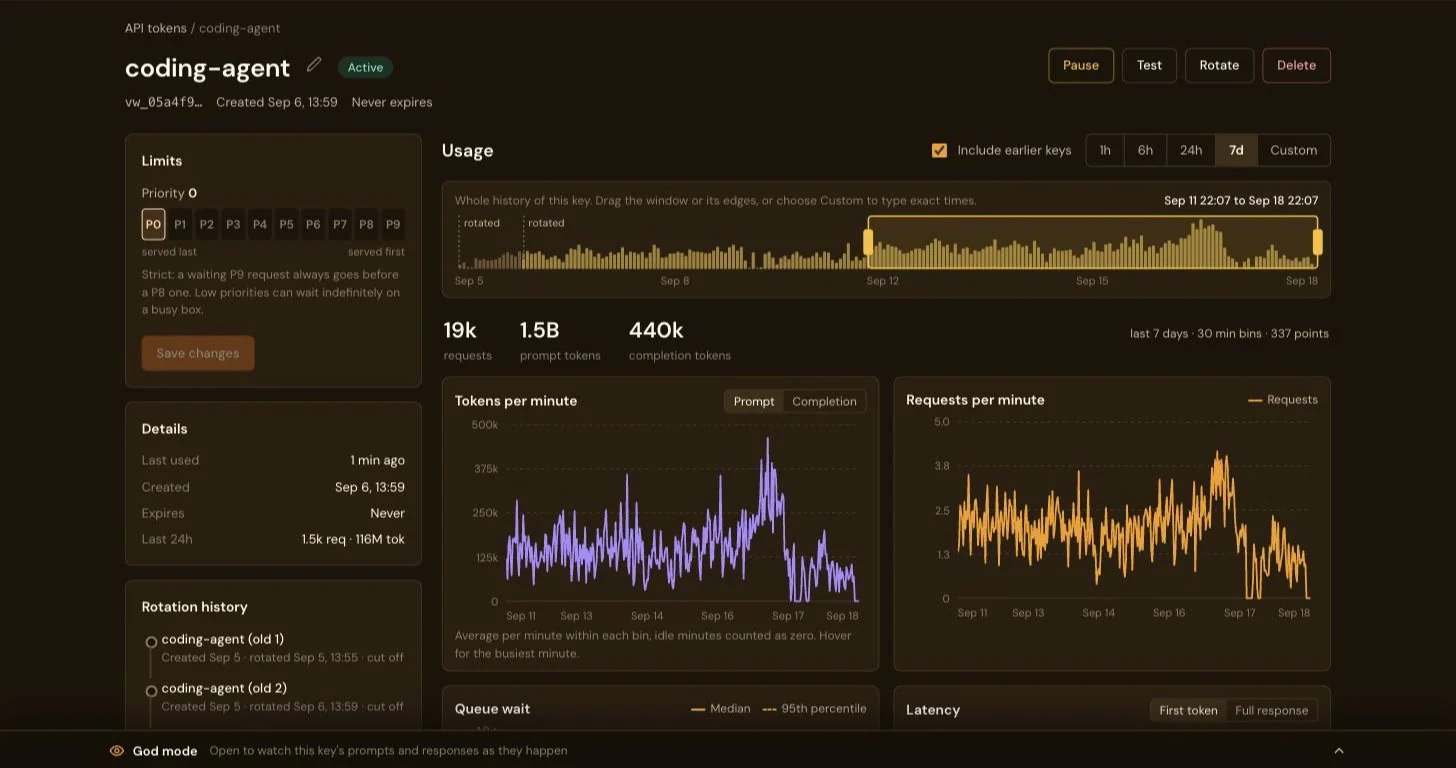
    God mode do debugowania promptów: gdy wdrożenie ma włączone VW_GODMODE_ENABLED, strona każdego klucza dostaje panel, który na żywo strumieniuje prompty i odpowiedzi tego klucza. Domyślnie wyłączony, a gdy jest wyłączony, w ogóle nie pojawia się w interfejsie. Ograniczony bufor cykliczny w pamięci: nic nie trafia do bazy danych ani na dysk, znika po restarcie. Może go otworzyć każdy, kto ma sesję administratora; LM Warden ma jedną rolę administratora i żadnych innych.

    Strona klucza API coding-agent z otwartym na dole panelem God mode: Live, 4 żądania, 1 w toku; strumieniowane żądanie do qwen3.8-27b-fp8 z 192.0.2.10, z promptem użytkownika o niestabilnym teście statystyk i odpowiedzią modelu z poprawką w Pythonie w trakcie pisania

Każda tura agenta ponownie czyta całą rozmowę.

Agent w każdej turze wysyła ponownie całą historię, więc długa rozmowa to głównie prefiks, który silnik już przeczytał. vLLM przechowuje tę pracę w cache prefiksów, ale tylko na replice, która ją wykonała, a jego własny mechanizm równoważenia obciążenia wysyła każdą turę do repliki z najkrótszą kolejką. LM Warden umieszcza każdą nową rozmowę na najmniej obciążonej replice i tam ją utrzymuje, używając identyfikatora sesji, który Claude Code już wysyła. Przenosi żądanie tylko wtedy, gdy replika przekroczy próg przepełnienia.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Cztery tury jednej rozmowy na modelu z czterema replikami. Z mechanizmem równoważenia obciążenia vLLM każda tura przechodzi prefill (wczytanie promptu do cache) prawie od zera na replice, która ją dostała. Z LM Warden rozmowa zostaje na replice 2 i prefill obejmuje tylko nową turę. Rysunek mechanizmu, a nie pomiar.

Zmierzone na naszym serwerze z czterema kartami (4 × RTX A4000, Qwen3-4B jako cztery jednokartowe repliki, syntetyczne sesje w stylu Claude Code, koligacja wyłączona, a potem włączona, jedna po drugiej): przy przypiętych rozmowach udział tokenów promptu obsłużonych z cache wzrósł z 56 do 86% przy 4 równoczesnych sesjach, a mediana czasu do pierwszego bajtu spadła z 2,05 do 0,38 s. Liczba tokenów wyjściowych na minutę była wyższa na każdym przeprowadzonym etapie, a czas do pierwszego bajtu p95 (najwolniejsze 5%) był niższy na każdym etapie. Liczba pracujących replik prawie się nie zmieniła (2,71 wobec 2,83 z czterech przy 4 sesjach): zysk to ponowne użycie cache, a nie więcej pracujących kart.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Współczynnik trafień w cache prefiksów na każdym etapie: stosunek tokenów promptu obsłużonych z cache do wszystkich żądanych tokenów promptu, łącznie dla czterech replik, na podstawie zmiany własnych liczników vLLM w danym etapie. Zysk utrzymuje się, dopóki jest zapas, i znika przy 32 sesjach, gdy rozmowy przechodzą na inne repliki.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Czas do pierwszego bajtu przy 4–32 równoczesnych sesjach, mediana i p95, w skali logarytmicznej, aby etapy poniżej sekundy dało się odczytać obok tych trwających minutę. Z koligacją mediana jest znacznie niższa do 16 sesji (0,38 wobec 2,05 s przy 4) i wyższa przy 24 i 32; p95 jest niższy na każdym etapie, choć przy 16 różnica (24,9 wobec 26,2 s) mieści się w szumie jednego przebiegu na wariant. Mierzone po stronie klienta, przez internet, do pierwszego strumieniowanego tokenu.

Każdy etap obciążenia, koligacja wyłączona → włączona

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Zmierzone na naszym serwerze z czterema kartami na małym modelu, najpierw z wyłączoną koligacją, potem z włączoną, bez ponownego uruchamiania vLLM pomiędzy: drugi wariant zaczynał z rozgrzanym cache prefiksów, a w obu wariantach prompty losowano z tym samym ziarnem generatora. Każdy etap trwa 3 minuty, więc kończy się w nim tylko od 9 do 31 sesji, a jedna sesja więcej lub mniej zmienia liczbę sesji na godzinę o 20; stabilniejszą kolumną są tokeny wyjściowe na minutę. Twój model, karty i obciążenie będą inne; karta replik na stronie modelu pokazuje te same liczniki dla twojego systemu.

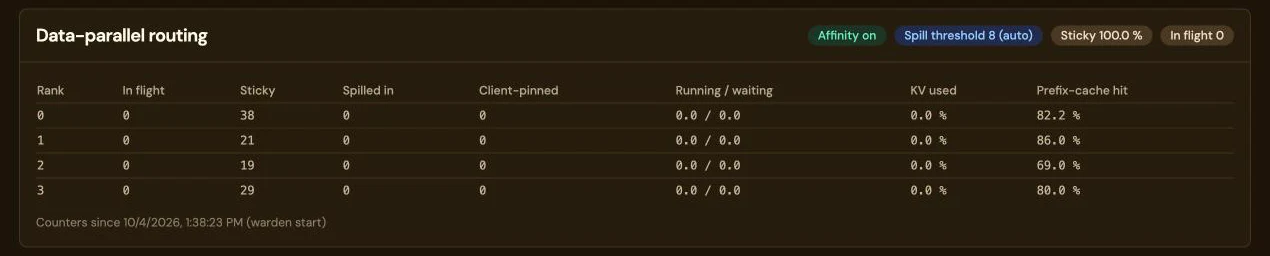
Karta Data-parallel routing na stronie modelu z etykietami Affinity on, Spill threshold 8 (auto), Sticky 100.0% i In flight 0. Tabela zawiera repliki od 0 do 3 z kolumnami in flight, sticky (38, 21, 19 i 29), spilled in, client-pinned, running i waiting, użyciem KV i współczynnikiem trafień w cache prefiksów (82,2; 86,0; 69,0 i 80,0 procent) oraz wiersz informujący, że liczniki działają od uruchomienia LM Warden.
Te same liczniki na stronie modelu: jeden wiersz na replikę z żądaniami, które obsługuje, liczbą rozmów, które zostały (sticky) lub trafiły tu po przepełnieniu innej repliki, tym, co działa i czeka, użyciem cache KV i współczynnikiem trafień w cache prefiksów. Zarejestrowano 4 października 2026 r. z włączoną koligacją i progiem przepełnienia 8 (auto): sticky 100% i współczynnik trafień w cache prefiksów 82,2; 86,0; 69,0 i 80,0% na replikach od 0 do 3. To zrzut panelu, a nie wynik testu. Dotknij obrazu, aby go powiększyć.

Gdzie przegrywa. Etapy z 24 i 32 sesjami to celowe przeciążenie czterech małych kart i każda replika jest nasycona. Liczba tokenów wyjściowych jest nadal wyższa (11 178 wobec 9 048 i 16 638 wobec 14 760 tokenów na minutę), a wolny ogon jest znacznie krótszy (p95 38 wobec 59 s oraz 39 wobec 83 s), ale mediana czasu do pierwszego bajtu jest z koligacją gorsza: 13,1 wobec 5,1 s przy 24 sesjach, 27,7 wobec 12,3 s przy 32. Nie ustaliliśmy przyczyny, a obniżenie progu przepełnienia z 8 do 4 niczego nie zmieniło.

Na obciążonym serwerze zmierz oba warianty. Przewaga jest największa, dopóki jest zapas; serwer pracujący na granicy możliwości powinien zmierzyć oba ustawienia, a koligację można wyłączyć dla każdego modelu osobno. Repliki, a więc i ten routing, są częścią instalacji dla systemu Linux z kartami NVIDIA; aplikacja na Maca (beta) nie ma równoległości tensorowej ani równoległości danych.

Pełna metoda: obciążenie, środowisko testowe, próg przepełnienia i serwer z siedmioma kartami GPU, który od tamtej pory z tym działa →

Skieruj swojego agenta do kodowania na własne karty GPU.

Dziesięć narzędzi łączy się za pomocą bazowego adresu URL i klucza; dwa z nich mogą też zachować płatną subskrypcję Claude do trudnej pracy.

Zachowaj subskrypcję Claude, a rutynowe wywołania przenieś na własne karty

Claude Code i Anthropic SDK przez router. Reguła wskazuje modele Claude, za które odpowiadają twoje karty GPU; wszystko inne trafia do Anthropic z twoimi własnymi danymi logowania lub kluczem.

Dokąd trafia żądanie Claude Code Agent wysyła każde żądanie do routera LM Warden. Żądania do modeli claude-haiku trafiają do modelu na twojej karcie GPU, który odpowiada jako ten model. Każdy inny model, łącznie z Opus, jest przekazywany do Anthropic z twoimi własnymi danymi logowania. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Dokąd trafia żądanie Claude Code Agent wysyła każde żądanie do routera LM Warden. Żądania do modeli claude-haiku trafiają do modelu na twojej karcie GPU, który odpowiada jako ten model. Każdy inny model, łącznie z Opus, jest przekazywany do Anthropic z twoimi własnymi danymi logowania. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
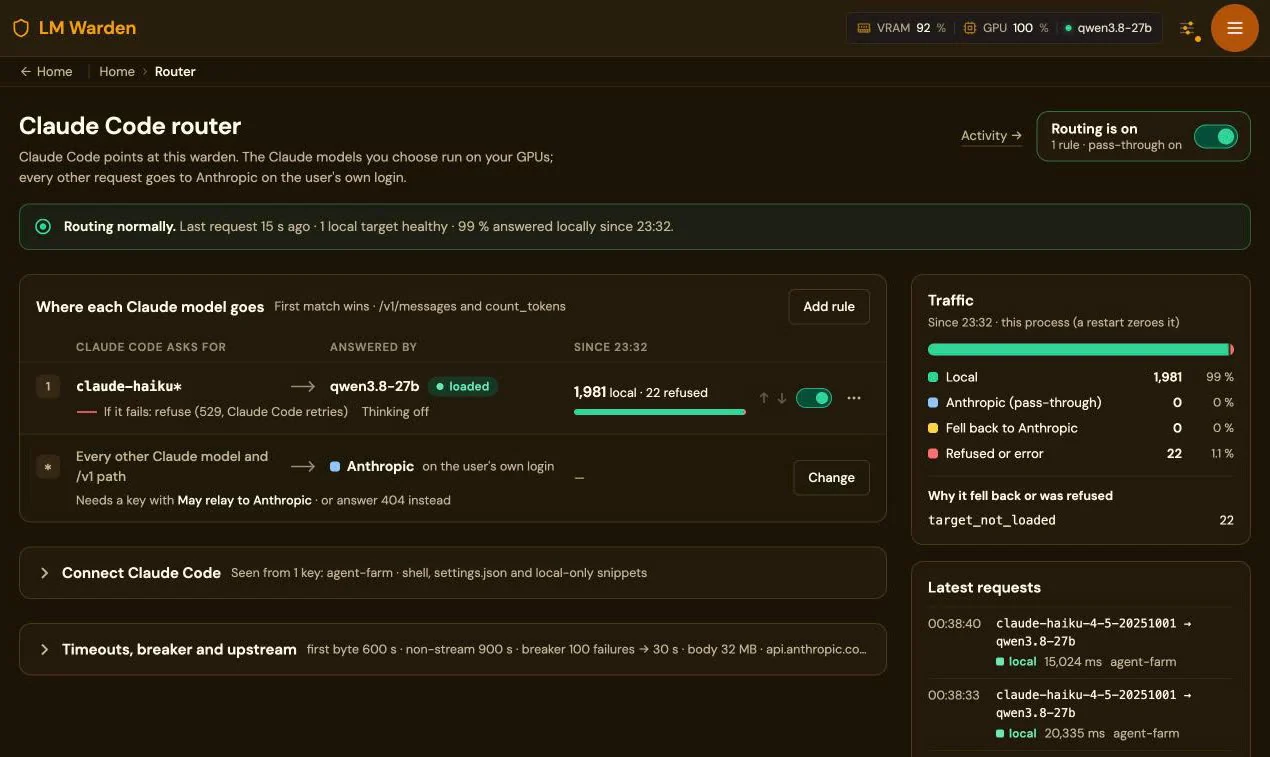
1 981żądań obsłużonych lokalnie, 99% ruchu Claude Code na serwerze od jego restartu. Ze strony Router naszego własnego serwera z siedmioma kartami GPU, 21 października 2026 r.; 22 odrzucone, gdy model docelowy nie był załadowany.
Strona routera Claude Code: routing włączony, 99% obsłużonych lokalnie od 23:32; reguła 1 kieruje claude-haiku* do qwen3.8-27b, 1 981 lokalnie i 22 odrzucone; każdy inny model Claude trafia do Anthropic z własnymi danymi logowania użytkownika
Claude Code 2.1.227 lub nowszy: ANTHROPIC_BASE_URL wskazuje LM Warden, klucz LM Warden trafia do ANTHROPIC_CUSTOM_HEADERS, a twoje logowanie do Claude pozostaje bez zmian. Nie porównywaliśmy jakości odpowiedzi: powierzaj lokalnemu modelowi rutynowe, dobrze określone zadania.

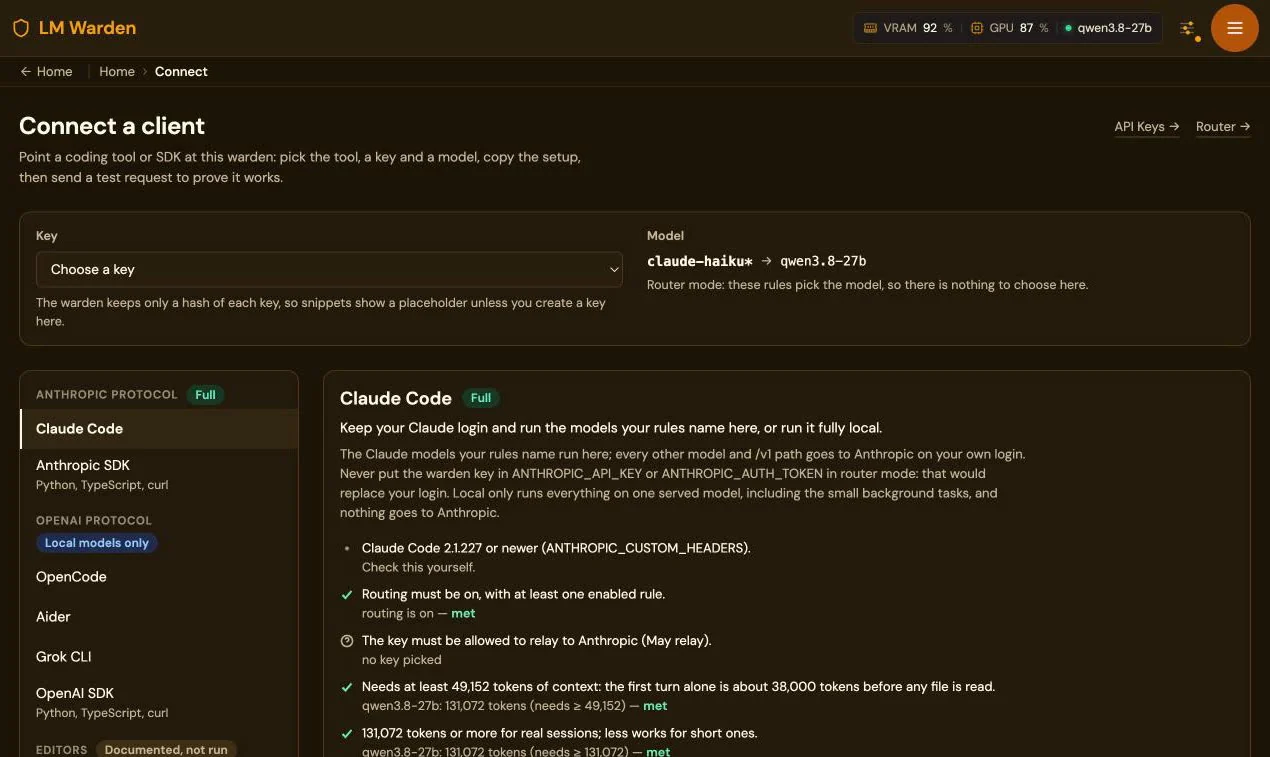
Connect zapisuje konfigurację każdego klienta i wysyła żądanie testowe.

Wybierz w konsoli klienta, klucz i załadowany model; konsola sprawdza każde wymaganie względem tego, co jest faktycznie załadowane (okno kontekstu, wywoływanie narzędzi, włączony router), i daje ci pliki do wklejenia. Wszyscy agenci do kodowania: po jednej stronie na klienta z tym, co działa i co zaobserwowaliśmy.

Strona Connect a client: wybór klucza, reguła routera claude-haiku* do qwen3.8-27b, klienci pogrupowani według protokołu i panel Claude Code ze sprawdzonymi wymaganiami

Niech AI, za które już płacisz, dostroi twoje karty GPU.

Wybór modelu dla twoich kart oznacza wybór kwantyzacji, silnika, podziału między karty GPU, rozmiaru kontekstu i typu cache KV; każda próba kosztuje pobranie i załadowanie. Wszystko, co robi konsola, to wywołanie API, więc Claude Code, Codex lub inny agent z dostępem do powłoki może przeprowadzić to wyszukiwanie za ciebie, na twoim sprzęcie i z twoim obciążeniem.

Pętla

Pętla strojenia Sprawdź karty GPU, wybierz modele z podglądem dopasowania przed jakimkolwiek pobraniem, załaduj kandydujące układy, przetestuj je prawdziwymi żądaniami, dostosuj ustawienia i zostaw załadowany najlepszy wariant. Testowanie i dostosowywanie powtarzają się, dopóki agent nie będzie zadowolony. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner Pętla strojenia Sprawdź karty GPU, wybierz modele z podglądem dopasowania przed jakimkolwiek pobraniem, załaduj kandydujące układy, przetestuj je prawdziwymi żądaniami, dostosuj ustawienia i zostaw załadowany najlepszy wariant. Testowanie i dostosowywanie powtarzają się, dopóki agent nie będzie zadowolony. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

Co wywołuje agent: GET /api/system/gpus, POST /api/models/fit-preview przed jakimkolwiek pobraniem, rejestrację i suggest-config, pobranie i załadowanie, przebieg obciążeniowy, który znajduje i stosuje rzeczywisty limit kontekstu, GET /api/stats/v2/throughput i latency oraz klucz do inferencji, który sam tworzy, aby wysyłać ruch testowy. Najpierw czyta /agent-guide.md, krótki opis tych wywołań napisany dla modelu językowego.

Ładowanie modelu na stronie Models: każdy krok z czasem, który upłynął, i czasem zwykłym
Co agent obserwuje podczas ładowania układu: każdy krok ze zwykłym czasem z wcześniejszych ładowań. Ładowanie, które przestaje postępować, jest zatrzymywane, a jego karty GPU zwalniane.

Cztery prompty do wklejenia i to, co otrzymasz

  1. Przegląd i wybór. Poproś: wypisz moje karty GPU, wybierz trzy modele open-weight do kodowania agentowego, które zmieszczą się z kontekstem co najmniej 65 536 tokenów, sprawdź każdy przez fit-preview, niczego nie pobieraj. Otrzymasz: tabelę z modelem, kwantyzacją, silnikiem, kartami GPU, kontekstem i uzasadnieniem.
  2. Silnik i układ dla jednego modelu. Poproś: zdecyduj, vLLM czy llama.cpp, oraz równoległość tensorowa czy repliki z równoległością danych na moich kartach; załaduj dwa najlepsze układy, wyślij do każdego te same 20 strumieniowanych żądań, porównaj przy współbieżności 1 i 8. Otrzymasz: czas do pierwszego tokenu i tokeny na sekundę dla obu; zwycięski układ zostaje załadowany, drugi zwolniony, a klucz testowy unieważniony.
  3. Znajdź rzeczywiste limity i zastosuj je. Poproś: wykonaj przebieg obciążeniowy załadowanego modelu, zastosuj zmierzony kontekst, a potem przetestuj przy współbieżności 1, 4 i 16 z promptami około 2 tys. i 30 tys. tokenów. Otrzymasz: limit kontekstu zapisany w ustawieniach modelu i tabelę czasu do pierwszego tokenu oraz tokenów na sekundę dla każdej współbieżności i rozmiaru promptu.
  4. Porównaj dwóch kandydatów na własnym obciążeniu. Poproś: odtwórz prompty z ./workload/*.txt na modelu A i modelu B przy współbieżności 4, oceń każdą odpowiedź. Otrzymasz: model-comparison.md z opóźnieniem, tokenami na sekundę, poprawnością według oceny agenta i rekomendacją; rekomendowany model pozostaje załadowany.

Zanim zaczniesz. Token administratora ma pełne uprawnienia administracyjne w LM Warden (modele, klucze, ustawienia; węższych zakresów jeszcze nie ma): nadaj mu krótki czas ważności i unieważnij go w Settings → Access Tokens, gdy zadanie zostanie wykonane. Przebieg obciążeniowy celowo powoduje awarię silnika, aby znaleźć jego limit: uruchamiaj te prompty na instancji, od której nikt inny nie zależy. Pobierane pliki są duże; prompty sprawdzają dopasowanie przed pobraniem, ale pilnuj miejsca na dysku.

Wybór silnika i układu (vLLM, równoległość tensorowa lub równoległość danych) dotyczy instalacji dla systemu Linux; na Macu wybór to MLX lub llama.cpp na jednej karcie GPU. Strojenie może prowadzić model, za który już płacisz; strojony jest model na twoich kartach. Strona o strojeniu przez agenta: cztery prompty w całości.

Jeden serwer z GPU dla całego zespołu, rodziny i twoich agentów.

Utwórz tyle kluczy API, ile potrzebujesz, i rozdaj je: współpracownikowi, członkowi rodziny, zadaniu CI, całej grupie agentów – każdy z własnym kluczem, własnym priorytetem i własną stroną użycia. Sprzęt pracuje dla wszystkich, a ważna praca nigdy nie czeka.

Twój sprzęt bez upiększeń: od Maca po osiem B300.

Ta sama konsola odczytuje M1 z 16 GB, dwie różne karty pod biurkiem i serwer 8 × B300 z NVSwitch, a wąskie gardło wskazuje, zamiast je uśredniać: łącze PCIe działające w trybie x4 zamiast x16, nieaktywne łącza NVLink, ECC różniące się między kartami.

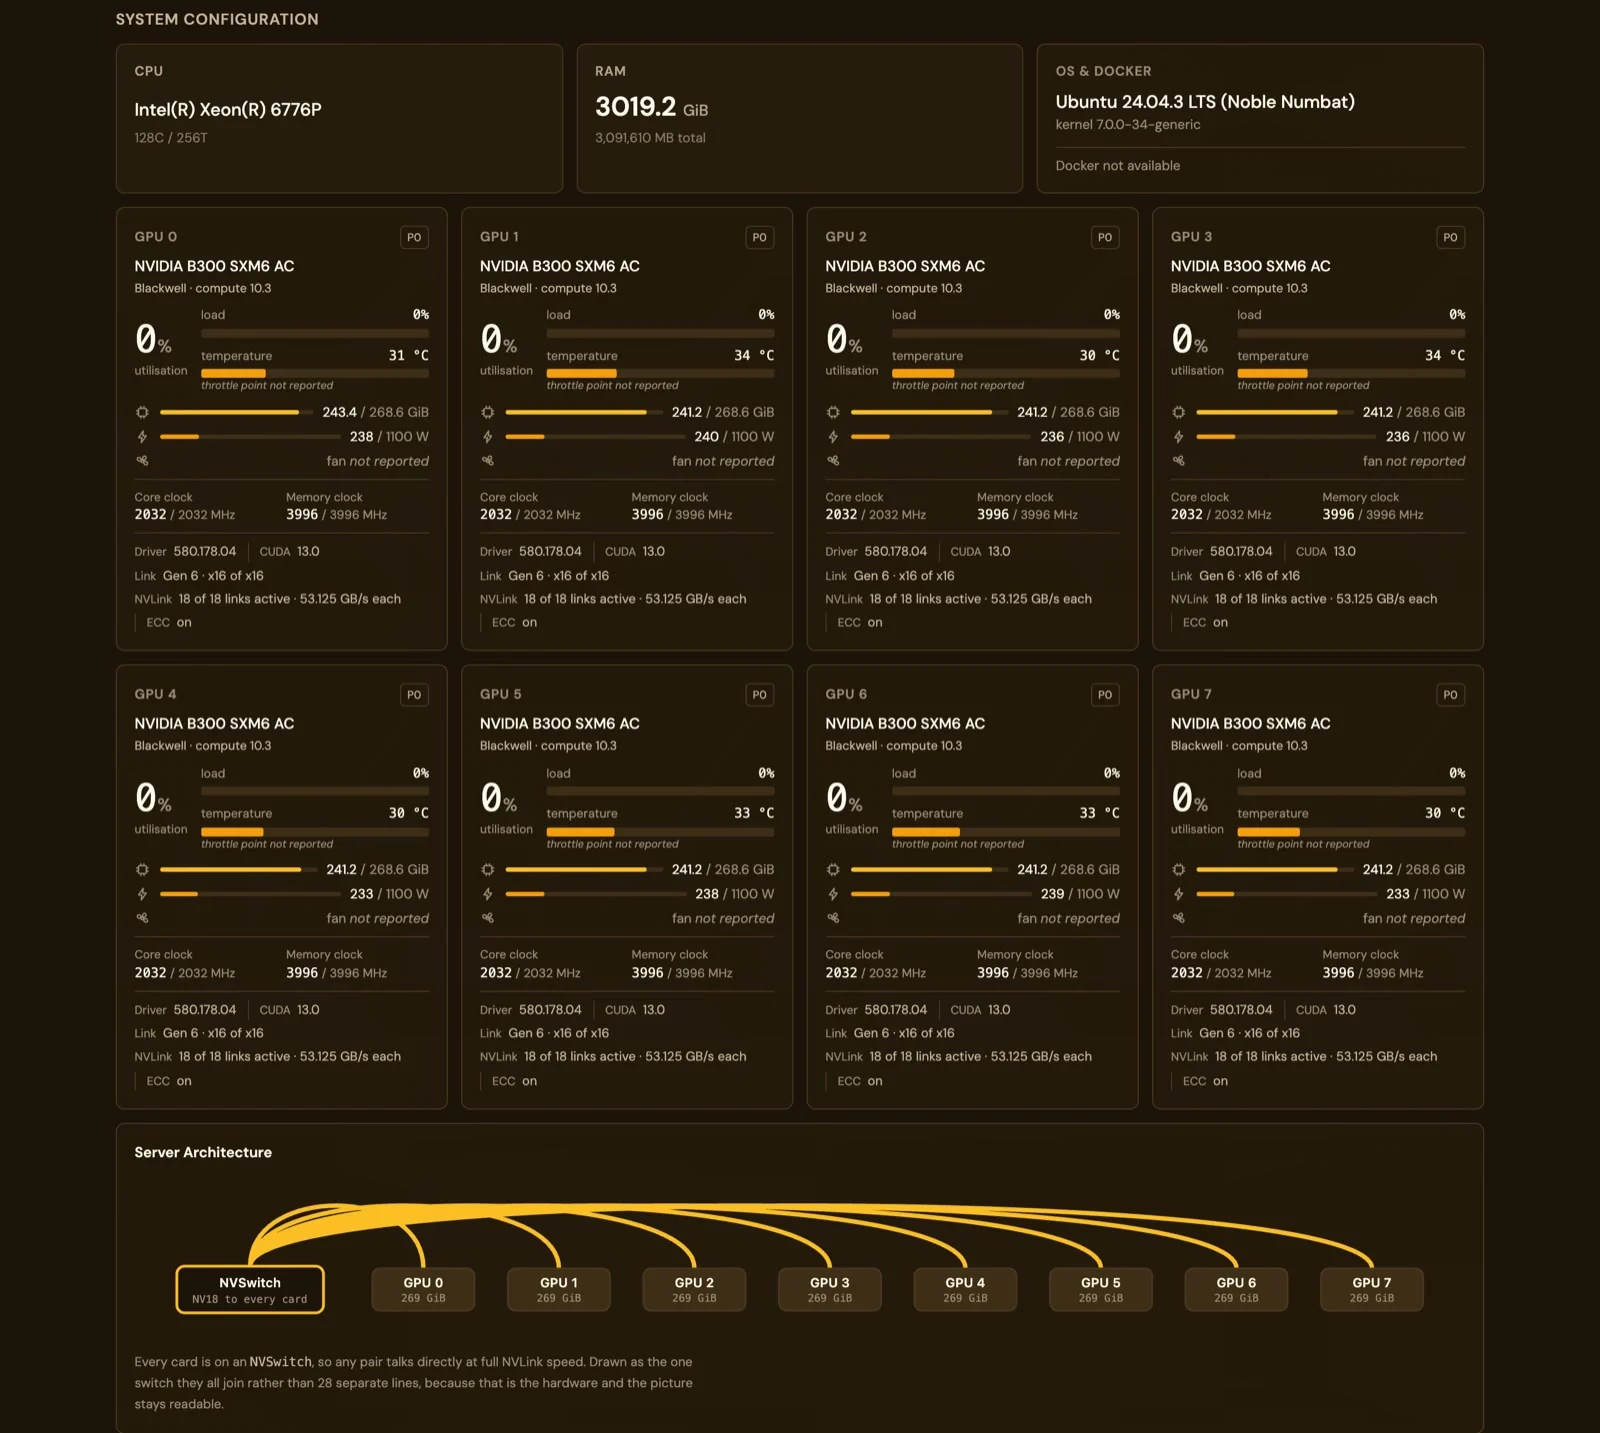
Konfiguracja systemu na serwerze 8 × B300: Intel Xeon 6776P, 3019 GiB RAM, osiem paneli NVIDIA B300 SXM6, każdy z 241 z 268,6 GiB w użyciu, Link Gen 6 x16 z x16, NVLink 18 z 18 łączy aktywnych po 53,125 GB/s każde, ECC włączone oraz rysunek architektury serwera z jednym przełącznikiem NVSwitch połączonym z każdą kartą
Osiem kart B300 SXM6 na jednym NVSwitch: 18 z 18 łączy NVLink aktywnych na kartę, ECC włączone, PCIe Gen 6 x16, 241 z 268,6 GiB w użyciu na kartę podczas udostępniania GLM-5.2 NVFP4 z równoległością tensorową 8.
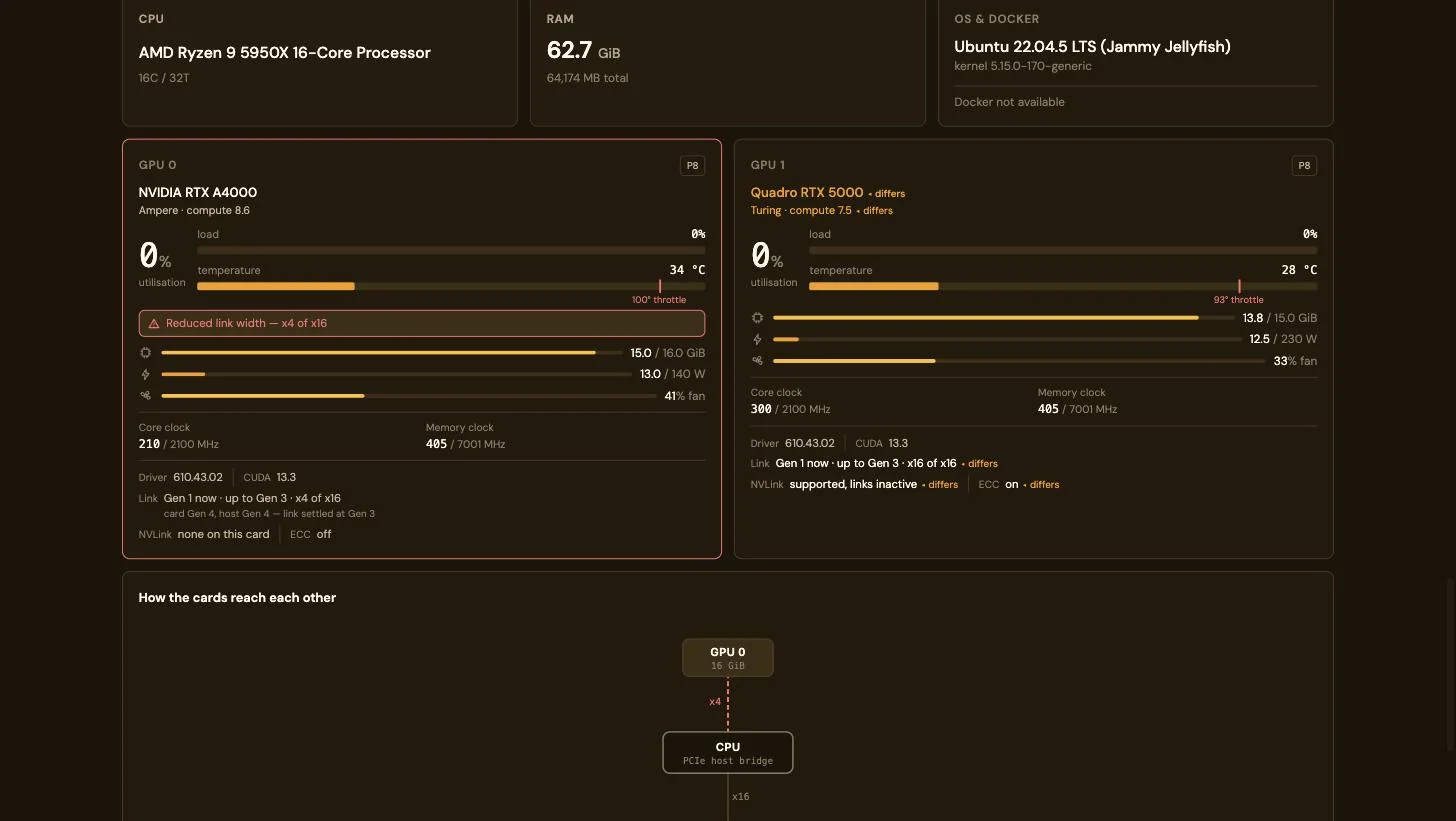
Dwie różne karty GPU: NVIDIA RTX A4000 z czerwonym ostrzeżeniem Reduced link width x4 of x16 i Link Gen 1 teraz, maksymalnie Gen 3, obok Quadro RTX 5000, której architektura, VRAM, limit mocy, łącze, NVLink i ECC są oznaczone jako differs; poniżej rysunek tego, jak karty łączą się z CPU przez łącza x4 i x16
Dwie karty kupione w odstępie lat: łącze A4000 działa w trybie x4 zamiast x16 i jest oznaczone na czerwono; architektura, limit mocy, NVLink (obsługiwany, łącza nieaktywne) i ECC karty Quadro są oznaczone jako differs. Rysunek pokazuje, w którym gnieździe łącze ma zmniejszoną szerokość.
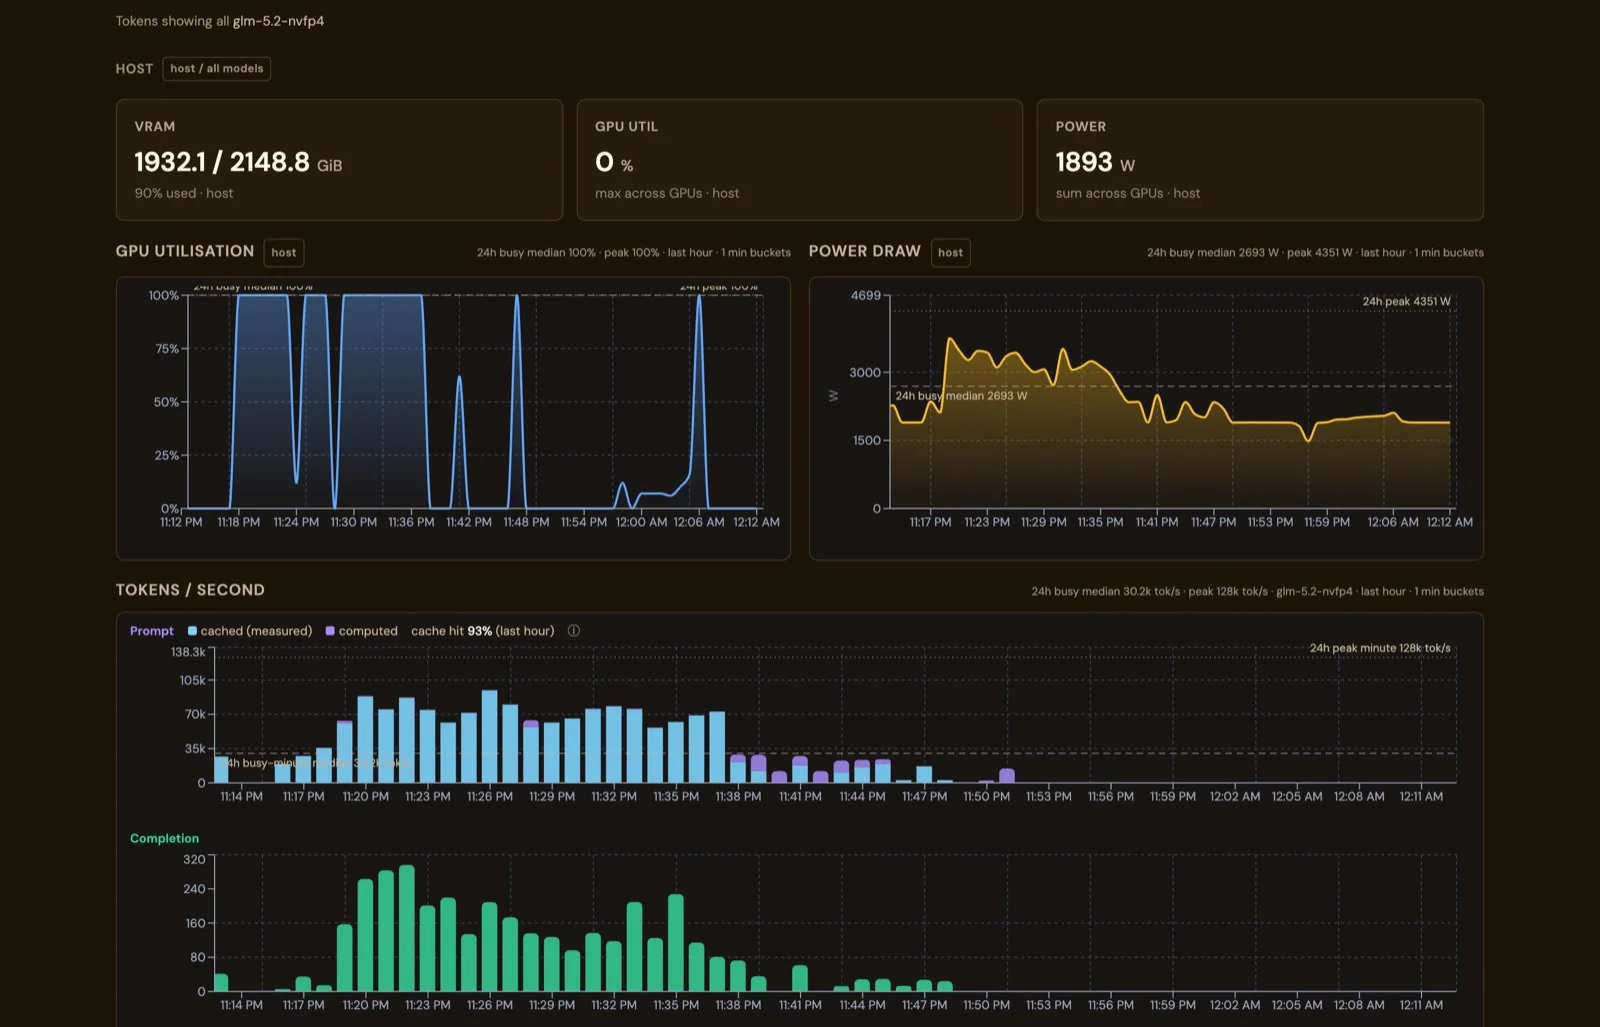
Stats na serwerze 8 × B300: VRAM 1932,1 z 2148,8 GiB, moc 1893 W łącznie dla kart, wykorzystanie GPU i pobór mocy z ostatniej godziny oraz tokeny promptu na sekundę z podziałem na pobrane z cache i obliczone przy 93% trafień w cache
Ta sama strona Stats na górnym końcu skali: 1 932 z 2 149 GiB VRAM, 1 893 W na wszystkich kartach, szczyt 4 351 W w ciągu godziny i 93% tokenów promptu z cache.
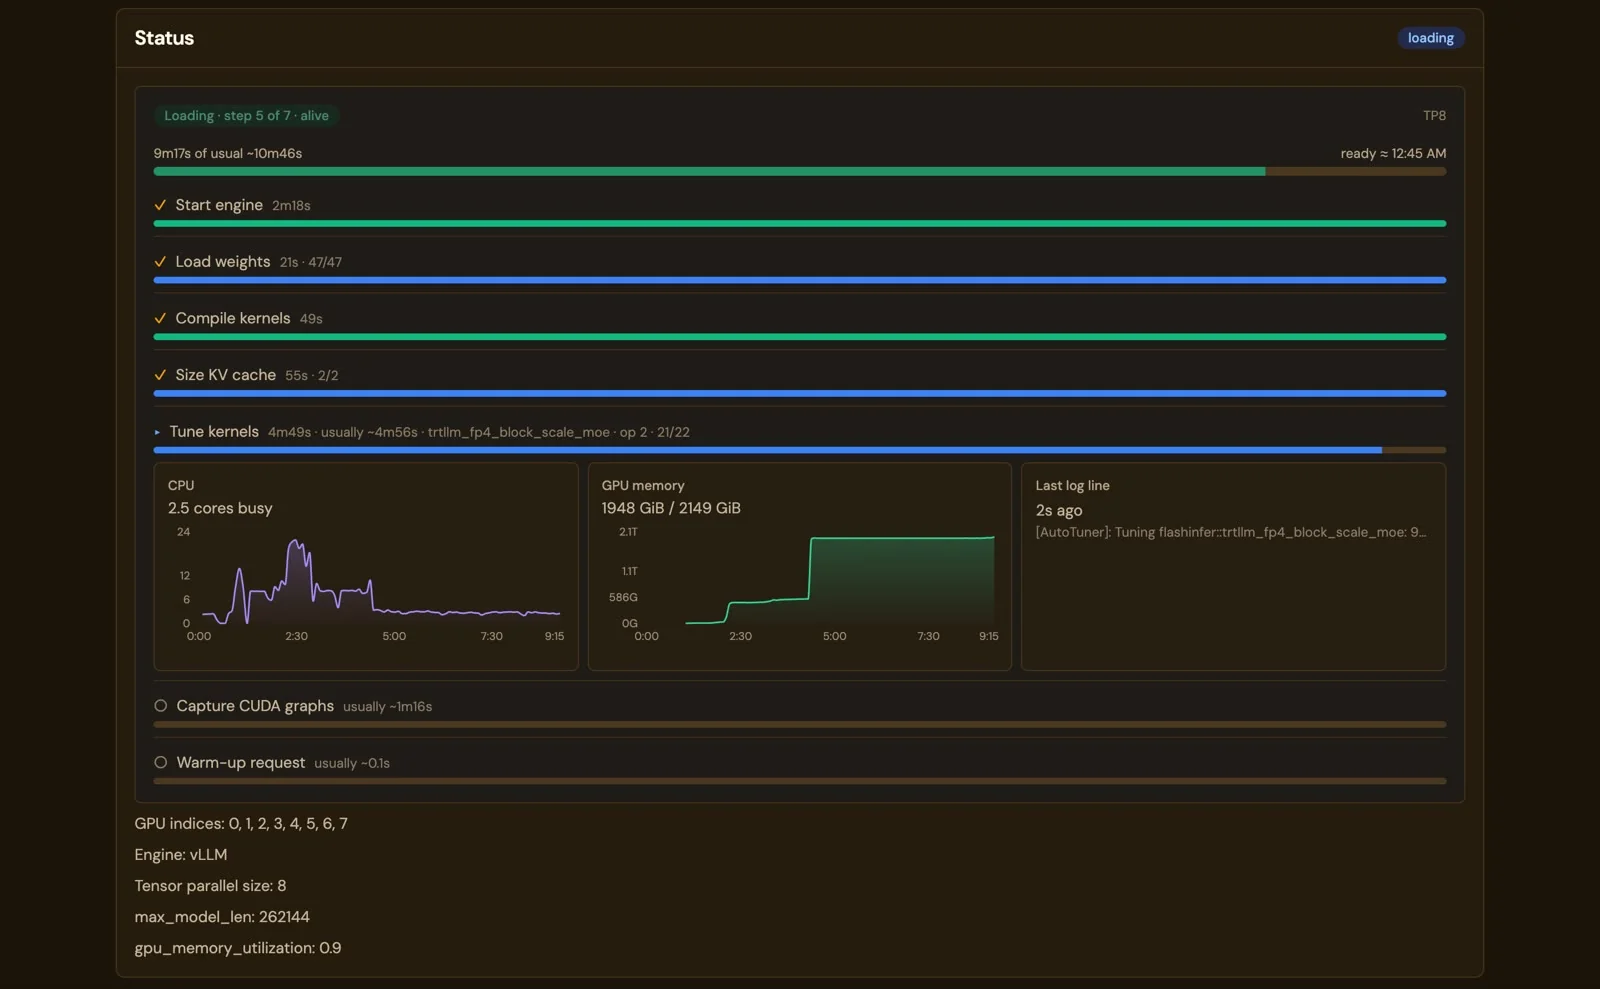
Strona modelu podczas ładowania GLM-5.2 NVFP4 na ośmiu B300: 9 min 17 s ze zwykłych 10 min 46 s, kroki Start engine, Load weights 47 of 47, Compile kernels i Size KV cache ukończone, Tune kernels na operacji 21 z 22, z wykresami CPU i pamięci GPU oraz ostatnim wierszem dziennika
Ładowanie trwające 10 minut, krok po kroku: GLM-5.2 NVFP4 na ośmiu B300, 9 min 17 s ze zwykłych 10 min 46 s; nic nie świeci na czerwono, dopóki ładowanie postępuje.

Co pokazuje każdy panel dla każdej karty: temperaturę względem jej własnego progu dławienia, moc względem jej limitu, taktowanie, wentylator, generację i szerokość PCIe wynegocjowane w tej chwili, ECC i NVLink, jeśli karta je ma, oraz proces zajmujący pamięć. Rysunek połączeń jest odczytywany z nvidia-smi topo -m. Na Macu: użycie GPU i budżet pamięci zgłaszany przez Metal, bez mocy. Sam silnik jest nadzorowany przez jego własny /health, a nie przez tabelę procesów: gdy silnik przestaje odpowiadać, choć otaczający go proces nadal działa, jest ładowany ponownie, a dane diagnostyczne zostają zachowane.

Co pokazuje

Monitorowanie GPU

Dane każdej karty osobno.

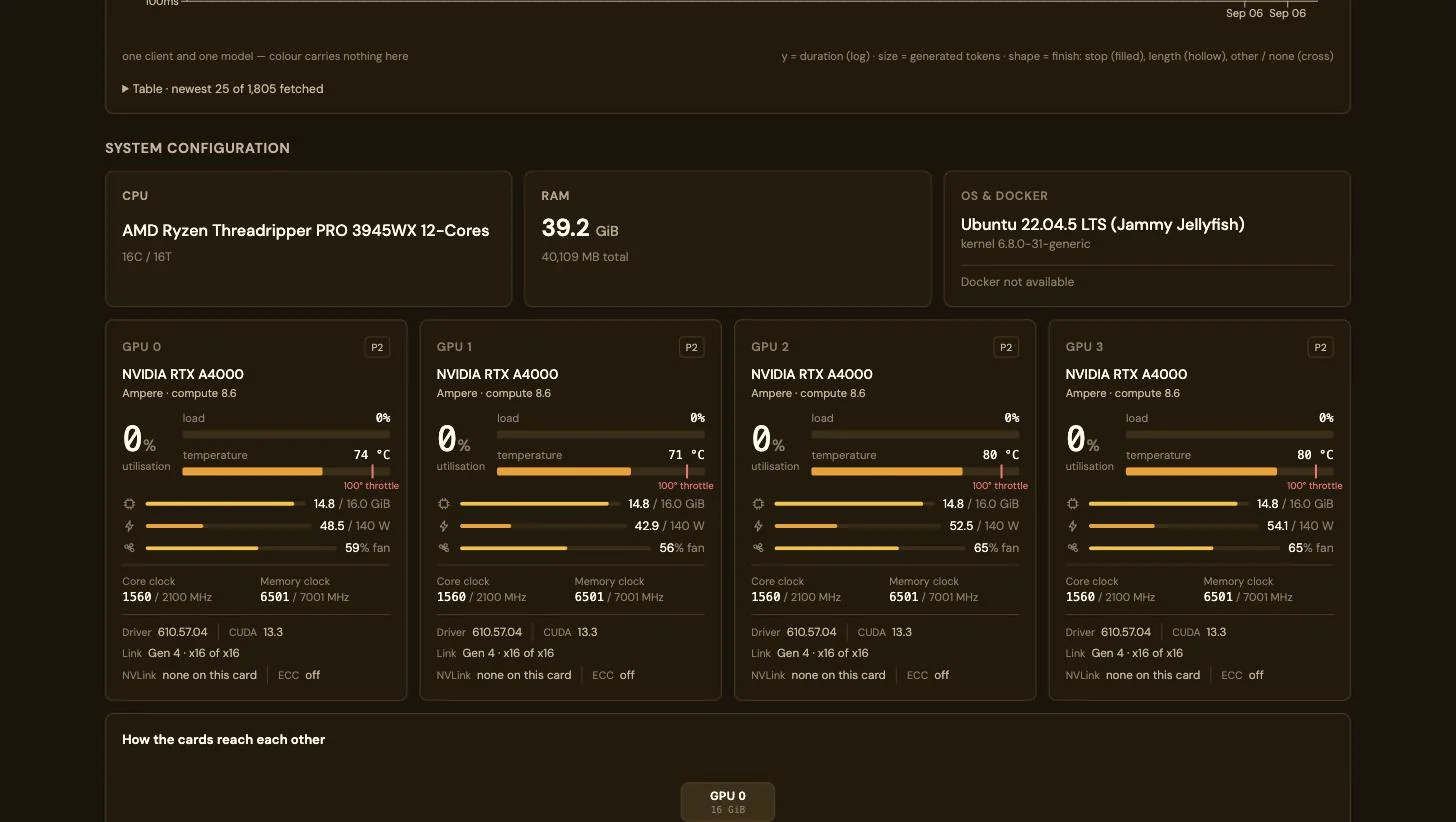
Wykorzystanie, temperatura względem progu dławienia tej karty, moc względem jej limitu, VRAM, taktowanie, łącze PCIe i proces zajmujący pamięć. Zamiast średniej dla całego serwera.

Konfiguracja systemu i cztery panele GPU dla kart NVIDIA RTX A4000 z wykorzystaniem, temperaturą, VRAM, mocą, wentylatorem i taktowaniem każdej karty

Żądania w toku

Zobacz, co każdy agent robi w tej chwili.

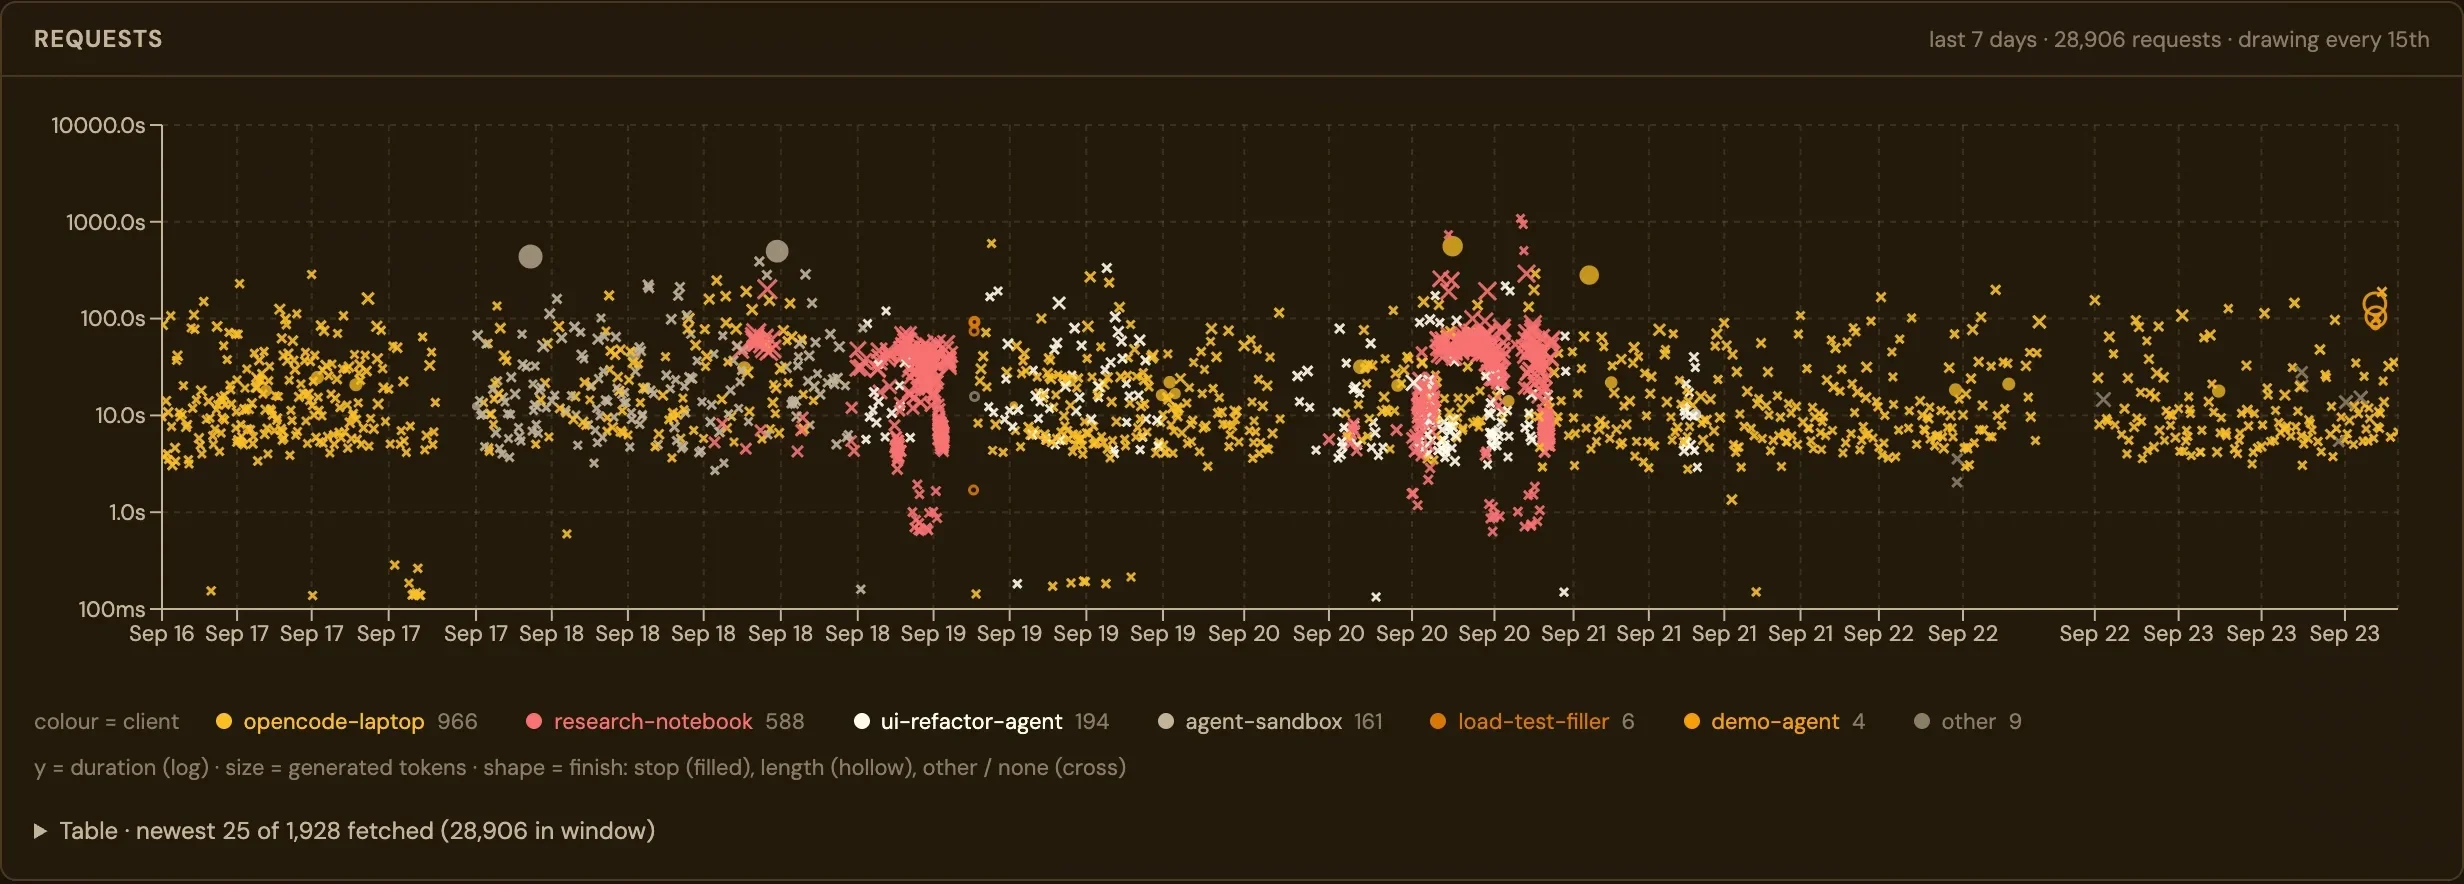
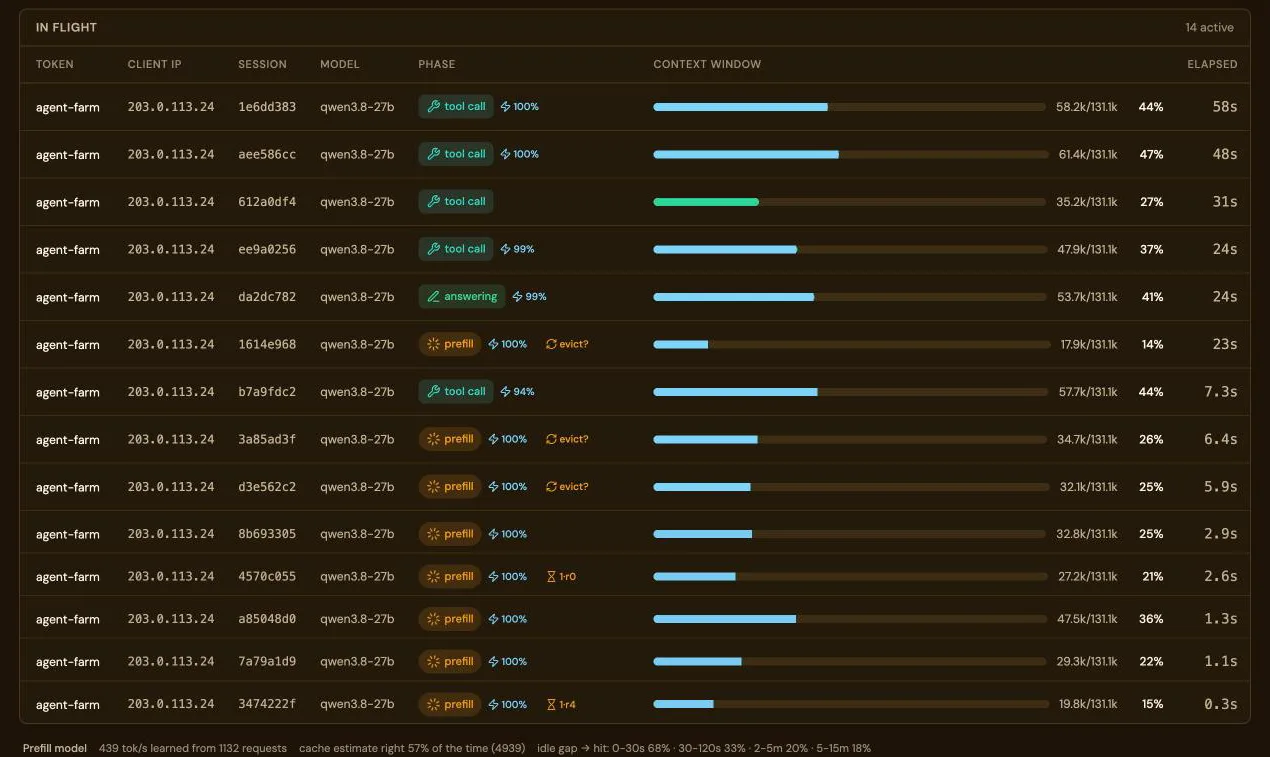
Każde żądanie z kluczem, sesją i fazą: w kolejce, prefill, myślenie, wywołanie narzędzia, odpowiadanie. Ile z każdego promptu pochodzi z cache prefiksów, mierzone dla każdego żądania.

Tabela żądań w toku: dziesięć aktywnych żądań, każde z kluczem, sesją, fazą i tokenami

Agenci do kodowania

Claude Code, Codex i OpenCode podłączone z jednej strony.

Connect zapisuje konfigurację każdego narzędzia z adresem tej instancji LM Warden, kluczem i załadowanym modelem, sprawdza wymagania względem tego, co jest faktycznie załadowane, i wysyła żądanie testowe.

Strona Connect a client z wybranym Claude Code i sprawdzonymi wymaganiami

Bezpłatny i otwartoźródłowy, rozwijany publicznie.

LM Warden jest dostępny na licencji Apache-2.0 w serwisie GitHub: skrypt instalacyjny i plik Compose to całe wdrożenie i możesz przeczytać oba. Bez konta, bez sprawdzania licencji, bez telemetrii. vLLM, llama.cpp i MLX to projekty zewnętrzne, które uruchamiamy bez modyfikacji.

mlx-rust-lm wkrótce

Port mlx-lm firmy Apple z Pythona do Rusta w oparciu o oficjalne wiązania Apple mlx-c, rozwijany i utrzymywany przez zespół LM Warden jako samodzielny projekt open source, którego LM Warden użyje jako trzeciego silnika na Macu. Z czasem zastąpi on silnik mlx-lm w Pythonie, który stanowi większość dzisiejszego pobrania dla Maca. Nieoficjalny, niepowiązany z Apple.