LM Warden

Ihre GPUs, nutzbar wie eine gehostete API.

LM Warden betreibt vLLM, llama.cpp oder MLX auf Ihrer eigenen Hardware und stellt einen einzigen OpenAI-kompatiblen Port davor: ein Schlüssel pro App, Nutzung pro Schlüssel und ein Live-Panel für jede GPU. Auf einem Linux-Rechner mit NVIDIA-Karten oder auf einem Mac mit Apple Silicon.

Open Source, Apache-2.0Kein Konto, keine TelemetrieLinux + NVIDIA · macOS (Beta) · Windows folgt

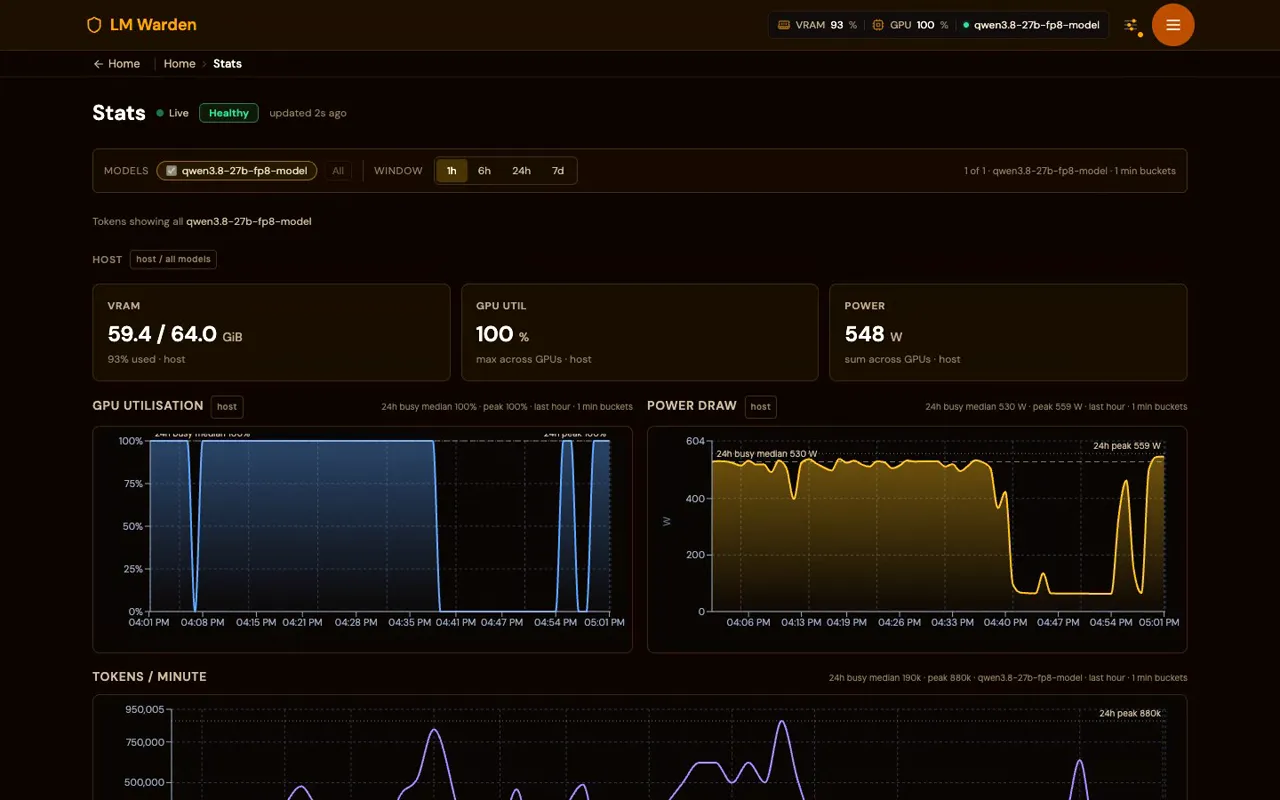
Die Stats-Seite einer ausgelasteten Instanz von LM Warden: VRAM 59,4 von 64 GiB, GPU-Auslastung 100 %, Leistungsaufnahme 548 W sowie Diagramme der GPU-Auslastung, der Leistungsaufnahme und der Token pro Minute in der letzten Stunde
  • Linux · NVIDIA vLLM v0.32.0 und llama.cpp b11719 auf CUDA
  • macOS · Apple Silicon MLX und llama.cpp auf Metal
  • APIs OpenAI, Anthropic Messages und Responses auf einem Port
  • Coding-Agenten Claude Code, Codex CLI, OpenCode und 7 weitere für Sie konfiguriert

Wofür LM Warden eingesetzt wird

Wo soll LM Warden laufen?

Wählen Sie oben eine Plattform, um ihre Schritte zu sehen, oder alle vier anzeigen.

Ein Befehl auf dem GPU-Host.

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • x86_64-Host, Docker Compose v2.24+, das NVIDIA Container Toolkit, eine Karte ab Turing.
  • Öffnen Sie dann http://HOST:8080/ui/, schließen Sie den Einrichtungsassistenten ab, fügen Sie ein Modell hinzu und erstellen Sie einen Schlüssel. Ihr Endpunkt ist http://HOST:8080/v1.
  • Mehrere GPUs in einem Rechner: Tensor-Parallelität oder ein Replikat pro Karte mit Cache-sensitivem Routing.
  • Derzeit NVIDIA. Unterstützung für AMD ROCm und Intel-GPUs folgt demnächst; noch ohne Termin. Sagen Sie uns, worauf Sie es einsetzen würden: Radeon · Intel.
  • Installationsanleitung · Offline / vom Netz getrennt · Aus dem Quellcode · Aktualisieren
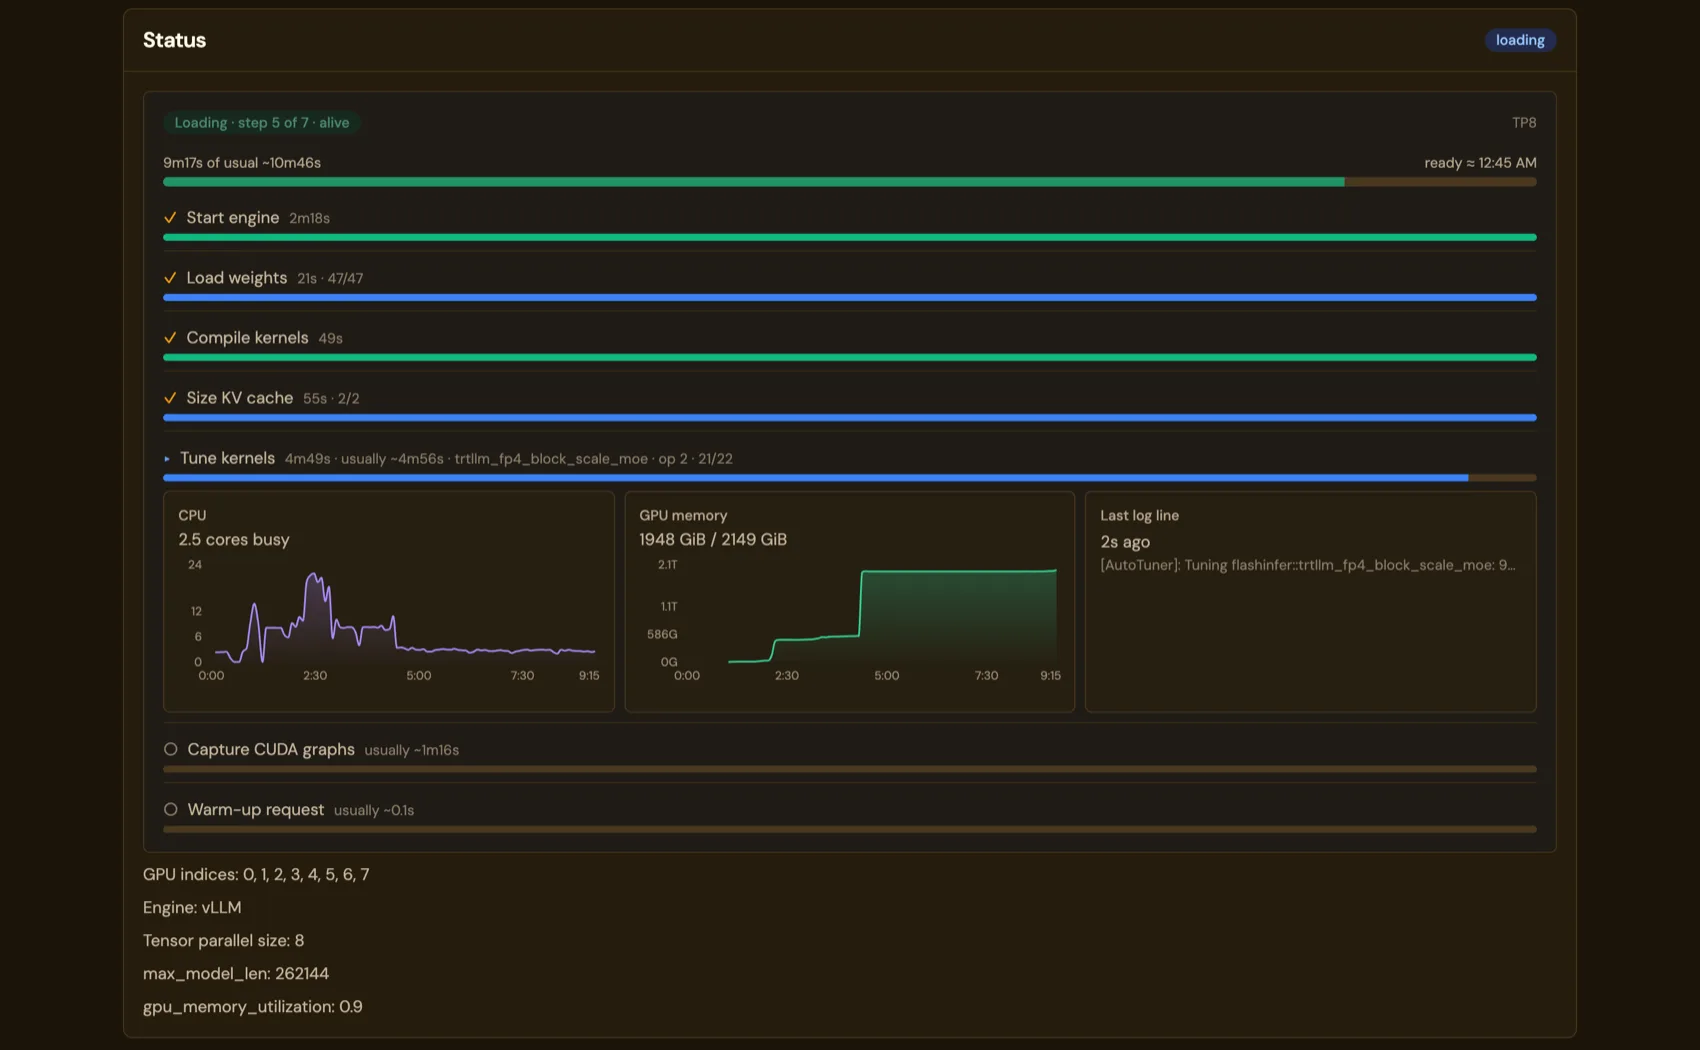
Ein laufender Modell-Ladevorgang auf der Seite Models, jeder Schritt mit bisheriger und üblicher Dauer
Ein Modell lädt nach der Installation: jeder Schritt mit der üblichen Dauer aus früheren Ladevorgängen.

Eine Menüleisten-App, derzeit als Beta.

Für Mac herunterladen (Beta)

  • Etwa 110 MB. Apple Silicon (M1 oder neuer), macOS 14 oder neuer. SHA-256 · Versionshinweise.
  • Engines: MLX und llama.cpp mit Metal-Unterstützung. Dasselbe Dashboard und dieselbe OpenAI-API; kein vLLM, keine Anzeige der Leistungsaufnahme.
  • Was Beta hier heißt: ad hoc signiert und nicht notarisiert, daher fragt macOS beim ersten Start, ob Sie die App unter Datenschutz & Sicherheit zulassen; für Updates laden Sie die App neu herunter. Schritte für den ersten Start.
  • Nur unter 127.0.0.1 erreichbar, bis Sie Share on Local Network wählen.
  • Demnächst: mlx-rust-lm, eine dritte Engine. Das Team von LM Warden portiert Apples mlx-lm von Python nach Rust, auf Basis der offiziellen mlx-c-Bindings von Apple; sie wird neben MLX und llama.cpp laufen und mit der Zeit die Python-Engine mlx-lm ersetzen, die zusammen mit Python und dessen Bibliotheken den Großteil des heutigen Downloads ausmacht. Inoffiziell, keine Verbindung zu Apple.
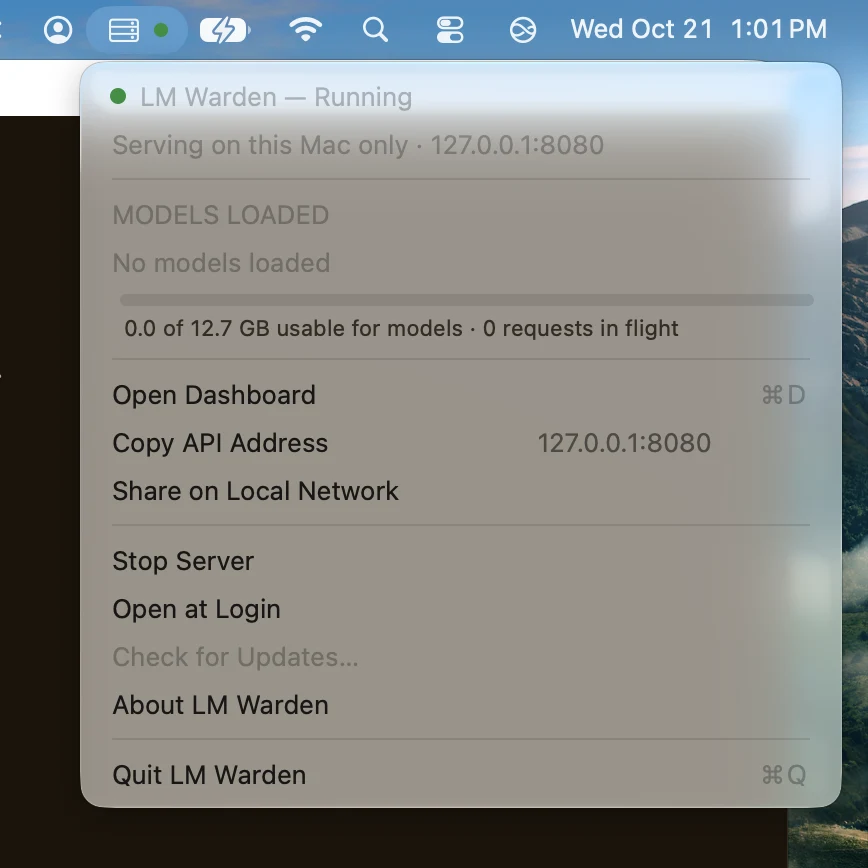
Das Menüleisten-Menü von LM Warden auf einem Mac: Running, nur auf diesem Mac unter 127.0.0.1:8080 erreichbar, keine Modelle geladen, ein Speicherbalken, Open Dashboard, Copy API Address, Share on Local Network
Das Menüleisten-Menü der Beta auf einem M1 mit 16 GB.

Windows kommt als Nächstes. Einen Termin gibt es noch nicht.

Wir arbeiten daran und stellen hier einen Build bereit, sobald es ihn gibt – vorher kein Anmeldeformular. Bis dahin gibt es zwei realistische Möglichkeiten:

  • Betreiben Sie LM Warden auf einem Linux-GPU-Rechner und nutzen Sie es von Windows aus: Jeder OpenAI-Client, Claude Code und Codex verbinden sich über das Netzwerk.
  • Releases auf GitHub beobachten, um vom ersten Windows-Build zu erfahren.
  • AMD Radeon und Intel-GPUs folgen danach; sagen Sie uns, worauf Sie es betreiben würden: Radeon · Intel.

Die Appliance: demnächst, ohne Termin.

Eine vierte Art, LM Warden zu betreiben, für einen Rechner, der nichts anderes tun soll.

  • Sie stecken einen USB-Stick in ein Gehäuse mit GPUs. Er installiert ein abgespecktes Linux, das genau eine Sache tut: LM Warden ausführen.
  • Die Appliance richtet Netzwerk und Modellspeicher für Sie ein.
  • Updates kommen online, oder der Rechner arbeitet vollständig vom Netz getrennt.
  • Gemacht für einen sicheren, dedizierten LLM-Server: für ein Team, das einen abgeschotteten Rechner will, oder für einen Standort ohne Verbindung nach außen.

Bis die Appliance erscheint, erledigt die Linux-Installation oben dieselbe Aufgabe auf einem Host, den Sie selbst einrichten, einschließlich der Offline-Installation ohne Netzverbindung. Releases auf GitHub beobachten.

Noch kein Bild: Es gibt weder einen Produktnamen noch Hardware, die wir zeigen könnten, und wir werden auch keine zeichnen.

Schon im Einsatz? Unter Linux wird an Ort und Stelle aktualisiert: neue Images herunterladen, neu starten, die Datenbank wird automatisch migriert. Schritte · Änderungsprotokoll.

Wer selbst hostet, hat acht Probleme. So sieht die Lösung für jedes davon aus.

Eine Engine allein stellt ein Modell auf einem Port bereit. Hier sind die Bausteine darum herum, mit unseren eigenen Messwerten, wo wir welche haben.

  1. Passt dieses Modell auf meine GPU?

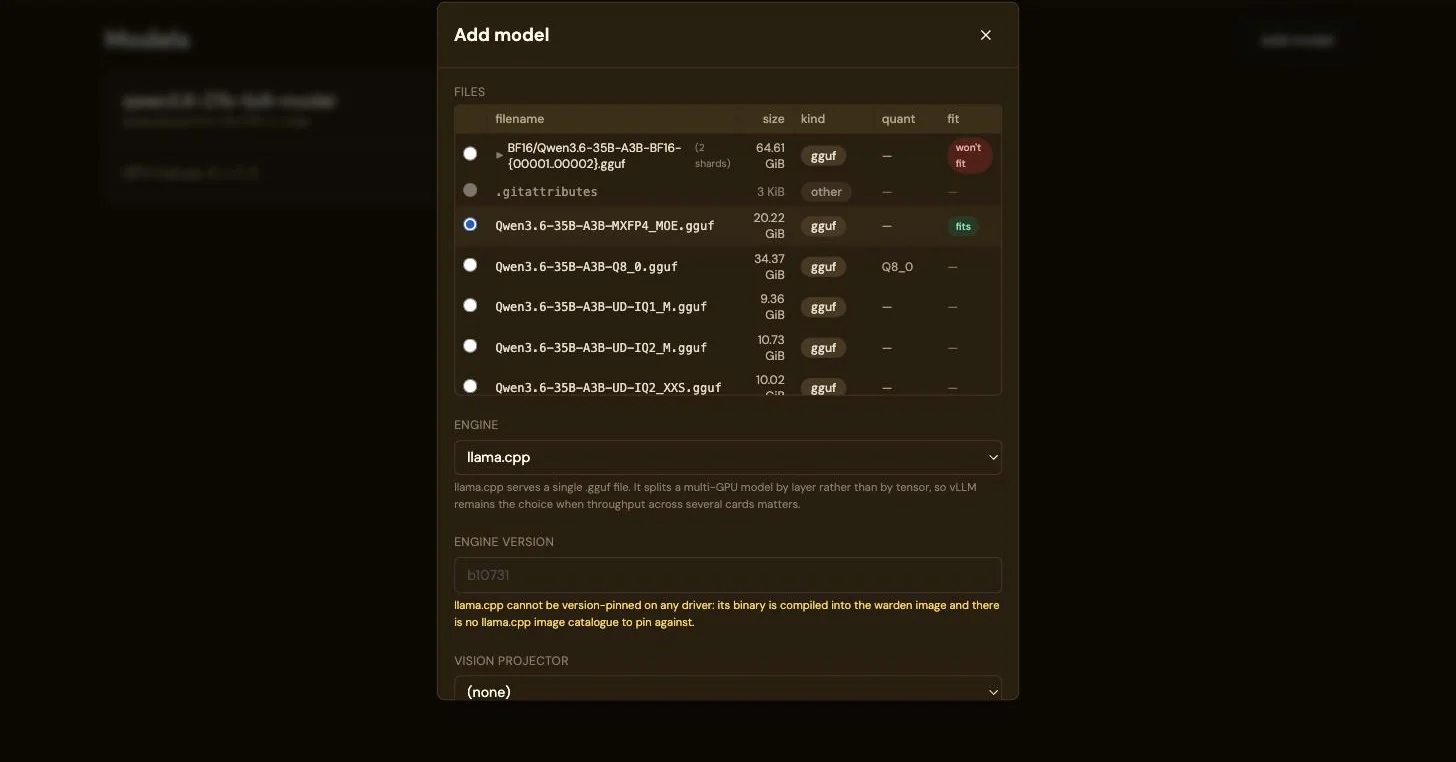
    Fügen Sie ein Repository von Hugging Face in Add model ein. Jede Datei wird mit einer Bewertung für die ausgewählten Karten aufgeführt: passt, knapper Spielraum oder passt nicht. Wählen Sie weitere Karten aus, und deren Speicher wird zusammengerechnet. Heruntergeladen wird erst, wenn etwas passt.

    Dieselbe Datei mit 20,22 GiB, als passend markiert, sobald vier GPUs ausgewählt sind
  2. Sie haben GPUs gekauft. Arbeiten sie oder warten sie?

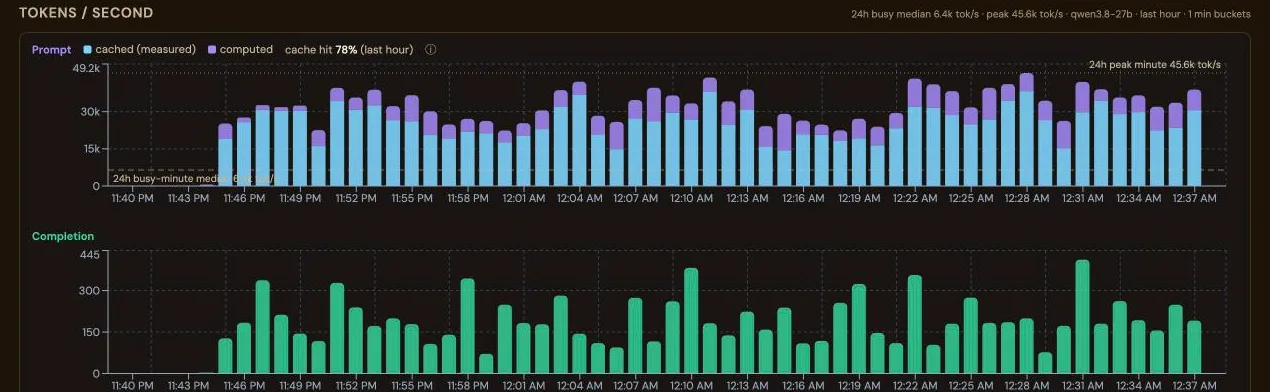
    Der Durchsatz ist Parallelität × Prompt-Länge × Cache-Wiederverwendung, und eine Engine allein zeigt nichts davon im Zusammenhang. Die Stats-Seite schon, für Zeiträume von 1 h bis 7 Tagen: VRAM, GPU-Auslastung, Leistungsaufnahme (Linux), Token pro Sekunde mit Prompt-Token aufgeteilt in gecacht und berechnet, Latenz p50/p95, Trefferquote des Prompt-Caches, Preemptions, Anfragen pro Schlüssel und pro Client-IP. Stagniert die Auslastung, während Anfragen warten, erhöhen Sie die Parallelität; ist der Cache-Anteil niedrig, ordnen Sie Sitzungen fest einem Replikat zu.
    Token pro Sekunde: Prompt-Token aufgeteilt in gecacht und berechnet, darunter die Completion-Token
  3. Testen Sie das Modell im Chat, bevor Sie irgendetwas anbinden.

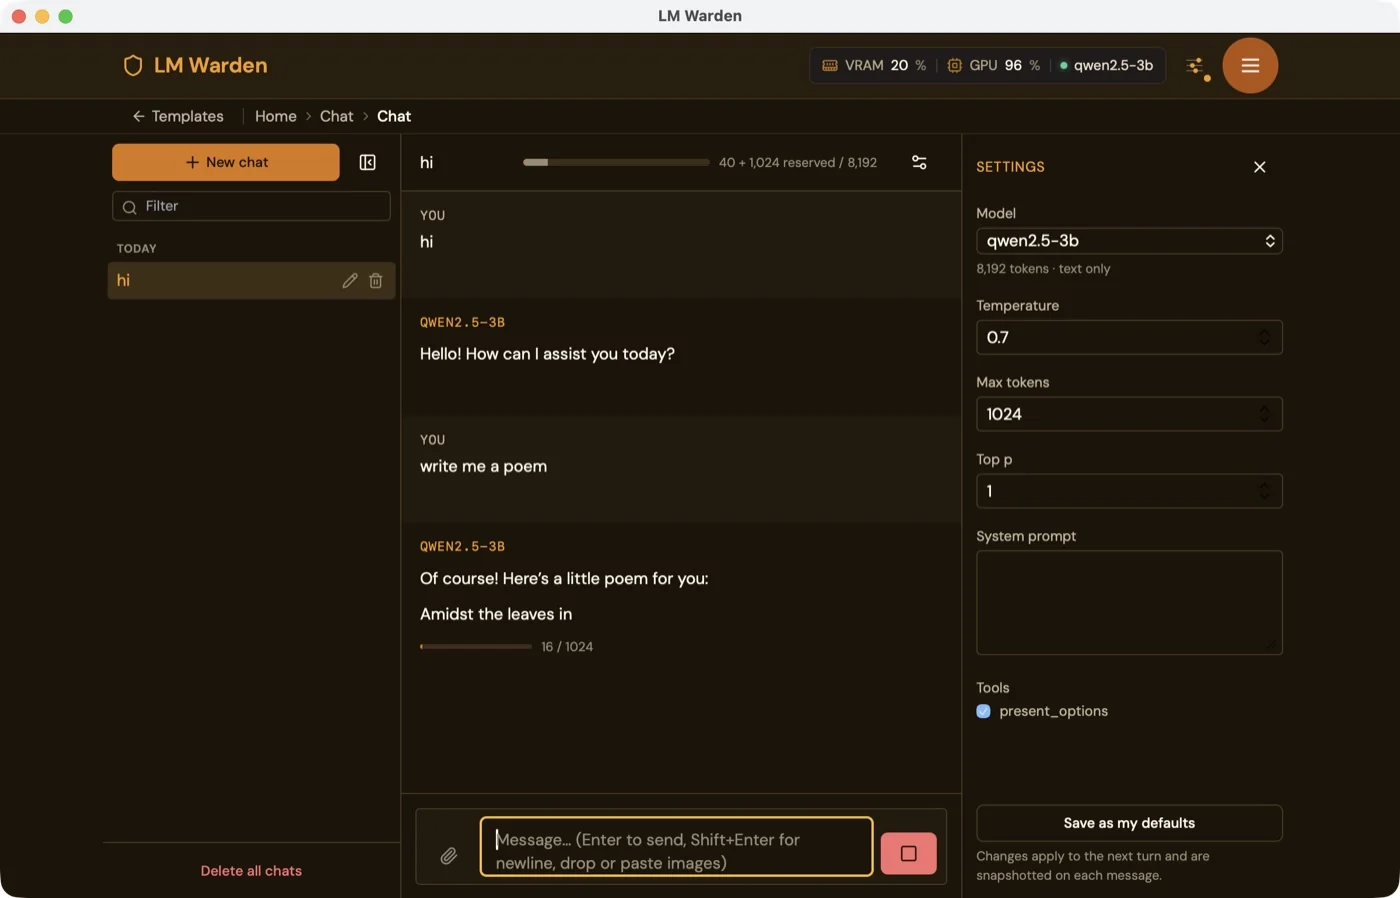
    Der Chat ist im selben Fenster wie alles andere. Streaming-Markdown mit hervorgehobenem Code und Mathematik; bis zu acht PNG-, JPEG- oder WebP-Bilder pro Nachricht für ein Vision-Modell; Temperatur, Top-p, maximale Token und System-Prompt pro Chat, als Standard gespeichert; Chats werden gespeichert, betitelt und lassen sich verzweigen. Tool-Aufrufe des Modells werden angezeigt, sodass Sie Tool Calling prüfen können, bevor sich ein Agent darauf verlässt.

    Der Chat im Dashboard-Fenster der Mac-App, Streaming von qwen2.5-3b mit GPU 96 % in der Kopfzeile
  4. Was hat das Modell tatsächlich gesehen und gesagt?

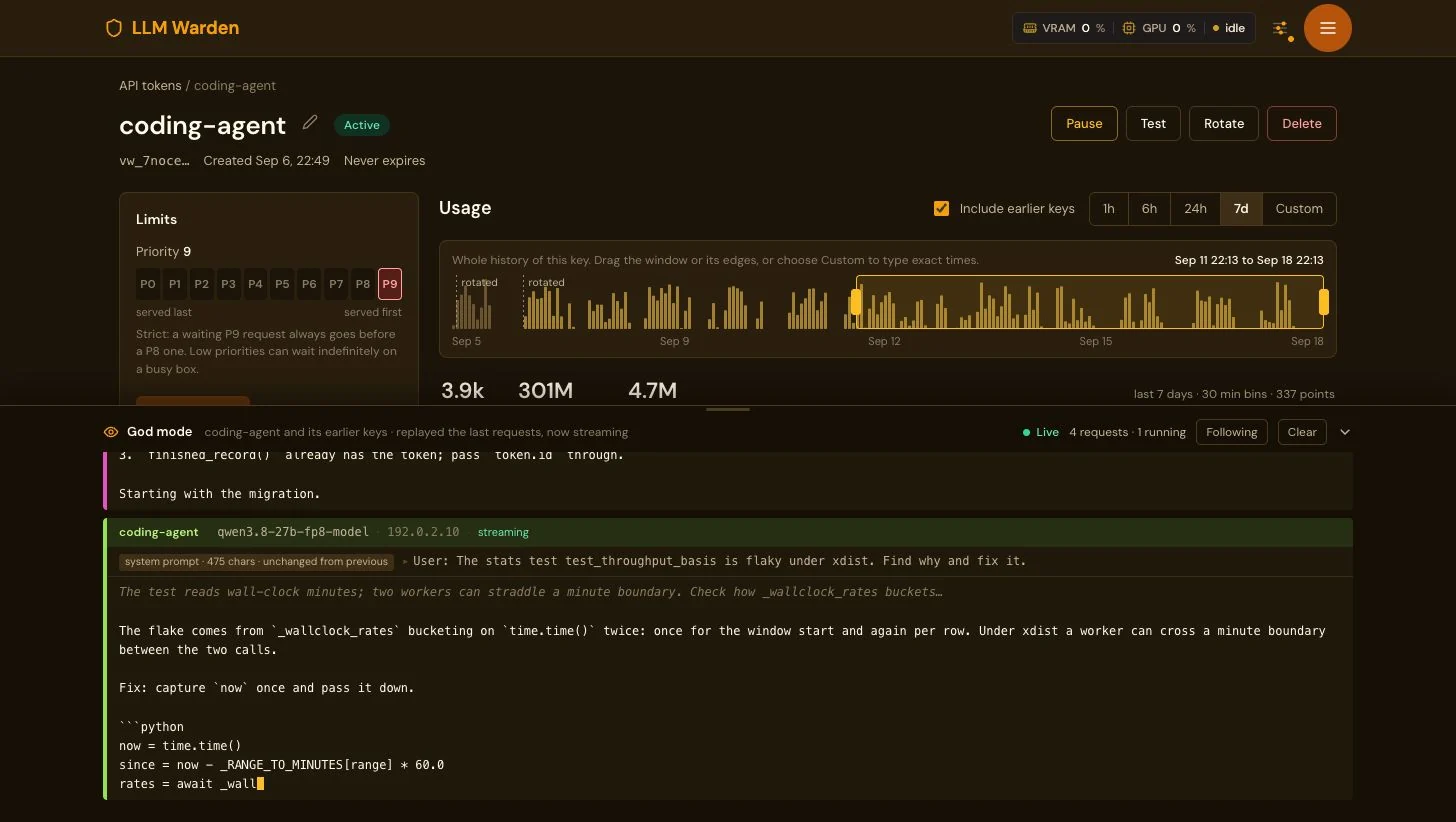
    God mode, zum Debuggen von Prompts: Mit VW_GODMODE_ENABLED im Deployment erhält die Seite jedes Schlüssels ein Panel, das dessen Prompts und Completions live streamt. Standardmäßig aus, und im ausgeschalteten Zustand gar nicht vorhanden. Ein begrenzter Ringpuffer im Arbeitsspeicher: Nichts landet in der Datenbank oder auf der Festplatte, nach einem Neustart ist alles weg. Jeder mit Zugriff auf die Admin-Sitzung kann es öffnen; der Warden kennt genau eine Admin-Rolle und sonst keine.

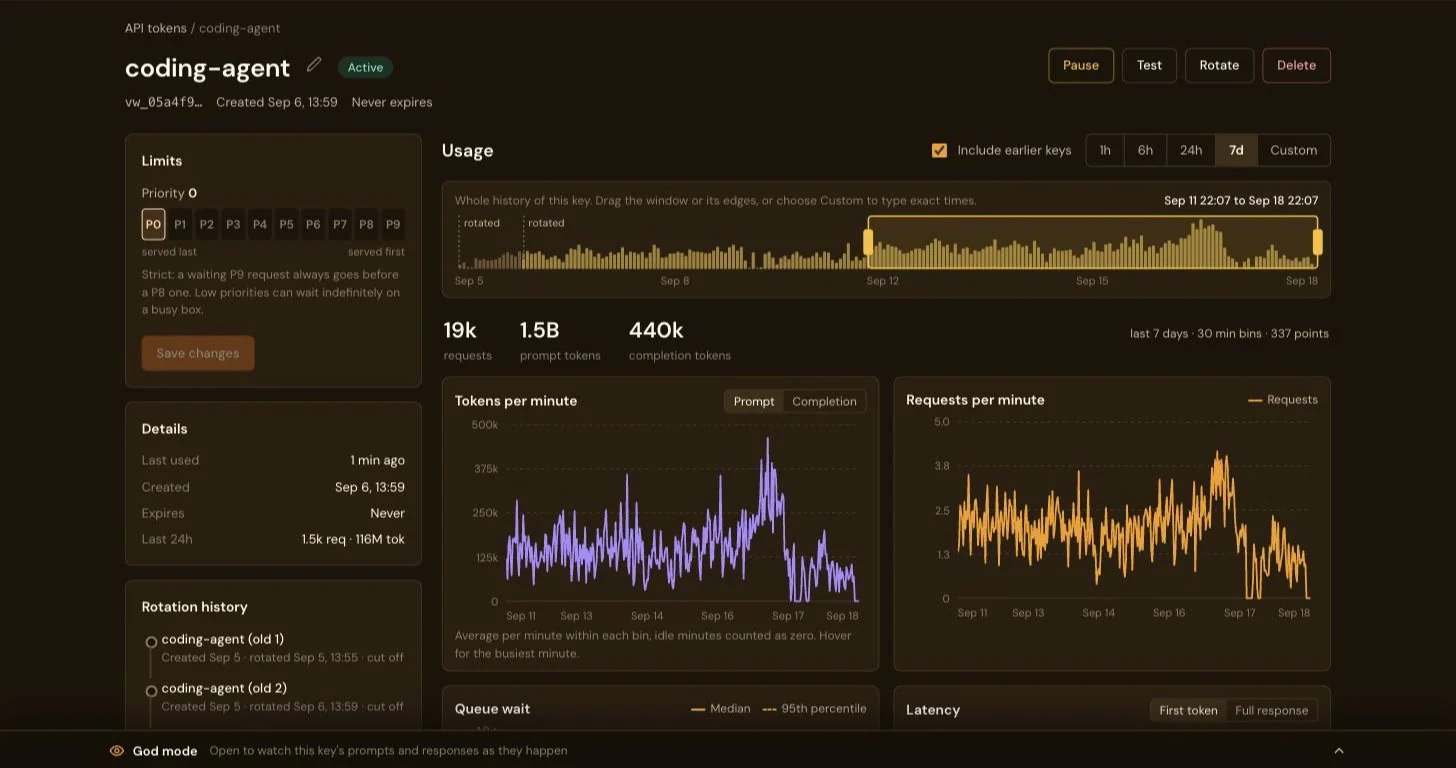
    Die Seite des API-Schlüssels coding-agent mit dem unten geöffneten Panel von God mode: Live, 4 Anfragen, 1 läuft; eine Anfrage an qwen3.8-27b-fp8 von 192.0.2.10 wird gestreamt und zeigt den Benutzer-Prompt zu einem sporadisch fehlschlagenden Stats-Test und die Antwort des Modells mit einer Python-Korrektur, während sie geschrieben wird

Jede Agent-Runde liest die ganze Unterhaltung erneut.

Ein Agent sendet in jeder Runde seinen gesamten Verlauf erneut, daher besteht eine lange Unterhaltung größtenteils aus einem Präfix, das die Engine schon gelesen hat. vLLM hält diese Arbeit in seinem Präfix-Cache vor, aber nur auf dem Replikat, das sie geleistet hat, und sein eigener Balancer schickt jede Runde an das Replikat mit der kürzesten Warteschlange. LM Warden platziert jede neue Unterhaltung auf dem am wenigsten ausgelasteten Replikat und hält sie dort, anhand der Sitzungs-ID, die Claude Code ohnehin sendet. Eine Anfrage wird nur verschoben, wenn dieses Replikat seinen Überlaufschwellenwert überschreitet.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Vier Runden einer Unterhaltung auf einem Modell mit vier Replikaten. Mit dem Balancer von vLLM wird jede Runde fast von Grund auf im Prefill verarbeitet (ihr Prompt in den Cache eingelesen), auf welchem Replikat sie auch landet. Mit LM Warden bleibt die Unterhaltung auf Replikat 2, und nur die neue Runde geht durch den Prefill. Eine Zeichnung des Mechanismus, keine Messung.

Gemessen auf unserem Rechner mit vier Karten (4 × RTX A4000, Qwen3-4B als vier Replikate mit je einer Karte, synthetische Sitzungen im Stil von Claude Code, Affinität erst aus, dann an, direkt hintereinander): Mit fest zugeordneten Unterhaltungen stieg der Anteil der aus dem Cache bedienten Prompt-Token bei 4 parallelen Sitzungen von 56 auf 86 %, und die mediane Zeit bis zum ersten Byte fiel von 2,05 auf 0,38 s. Die Ausgabe-Token pro Minute waren bei jeder gemessenen Stufe höher, und die p95-Zeit bis zum ersten Byte (die langsamsten 5 %) war bei jeder Stufe niedriger. Die Zahl der arbeitenden Replikate änderte sich kaum (2,71 gegenüber 2,83 von vier bei 4 Sitzungen): Der Vorteil kommt aus der Wiederverwendung des Caches, nicht aus zusätzlich arbeitenden Karten.

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Trefferquote des Präfix-Caches in jeder Stufe: aus dem Cache bediente Prompt-Token geteilt durch angefragte Prompt-Token, alle vier Replikate zusammengefasst, berechnet aus der Änderung der eigenen Zähler von vLLM während der Stufe. Der Vorteil bleibt erhalten, solange Spielraum besteht, und ist bei 32 Sitzungen verschwunden, wo Unterhaltungen überlaufen.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Zeit bis zum ersten Byte bei 4 bis 32 parallelen Sitzungen, Median und p95, auf logarithmischer Skala, damit die Stufen unter einer Sekunde neben den minutenlangen lesbar bleiben. Mit Affinität ist der Median bis 16 Sitzungen weit niedriger (0,38 gegenüber 2,05 s bei 4) und bei 24 und 32 höher; das p95 ist bei jeder Stufe niedriger, wobei der Abstand bei 16 (24,9 gegenüber 26,2 s) im Rauschen eines einzigen Durchlaufs pro Variante liegt. Gemessen beim Client, über das Internet, bis zum ersten gestreamten Token.

Jede Stufe der Rampe, Affinität aus → an

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Gemessen auf unserem Rechner mit vier Karten und einem kleinen Modell, Affinität zuerst aus, dann an, ohne vLLM dazwischen neu zu starten: Die zweite Variante begann mit einem warmen Präfix-Cache, und beide Varianten zogen ihre Prompts aus demselben Seed. Jede Stufe dauert 3 Minuten, daher werden nur 9 bis 31 Sitzungen abgeschlossen, und eine Sitzung mehr oder weniger verschiebt die Sitzungen pro Stunde um 20; die Ausgabe-Token pro Minute sind die stabilere Spalte. Ihr Modell, Ihre Karten und Ihre Last werden abweichen; das Replikat-Panel auf der Seite eines Modells zeigt dieselben Zähler für Ihre Konfiguration.

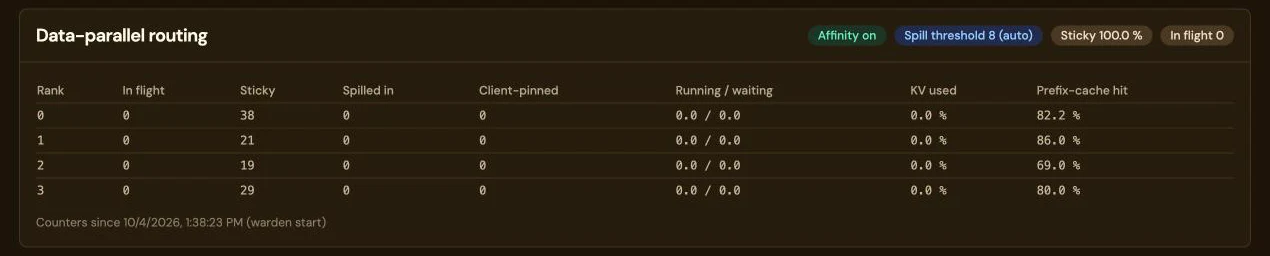
Das Panel Data-parallel routing auf der Seite eines Modells, mit den Badges Affinity on, Spill threshold 8 (auto), Sticky 100.0% und In flight 0. Eine Tabelle listet die Replikate 0 bis 3 mit in flight, sticky (38, 21, 19 und 29), spilled in, client-pinned, running und waiting, belegtem KV und Trefferquote des Präfix-Caches (82,2; 86,0; 69,0 und 80,0 Prozent), dazu eine Zeile, dass die Zähler seit dem Start des Wardens laufen.
Dieselben Zähler auf der Seite eines Modells: eine Zeile pro Replikat mit den Anfragen, die es gerade bearbeitet, wie viele Unterhaltungen geblieben (sticky) oder durch Überlauf hinzugekommen sind, was läuft und wartet, belegter KV-Cache und die Trefferquote des Präfix-Caches. Aufgenommen am 4. Oktober 2026 mit Affinität an und dem Überlaufschwellenwert bei 8 (auto): sticky 100 % und eine Trefferquote des Präfix-Caches von 82,2; 86,0; 69,0 und 80,0 % auf den Replikaten 0 bis 3. Das ist ein Screenshot des Panels, kein Messergebnis. Tippen Sie auf das Bild, um es zu vergrößern.

Wo die Affinität schlechter abschneidet. Die Stufen mit 24 und 32 Sitzungen sind eine bewusste Überlastung von vier kleinen Karten, und jedes Replikat ist ausgelastet. Die Ausgabe ist dennoch höher (11.178 gegenüber 9.048 und 16.638 gegenüber 14.760 Token pro Minute), und die langsamsten Anfragen warten deutlich kürzer (p95 38 gegenüber 59 s und 39 gegenüber 83 s), aber die mediane Zeit bis zum ersten Byte ist mit Affinität schlechter: 13,1 gegenüber 5,1 s bei 24 Sitzungen, 27,7 gegenüber 12,3 s bei 32. Die Ursache haben wir nicht isoliert, und das Senken des Überlaufschwellenwerts von 8 auf 4 hat daran nichts geändert.

Messen Sie beides auf einem ausgelasteten Rechner. Der Vorteil ist am größten, solange Spielraum besteht; läuft ein Rechner an seiner Grenze, sollten Sie beide Einstellungen messen – die Affinität lässt sich pro Modell abschalten. Replikate, und damit dieses Routing, gehören zur Linux-Installation mit NVIDIA-GPUs; die Mac-App (Beta) hat weder Tensor- noch Datenparallelität.

Die vollständige Methode: die Last, der Testaufbau, der Überlaufschwellenwert und ein Rechner mit sieben GPUs, der seitdem damit läuft →

Nutzen Sie Ihre eigenen GPUs für Ihren Coding-Agenten.

Zehn Clients verbinden sich mit einer Basis-URL und einem Schlüssel; mit zweien davon können Sie zusätzlich ein bezahltes Claude-Abo für die anspruchsvolle Arbeit weiter nutzen.

Claude-Abo behalten, Routineaufrufe auslagern

Claude Code und das Anthropic SDK, über den Router. Eine Regel legt fest, anstelle welcher Claude-Modelle Ihre GPUs antworten; alles andere geht mit Ihrer eigenen Anmeldung oder Ihrem Schlüssel an Anthropic.

Wohin eine Anfrage von Claude Code geht Der Agent sendet jede Anfrage an den Router von LM Warden. Anfragen für claude-haiku-Modelle gehen an ein Modell auf Ihrer GPU, das unter dem angefragten Modellnamen antwortet. Jedes andere Modell, Opus eingeschlossen, wird mit Ihrer eigenen Anmeldung an Anthropic durchgereicht. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Wohin eine Anfrage von Claude Code geht Der Agent sendet jede Anfrage an den Router von LM Warden. Anfragen für claude-haiku-Modelle gehen an ein Modell auf Ihrer GPU, das unter dem angefragten Modellnamen antwortet. Jedes andere Modell, Opus eingeschlossen, wird mit Ihrer eigenen Anmeldung an Anthropic durchgereicht. Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
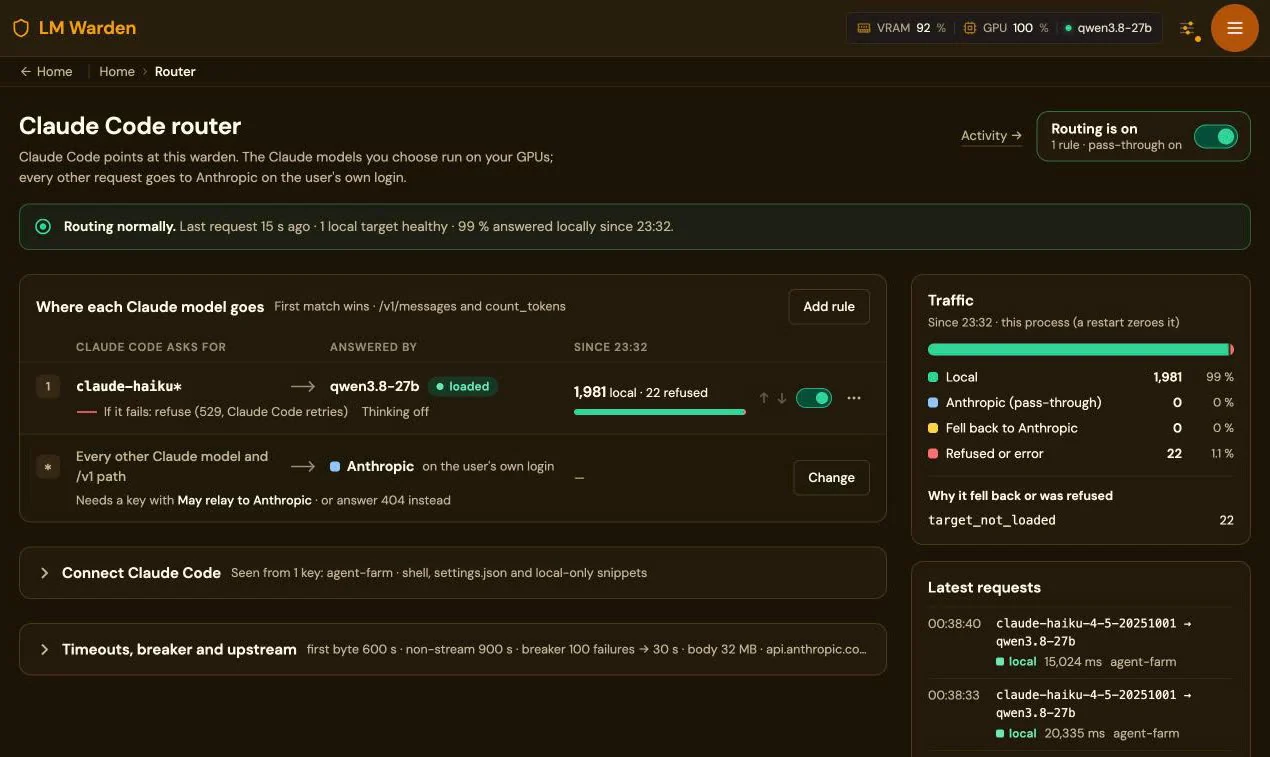
1.981Anfragen lokal beantwortet, 99 % des Verkehrs von Claude Code auf diesem Rechner seit seinem Neustart. Von der Router-Seite unseres eigenen Rechners mit sieben GPUs, 21. Oktober 2026; 22 abgelehnt, solange das Ziel nicht geladen war.
Die Router-Seite für Claude Code: Routing ist an, 99 % seit 23:32 lokal beantwortet; Regel 1 schickt claude-haiku* an qwen3.8-27b, 1.981 lokal und 22 abgelehnt; jedes andere Claude-Modell geht mit der eigenen Anmeldung des Benutzers an Anthropic
Claude Code 2.1.227 oder neuer: ANTHROPIC_BASE_URL zeigt auf den Warden, der Warden-Schlüssel steht in ANTHROPIC_CUSTOM_HEADERS, Ihre Anmeldung bleibt unverändert. Die Antwortqualität haben wir nicht mit Benchmarks gemessen: Überlassen Sie dem lokalen Modell die routinemäßige, klar spezifizierte Arbeit.

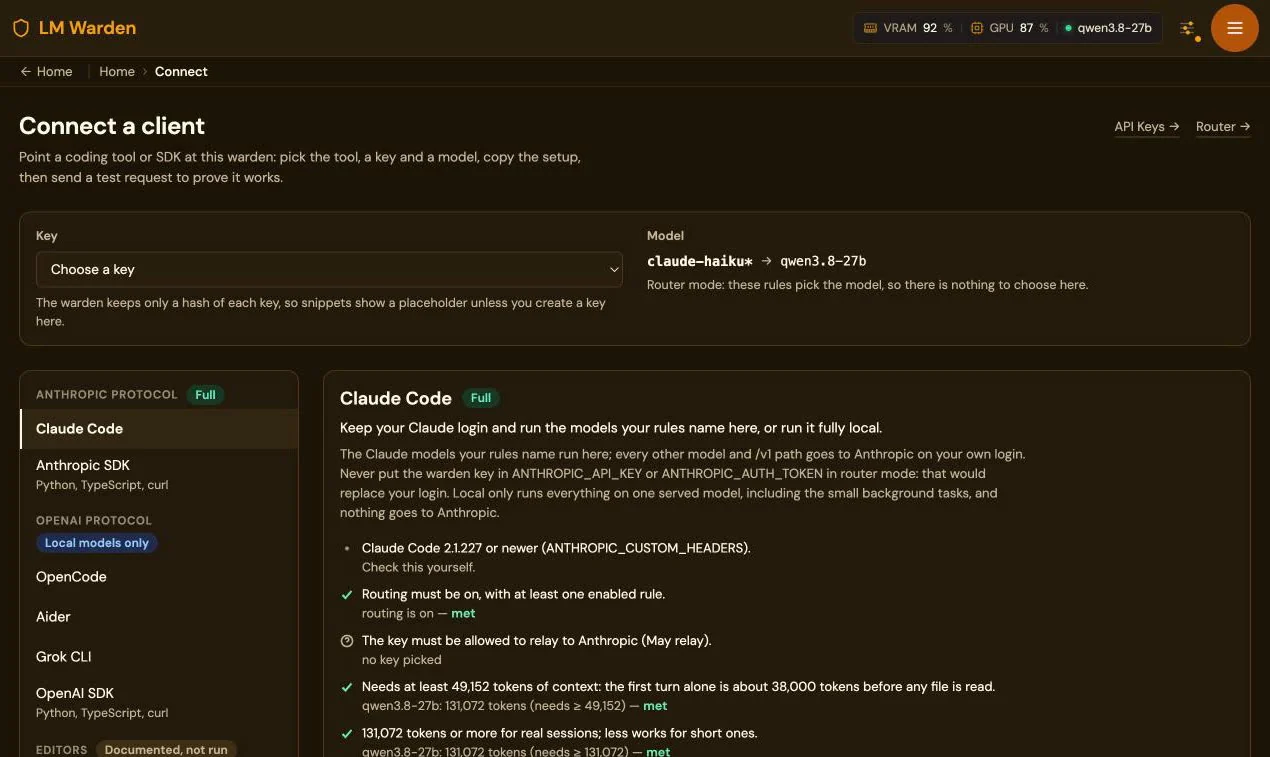
Connect erzeugt die Konfiguration für jeden Client und sendet eine Testanfrage.

Wählen Sie in der Konsole den Client, einen Schlüssel und ein geladenes Modell; die Konsole prüft jede Anforderung an dem, was tatsächlich geladen ist (Kontextfenster, Tool Calling, Router an), und liefert Ihnen die Dateien zum Einfügen. Alle Coding-Agenten, eine Seite pro Client mit dem, was funktioniert, und dem, was wir beobachtet haben.

Die Seite Connect a client: eine Schlüsselauswahl, die Router-Regel claude-haiku* auf qwen3.8-27b, Clients nach Protokoll gruppiert und das Panel für Claude Code mit geprüften Anforderungen

Lassen Sie die KI, für die Sie ohnehin bezahlen, Ihre eigenen GPUs optimieren.

Ein Modell für Ihre Karten auszuwählen heißt: eine Quantisierung wählen, eine Engine, die Aufteilung auf die GPUs, die Kontextgröße und den KV-Cache-Typ; jeder Versuch kostet einen Download und einen Ladevorgang. Alles, was die Konsole tut, ist ein API-Aufruf, daher können Claude Code, Codex oder ein anderer Agent mit Shell-Zugriff diese Suche für Sie übernehmen, auf Ihrer Hardware, mit Ihrer Last.

Die Schleife

Die Tuning-Schleife GPUs erfassen, per Fit-Vorschau vor jedem Download passende Modelle vorauswählen, Kandidaten-Aufteilungen laden, sie mit echten Anfragen messen, die Einstellungen anpassen und die beste Variante geladen lassen. Messen und Anpassen wiederholen sich, bis der Agent zufrieden ist. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner Die Tuning-Schleife GPUs erfassen, per Fit-Vorschau vor jedem Download passende Modelle vorauswählen, Kandidaten-Aufteilungen laden, sie mit echten Anfragen messen, die Einstellungen anpassen und die beste Variante geladen lassen. Messen und Anpassen wiederholen sich, bis der Agent zufrieden ist. 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

Was der Agent aufruft: GET /api/system/gpus, POST /api/models/fit-preview vor jedem Download, Registrierung und suggest-config, Herunterladen und Laden, einen Stresstest, der die echte Kontextobergrenze findet und anwendet, GET /api/stats/v2/throughput und latency sowie einen Inferenzschlüssel, den er für Testverkehr ausstellt. Zuerst liest er /agent-guide.md, eine kurze Beschreibung dieser Aufrufe, geschrieben für ein Sprachmodell.

Ein laufender Modell-Ladevorgang auf der Seite Models: jeder Schritt mit bisheriger und üblicher Dauer
Was der Agent beobachtet, während eine Aufteilung lädt: jeder Schritt mit der üblichen Dauer aus früheren Ladevorgängen. Ein Ladevorgang, der keinen Fortschritt mehr macht, wird abgebrochen, und seine GPUs werden freigegeben.

Vier Prompts zum Einfügen, und was zurückkommt

  1. Erfassen und vorauswählen. Auftrag: meine GPUs auflisten, drei Open-Weight-Modelle für agentisches Programmieren vorauswählen, die mit mindestens 65.536 Token Kontext passen, jedes per Fit-Vorschau prüfen, nichts herunterladen. Sie erhalten: eine Tabelle mit Modell, Quantisierung, Engine, GPUs, Kontext und Begründung.
  2. Engine und Aufteilung für ein Modell. Auftrag: zwischen vLLM und llama.cpp sowie zwischen Tensor-Parallelität und datenparallelen Replikaten auf meinen Karten entscheiden; die besten zwei Aufteilungen laden, jeder dieselben 20 Streaming-Anfragen senden, bei Parallelität 1 und 8 vergleichen. Sie erhalten: Zeit bis zum ersten Token und Token pro Sekunde für beide, die bessere Aufteilung geladen, die andere entladen, den Testschlüssel widerrufen.
  3. Die echten Grenzen finden und anwenden. Auftrag: das geladene Modell einem Stresstest unterziehen, den gemessenen Kontext anwenden, dann bei Parallelität 1, 4 und 16 mit Prompts von etwa 2 Tsd. und 30 Tsd. Token messen. Sie erhalten: die Kontextobergrenze, eingetragen in die Einstellungen des Modells, und eine Tabelle mit Zeit bis zum ersten Token und Token pro Sekunde je Parallelität und Prompt-Größe.
  4. Zwei Kandidaten mit Ihrer eigenen Arbeit vergleichen. Auftrag: die Prompts in ./workload/*.txt bei Parallelität 4 erneut gegen Modell A und Modell B ausführen, jede Antwort bewerten. Sie erhalten: model-comparison.md mit Latenz, Token pro Sekunde, Korrektheit nach Einschätzung des Agenten und einer Empfehlung; das empfohlene Modell bleibt geladen.

Bevor Sie beginnen. Ein Admin-Token hat volle Admin-Rechte über den Warden (Modelle, Schlüssel, Einstellungen; feiner abgestufte Berechtigungen gibt es noch nicht): Geben Sie ihm eine kurze Laufzeit, und widerrufen Sie es unter Settings → Access Tokens, wenn die Aufgabe erledigt ist. Ein Stresstest bringt eine Engine absichtlich zum Absturz, um ihre Grenze zu finden: Führen Sie diese Prompts auf einem Warden aus, von dem niemand sonst abhängt. Downloads sind groß; die Prompts prüfen vor dem Herunterladen, ob das Modell passt, aber behalten Sie Ihren Speicherplatz im Blick.

Die Wahl von Engine und Aufteilung (vLLM, Tensor- oder Datenparallelität) gibt es in der Linux-Installation; auf einem Mac wählen Sie zwischen MLX und llama.cpp auf einer GPU. Das Modell, das die Optimierung übernimmt, kann jedes sein, für das Sie ohnehin bezahlen; optimiert wird das Modell auf Ihren Karten. Die Seite zum Agent-Tuning: alle vier Prompts im Wortlaut.

Ein GPU-Rechner für Ihr ganzes Team, Ihre Familie und Ihre Agenten.

Erstellen Sie so viele API-Schlüssel wie nötig, und verteilen Sie sie: an Kollegen, ein Familienmitglied, einen CI-Job, eine Agent-Farm, jeweils mit eigenem Schlüssel, eigener Priorität und eigener Nutzungsseite. Die Hardware arbeitet für alle, und die wichtige Arbeit muss nie warten.

Ihre Hardware, wie sie wirklich ist: vom Mac bis zu acht B300.

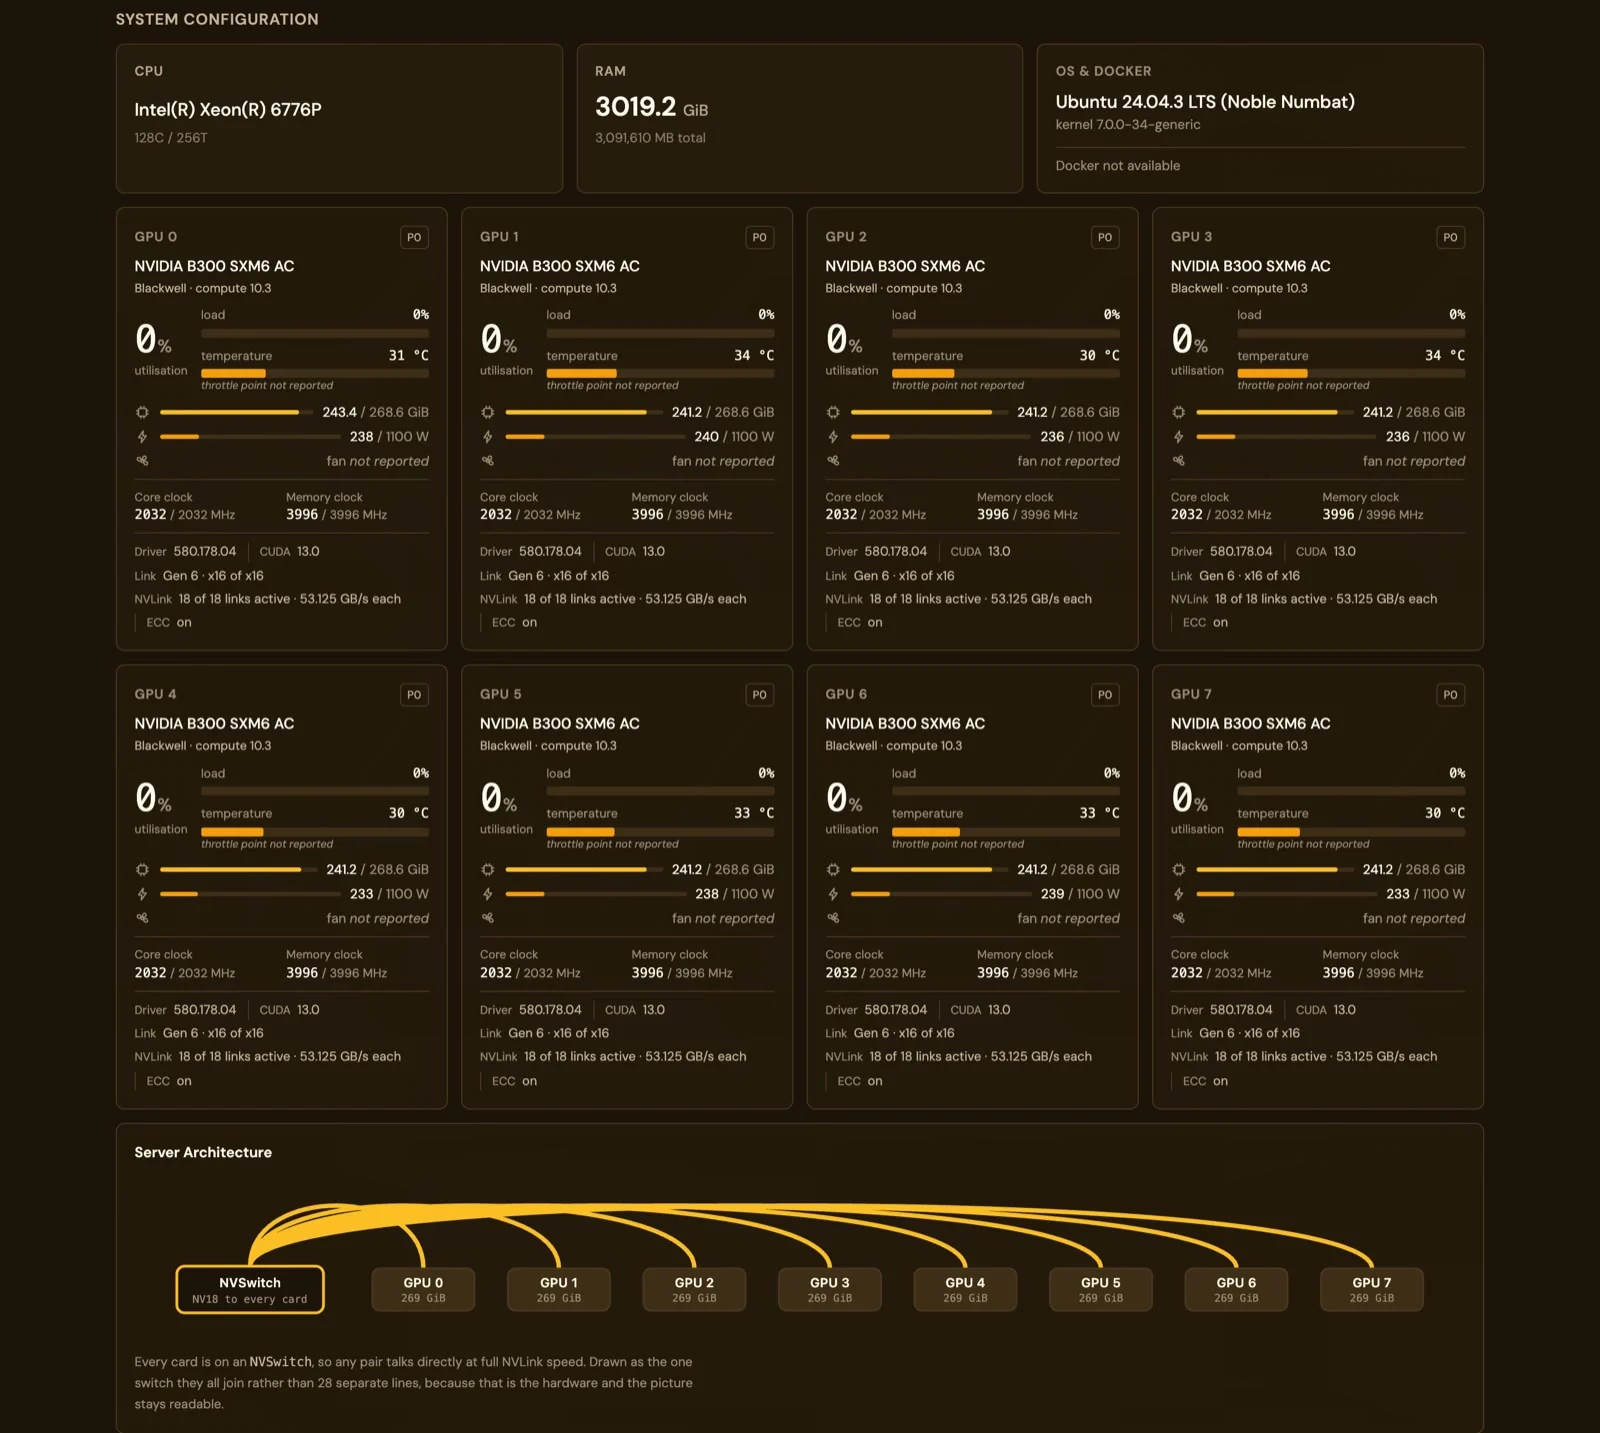
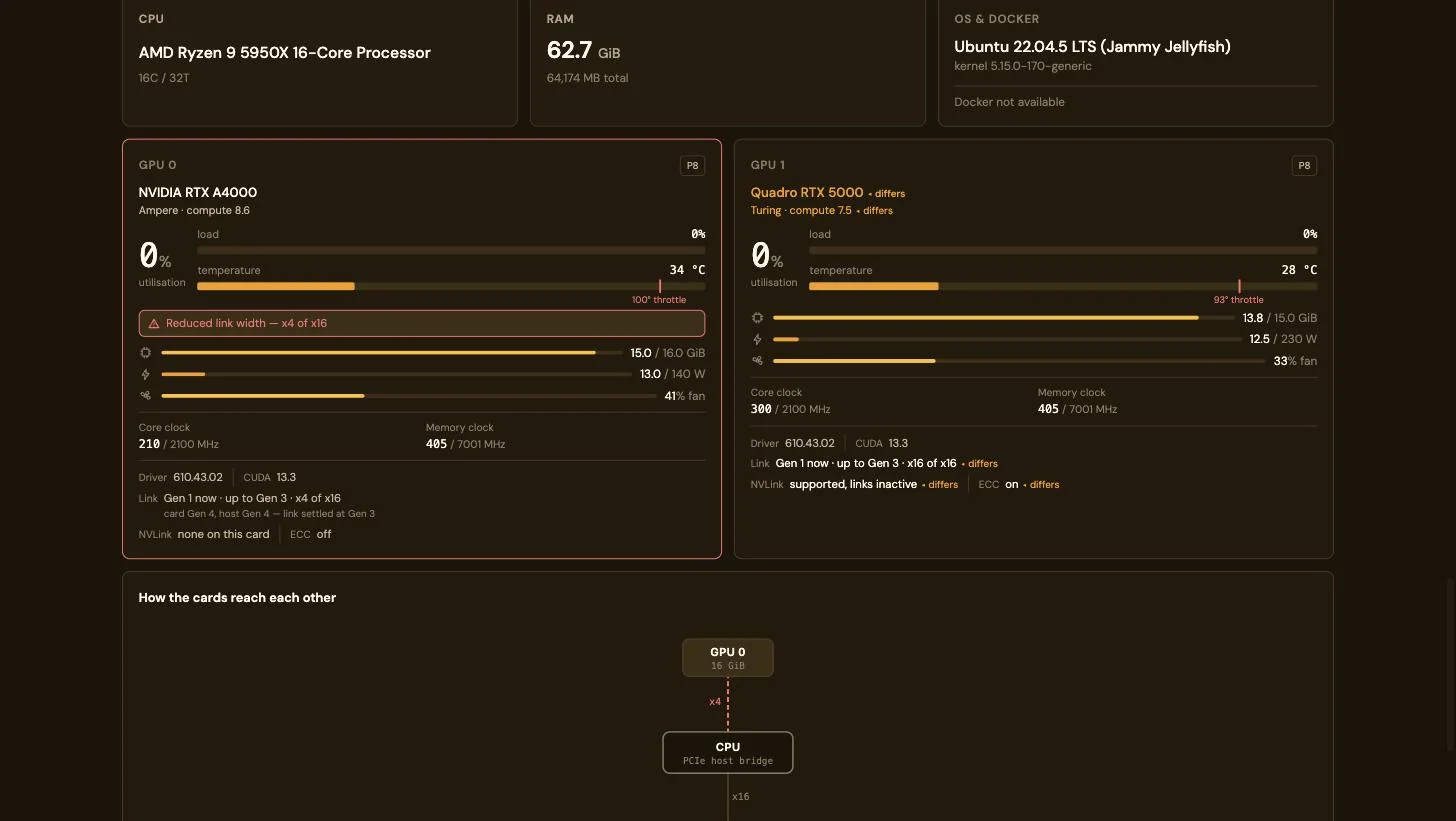
Dieselbe Konsole erfasst einen M1 mit 16 GB, zwei ungleiche Karten in einem Desktop-Rechner und einen NVSwitch-Server mit 8 × B300, und sie benennt den Engpass, statt ihn wegzumitteln: eine PCIe-Verbindung, die nur mit x4 statt x16 ausgehandelt wurde, inaktive NVLink-Verbindungen, ECC, das sich zwischen Karten unterscheidet.

Systemkonfiguration auf einem Server mit 8 × B300: Intel Xeon 6776P, 3019 GiB RAM, acht Panels für NVIDIA B300 SXM6, jedes mit 241 von 268,6 GiB belegt, Link Gen 6 x16 von x16, NVLink 18 von 18 Links aktiv mit je 53,125 GB/s, ECC an und eine Zeichnung der Serverarchitektur mit einem NVSwitch, der mit jeder Karte verbunden ist
Acht Karten B300 SXM6 an einem NVSwitch: 18 von 18 NVLink-Verbindungen aktiv pro Karte, ECC an, PCIe Gen 6 x16, 241 von 268,6 GiB belegt pro Karte beim Bereitstellen von GLM-5.2 NVFP4 mit Tensor-Parallelität 8.
Zwei ungleiche GPUs: eine NVIDIA RTX A4000 mit einer roten Warnung Reduced link width x4 of x16 und Link Gen 1 now, up to Gen 3, neben einer Quadro RTX 5000, deren Architektur, VRAM, Leistungsgrenze, Link, NVLink und ECC jeweils als differs markiert sind; darunter eine Zeichnung, wie die Karten die CPU über Verbindungen mit x4 und x16 erreichen
Zwei Karten, Jahre auseinander gekauft: Die Verbindung der A4000 läuft nur mit x4 statt x16 und ist rot markiert; Architektur, Leistungsgrenze, NVLink (unterstützt, Verbindungen inaktiv) und ECC der Quadro sind jeweils als differs markiert. Die Zeichnung zeigt, welcher Steckplatz der schmale ist.
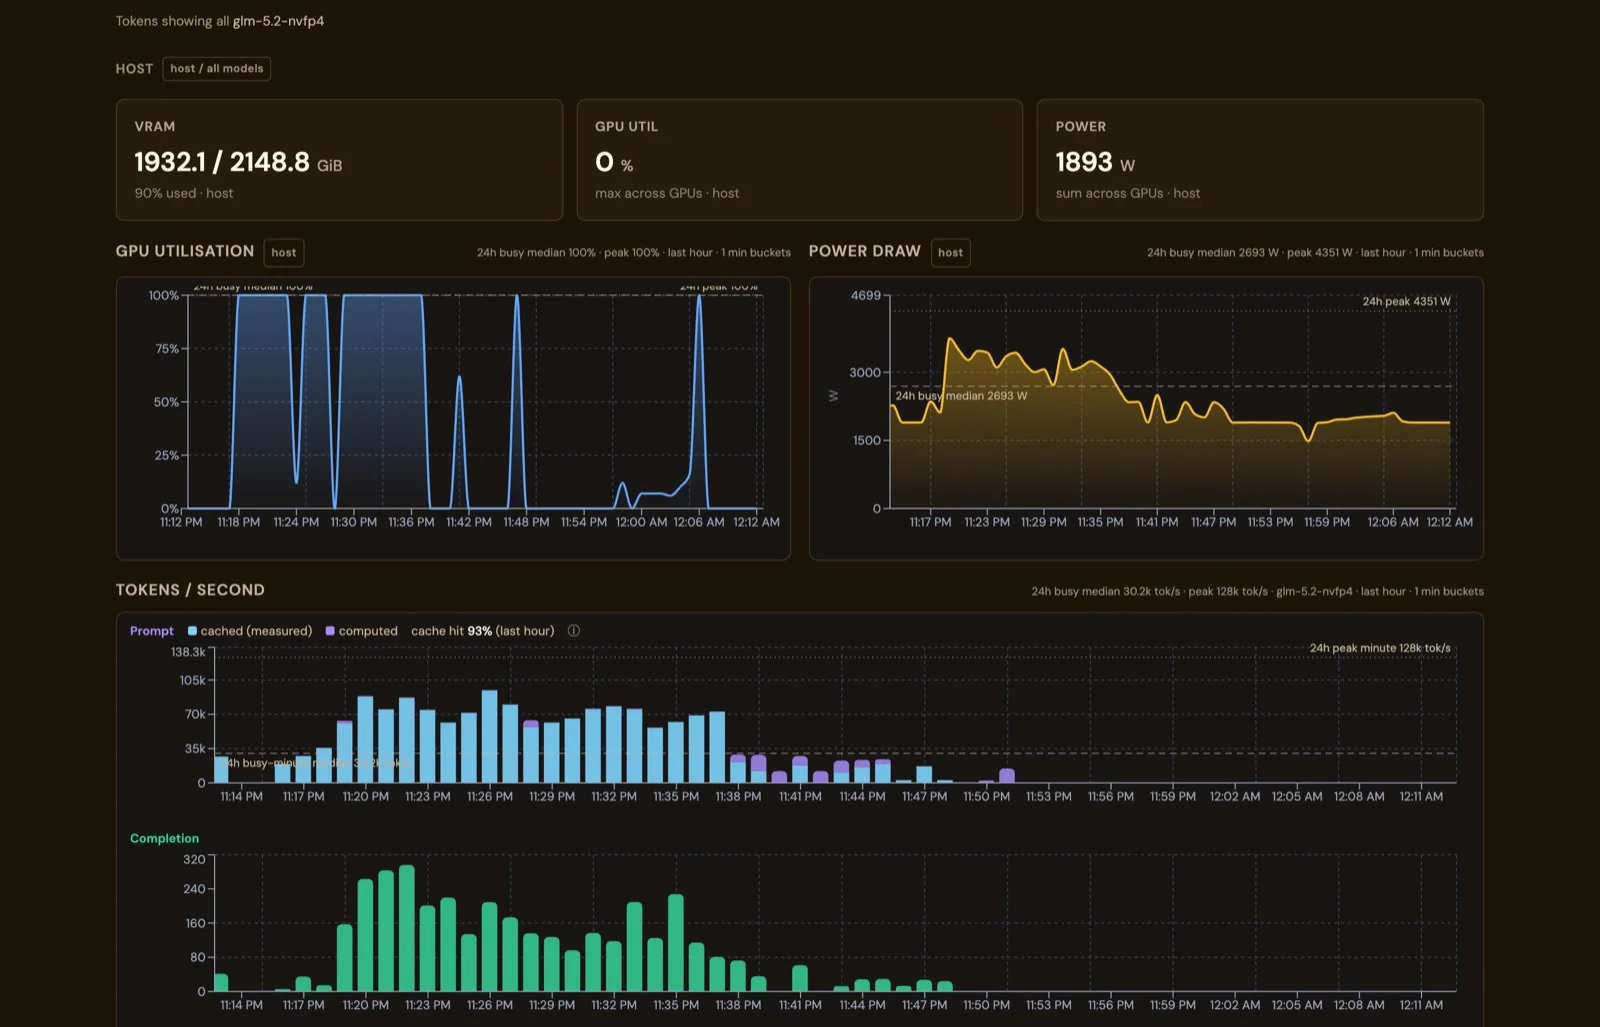
Stats auf dem Server mit 8 × B300: VRAM 1932,1 von 2148,8 GiB, Leistungsaufnahme 1893 W summiert über die Karten, GPU-Auslastung und Leistungsaufnahme der letzten Stunde sowie Prompt-Token pro Sekunde, aufgeteilt in gecacht und berechnet, mit 93 % Cache-Treffern
Dieselbe Stats-Seite am oberen Ende des Hardware-Spektrums: 1.932 von 2.149 GiB VRAM, 1.893 W über alle Karten, eine Spitze von 4.351 W innerhalb der Stunde und 93 % der Prompt-Token aus dem Cache.
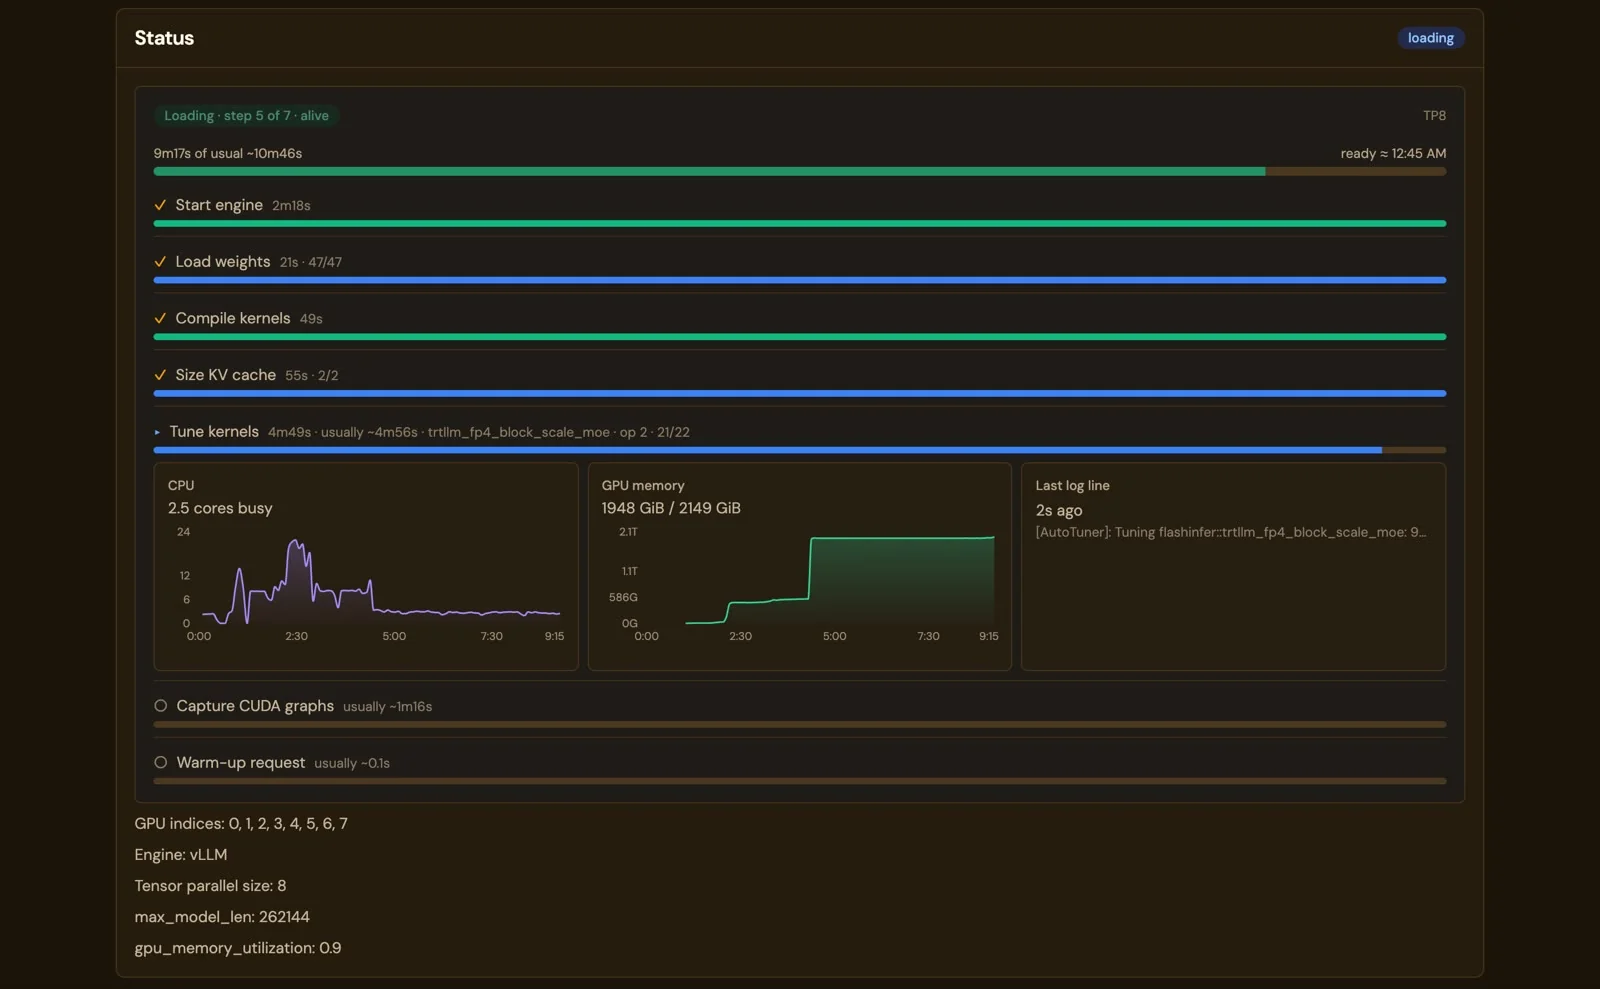
Die Modellseite, während GLM-5.2 NVFP4 auf acht B300 lädt: 9 min 17 s von üblicherweise 10 min 46 s, die Schritte Start engine, Load weights 47 of 47, Compile kernels und Size KV cache erledigt, Tune kernels bei op 21 of 22, mit Diagrammen für CPU und GPU-Speicher und der letzten Logzeile
Ein Ladevorgang von 10 Minuten, Schritt für Schritt: GLM-5.2 NVFP4 auf acht B300, 9 min 17 s von üblicherweise 10 min 46 s, nichts wird rot markiert, solange es vorangeht.

Was jedes Panel pro Karte zeigt: Temperatur im Verhältnis zur eigenen Drosselschwelle, Leistungsaufnahme im Verhältnis zur Leistungsgrenze, Takte, Lüfter, PCIe-Generation und -Breite, wie gerade ausgehandelt, ECC und NVLink, sofern die Karte sie hat, und den Prozess, der den Speicher belegt. Die Zeichnung der Verbindungen wird aus nvidia-smi topo -m gelesen. Auf einem Mac: GPU-Nutzung und das Speicherbudget, das Metal meldet, ohne Leistungsaufnahme. Und die Engine unter alldem wird über ihren eigenen /health-Endpunkt überwacht, nicht über ihre Prozesstabelle: Eine tote Engine unter einem noch laufenden Wrapper wird neu geladen, und die Diagnosedaten bleiben erhalten.

Was LM Warden anzeigt

GPU-Monitoring

Jede Karte meldet ihre eigenen Werte.

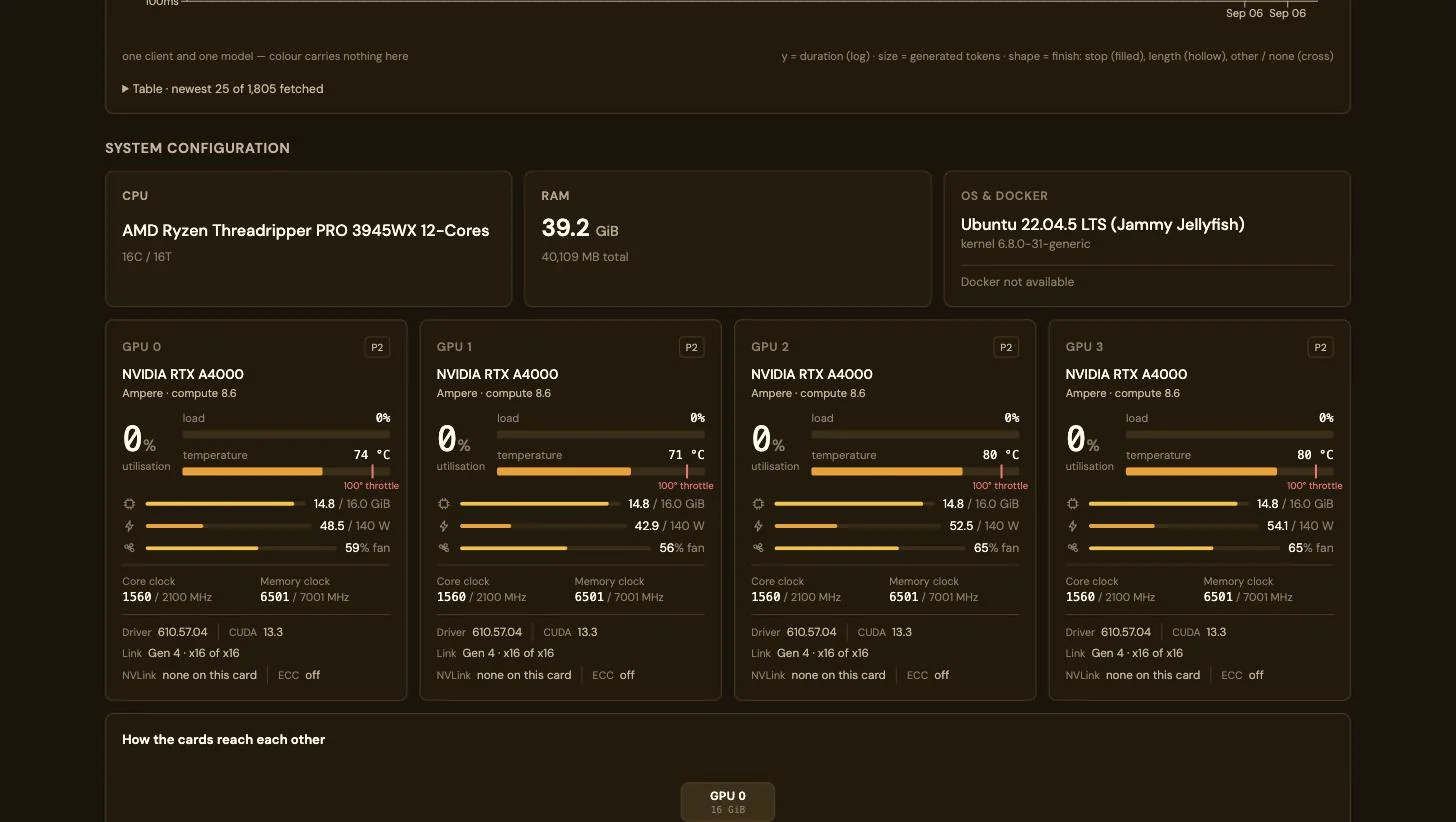
Auslastung, Temperatur im Verhältnis zur eigenen Drosselschwelle der Karte, Leistungsaufnahme im Verhältnis zu ihrer Grenze, VRAM, Takte, PCIe-Verbindung und welcher Prozess den Speicher belegt. Kein Durchschnitt über den ganzen Rechner.

Systemkonfiguration und vier GPU-Panels für Karten vom Typ NVIDIA RTX A4000 mit Auslastung, Temperatur, VRAM, Leistungsaufnahme, Lüfter und Takten pro Karte

Laufende Anfragen

Sehen Sie, was jeder Agent gerade tut.

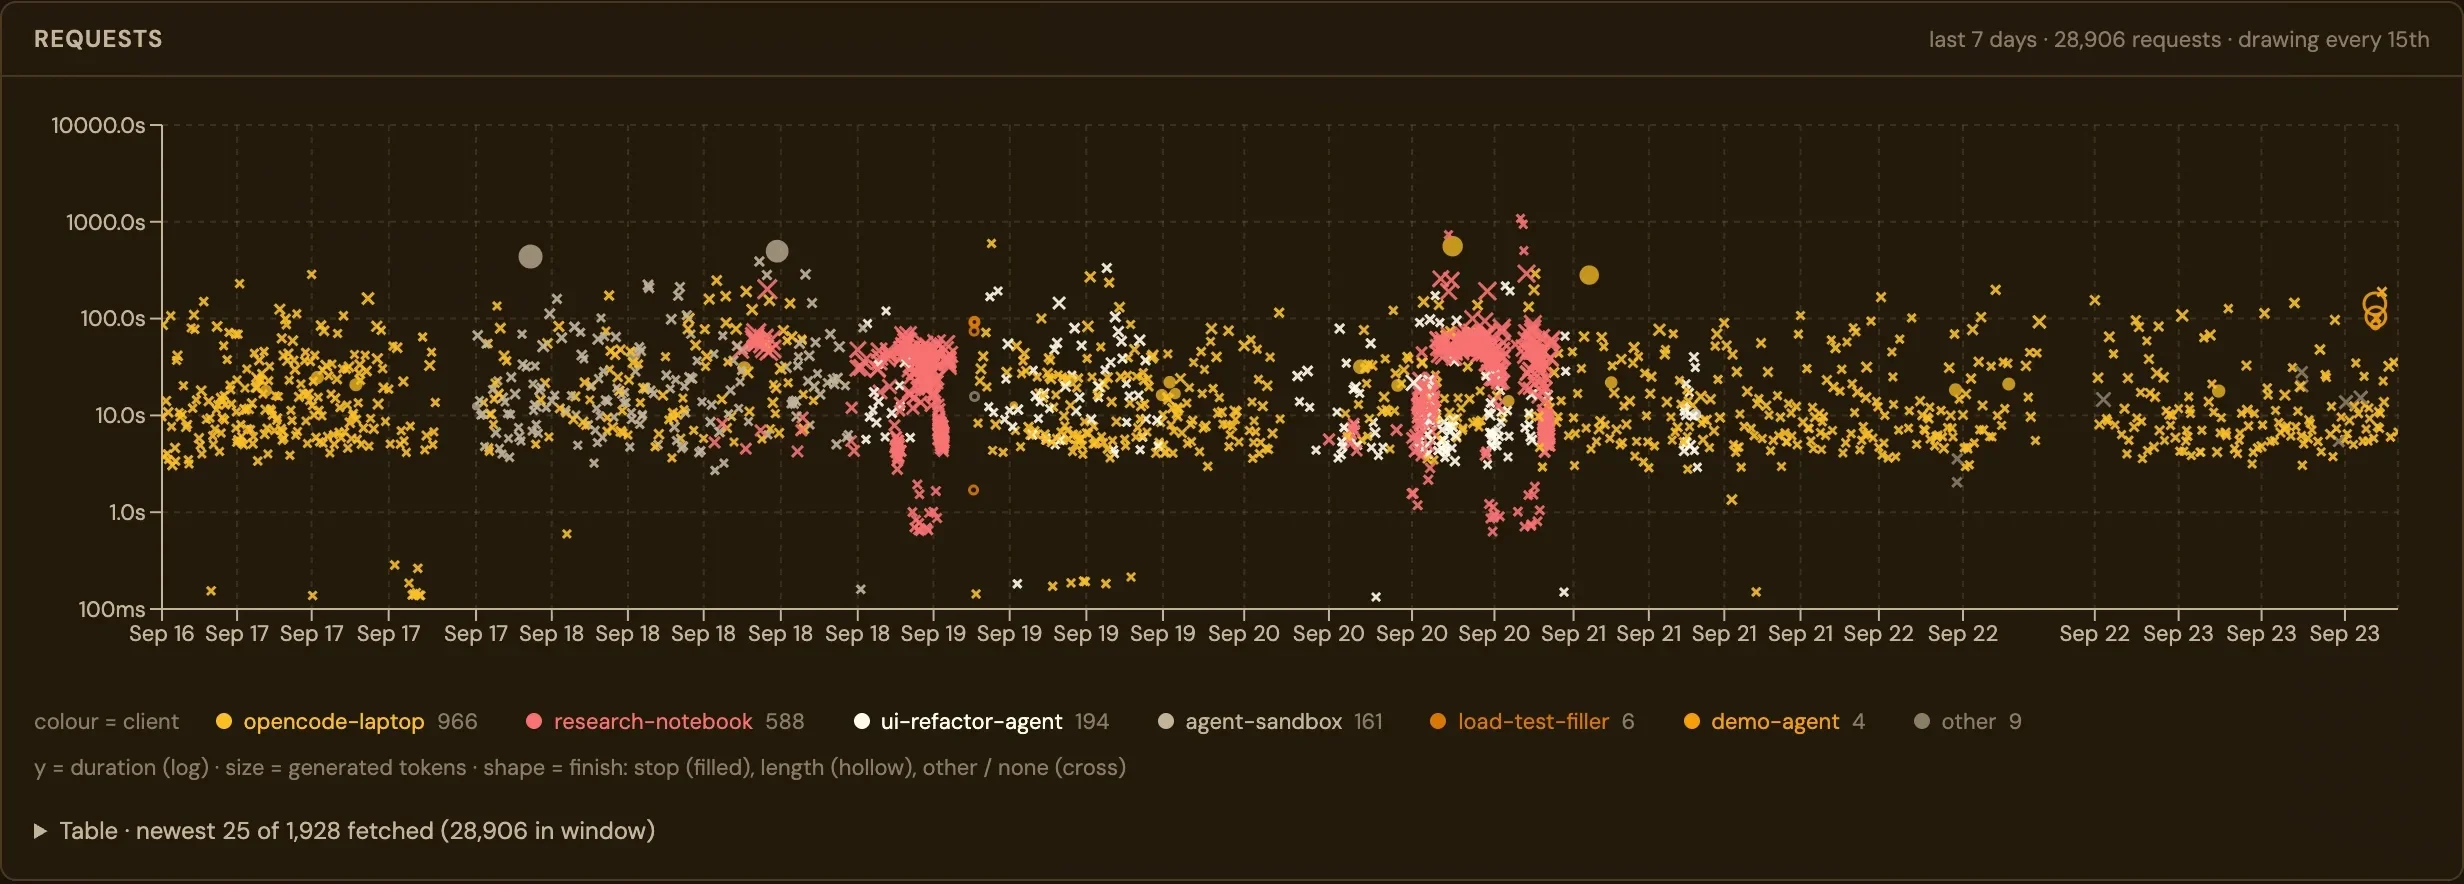
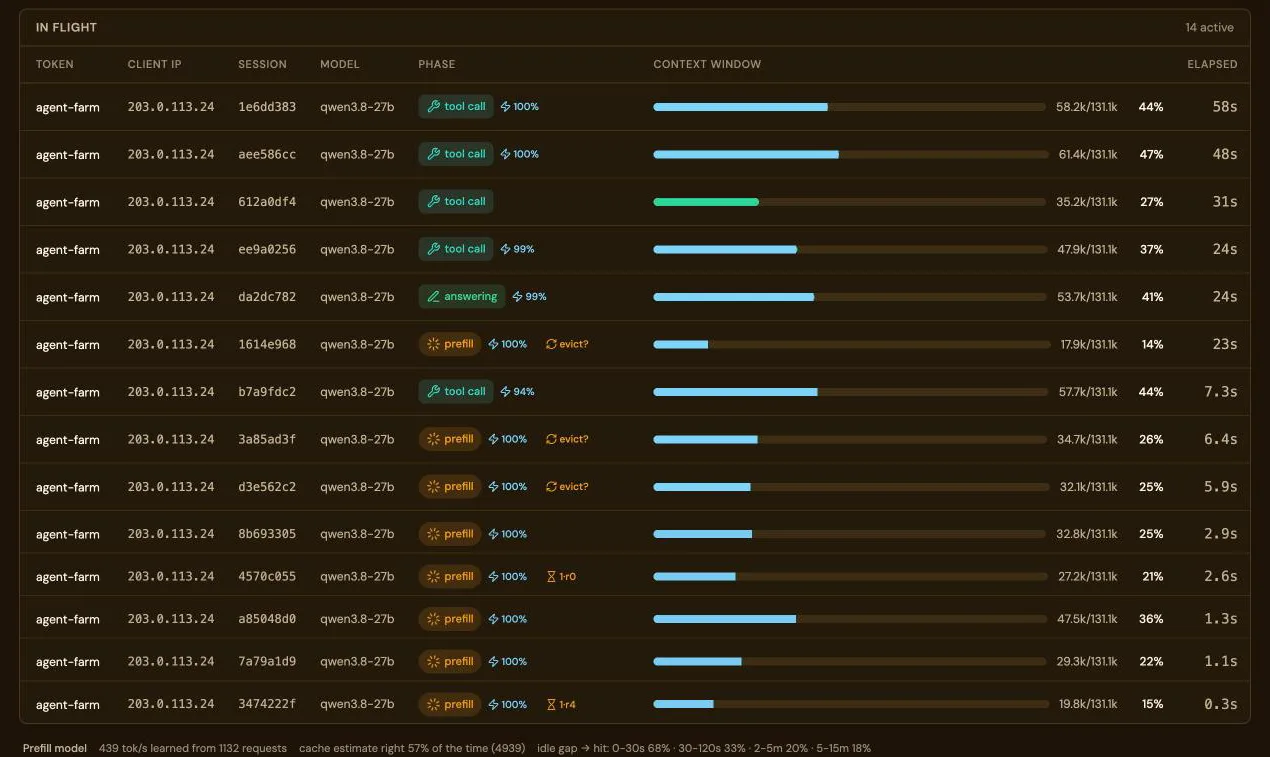
Jede Anfrage mit ihrem Schlüssel, ihrer Sitzung und ihrer Phase: in der Warteschlange, Prefill, Denken, Tool-Aufruf, Antworten. Wie viel von jedem Prompt aus dem Präfix-Cache kam, pro Anfrage gemessen.

Die Tabelle der laufenden Anfragen: zehn aktive Anfragen, jede mit Schlüssel, Sitzung, Phase und Token

Coding-Agenten

Claude Code, Codex und OpenCode, angebunden über eine einzige Seite.

Connect erzeugt die Konfiguration jedes Tools mit der Adresse dieses Wardens, einem Schlüssel und einem geladenen Modell, prüft die Anforderungen anhand dessen, was tatsächlich geladen ist, und sendet eine Testanfrage.

Die Seite Connect a client mit ausgewähltem Claude Code und geprüften Anforderungen

Kostenlos, Open Source und offen entwickelt.

LM Warden steht unter Apache-2.0 auf GitHub: Das Installationsskript und die Compose-Datei sind das gesamte Deployment, und Sie können beide lesen. Kein Konto, keine Lizenzprüfung, keine Telemetrie. vLLM, llama.cpp und MLX sind Upstream-Projekte, die wir unverändert ausführen.

mlx-rust-lm demnächst

Eine Portierung von Apples mlx-lm von Python nach Rust, auf Basis der offiziellen mlx-c-Bindings von Apple, entwickelt und gepflegt vom Team von LM Warden als eigenständiges Open-Source-Projekt. LM Warden wird es als dritte Mac-Engine nutzen, und es soll schließlich die Python-Engine mlx-lm ersetzen, die den Großteil des heutigen Mac-Downloads ausmacht. Inoffiziell, keine Verbindung zu Apple.