LM Warden

让你的 GPU 像托管 API 一样对外提供服务。

LM Warden 在你自己的硬件上运行 vLLM、llama.cpp 或 MLX,并在其前端提供一个兼容 OpenAI 的端点:每个应用一个密钥,每个密钥的用量,以及每块 GPU 的实时面板。可运行于配备 NVIDIA 显卡的 Linux 主机,或 Apple 芯片 Mac。

开源,Apache-2.0无需账户,无遥测Linux + NVIDIA · macOS(测试版)· Windows 开发中
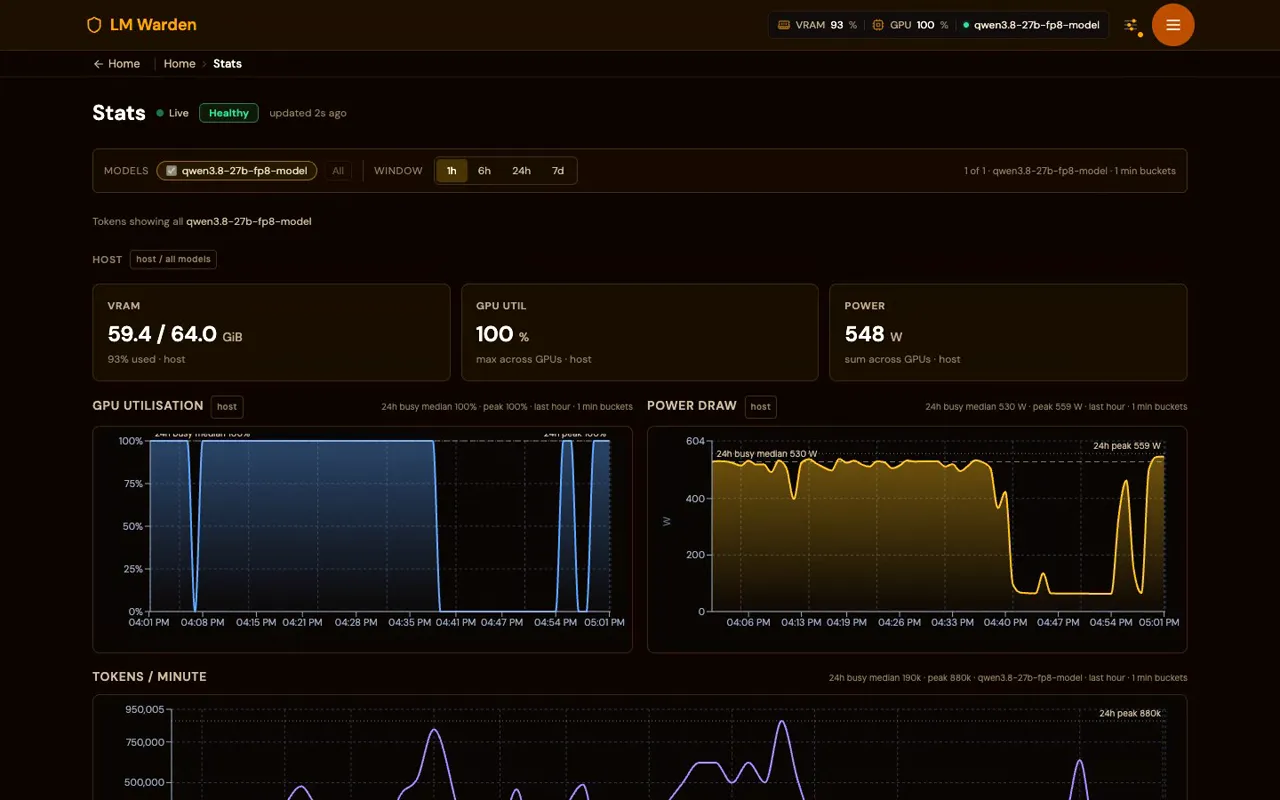
繁忙的 LM Warden 实例的 Stats 页面:VRAM 已用 59.4/64 GiB,GPU 利用率 100%,功耗 548 W,以及过去一小时的 GPU 利用率、功耗和每分钟 token 数图表
  • Linux · NVIDIA vLLM v0.32.0 和 llama.cpp b11719 基于 CUDA
  • macOS · Apple 芯片 MLX 和 llama.cpp 基于 Metal
  • API OpenAI、Anthropic Messages 和 Responses 同一端点提供
  • 编程智能体 Claude Code、Codex CLI、OpenCode 及另外 7 款 自动配置

人们用它来做什么

你要在哪里运行它?

在上方选择一个平台查看其步骤,或显示全部四种。

在 GPU 主机上运行一条命令。

curl -fsSL https://raw.githubusercontent.com/Podwarden/lm-warden/main/install.sh | sh -s -- --dir /opt/vllm-warden
  • x86_64 主机、Docker Compose v2.24+、NVIDIA Container Toolkit,以及 Turing 或更新架构的显卡。
  • 然后打开 http://HOST:8080/ui/,完成首次运行向导,添加模型,创建密钥。你的端点是 http://HOST:8080/v1。
  • 一台主机里有多块 GPU:使用张量并行,或每块卡一个副本并配合缓存感知路由。
  • 目前支持 NVIDIA。AMD ROCm 和 Intel GPU 支持即将推出,尚无日期。告诉我们你想在哪种硬件上运行:Radeon · Intel。
  • 安装指南 · 离线 / 物理隔离 · 从源代码安装 · 升级
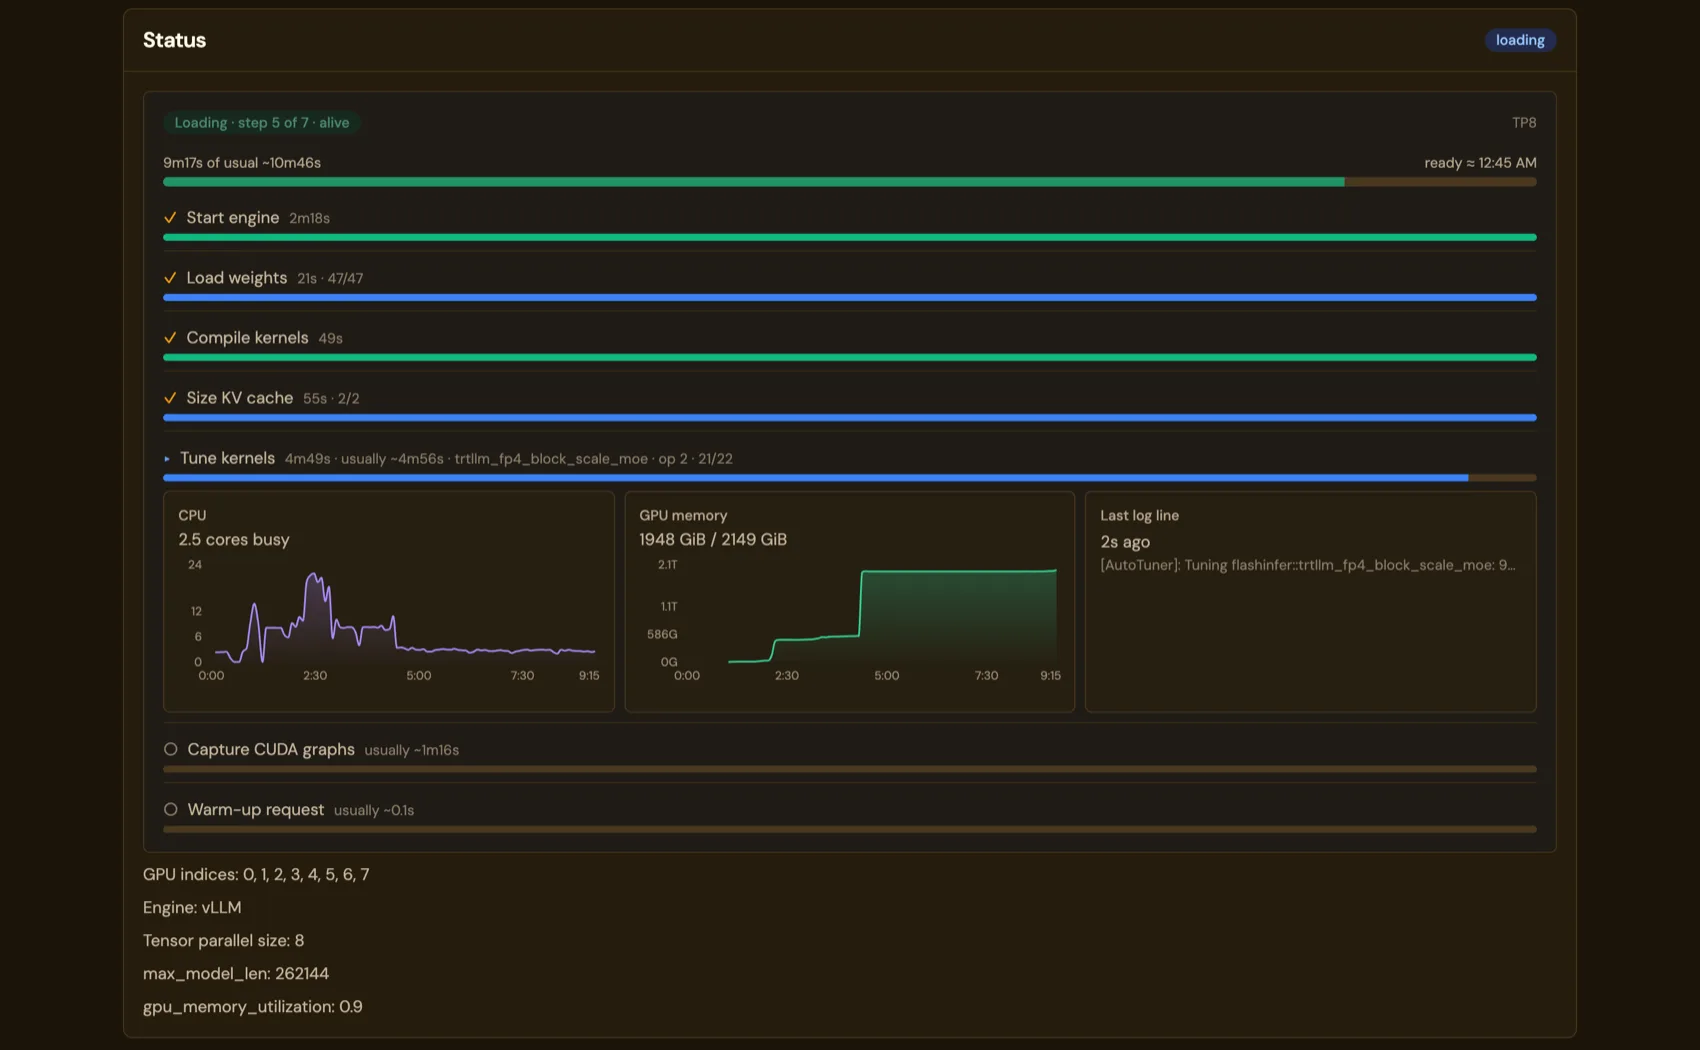
Models 页面上正在加载模型,每个步骤都显示已用时间和通常耗时
安装后加载模型:每个步骤都附有以往加载的通常耗时。

菜单栏应用,测试版。

下载 Mac 版(测试版)

  • 约 110 MB。Apple 芯片(M1 或更新机型),macOS 14 或更高版本。SHA-256 · 发行说明。
  • 引擎:MLX 和基于 Metal 构建的 llama.cpp。同样的控制台和同样的 OpenAI API;没有 vLLM,也没有功耗读数。
  • 坦白说,这是测试版:它采用临时签名且未经公证,因此首次启动时 macOS 会要求你在“隐私与安全性”中允许它运行;更新需要重新下载。首次启动步骤。
  • 在你选择 Share on Local Network 之前,只在 127.0.0.1 上提供服务。
  • 即将推出:mlx-rust-lm,第三个引擎。LM Warden 团队正在基于 Apple 官方的 mlx-c 绑定,把 Apple 的 mlx-lm 从 Python 移植到 Rust;它将与 MLX 和 llama.cpp 并行运行,并最终取代 Python 版 mlx-lm 引擎——如今的下载包大部分就是它连同 Python 及其库。非官方项目,与 Apple 无关。
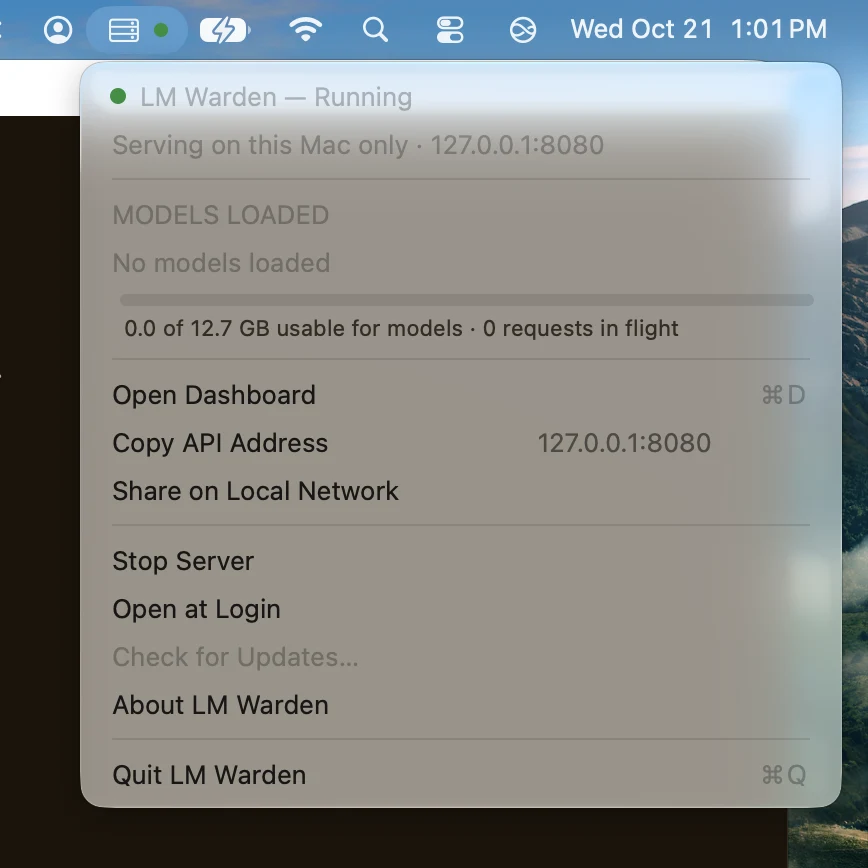
Mac 上的 LM Warden 菜单栏菜单:Running,仅在本机 127.0.0.1:8080 上提供服务,未加载模型,一个内存用量条,以及 Open Dashboard、Copy API Address、Share on Local Network
测试版在 16 GB M1 上的菜单栏菜单。

下一个是 Windows。目前没有日期。

我们正在开发,哪天有了可用版本就放到这里,而不是先放一个注册表单。在那之前,有两个实在的选择:

  • 在 Linux GPU 主机上运行 LM Warden,然后从 Windows 使用它:所有 OpenAI 客户端、Claude Code 和 Codex 都可以通过网络连接。
  • 在 GitHub 上关注发布,第一时间获知首个 Windows 版本。
  • AMD Radeon 和 Intel GPU 会在之后支持;告诉我们你想在哪种硬件上运行:Radeon · Intel。

一体机:即将推出,尚无日期。

运行 LM Warden 的第四种方式,适合一台只做这件事的主机。

  • 把 USB 启动盘插入装有 GPU 的机箱。它会安装一个只做一件事的精简 Linux:运行 LM Warden。
  • 它会为你配置网络和模型存储。
  • 可以在线(OTA)接收更新,也可以完全物理隔离运行。
  • 专为安全的专用 LLM 服务器打造:适合想要一台锁定主机的团队,或没有外网出口的站点。

在它发布之前,上面的 Linux 安装能在你自己搭建的主机上完成同样的工作,包括离线 / 物理隔离安装。在 GitHub 上关注发布。

暂无图片:还没有产品名称或硬件可展示,我们也不会凭空画一个。

已经在用了?Linux 可原地升级:拉取新镜像,重启,数据库会自动迁移到新版本。步骤 · 更新日志。

自托管会遇到八个问题。下面逐一展示解决之后的样子。

单独运行的推理引擎只能在一个端口上提供一个模型。下面是 LM Warden 在引擎之外补齐的部分,凡有自测数据的都一并给出。

  1. 这个模型放得进我的 GPU 吗?

    把 Hugging Face 仓库粘贴到 Add model 中。每个文件都会列出针对你所勾选显卡的结论:放得下、余量紧张或放不下。勾选更多显卡,可用显存会相应累加。在有能放下的文件之前,不会下载任何内容。
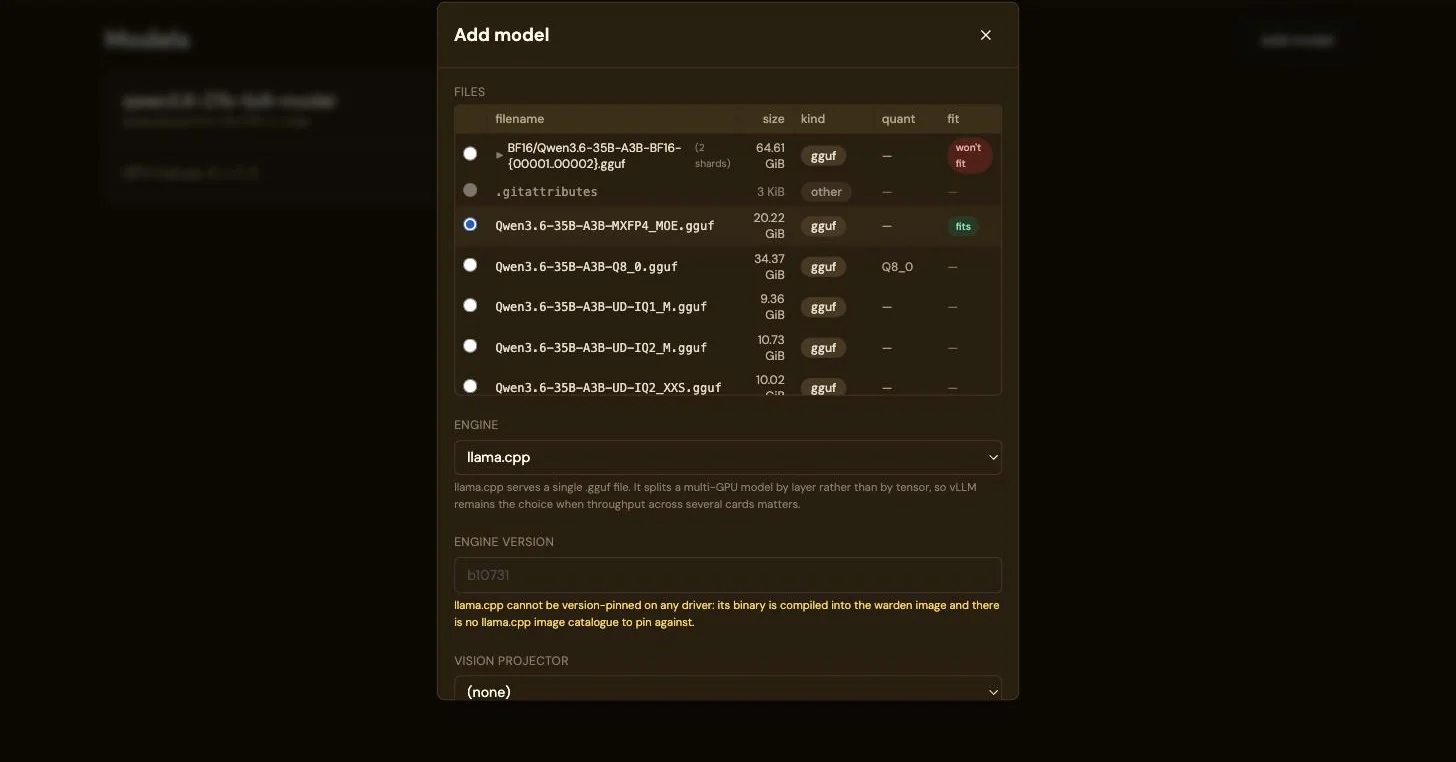
    同一个 20.22 GiB 的文件,在选中四块 GPU 后被标记为放得下
  2. 你买了 GPU。它们是在干活还是在等待?

    吞吐量 = 并发数 × 提示词长度 × 缓存复用,而单独运行的推理引擎无法把这些放在一起展示。Stats 页面可以,范围从 1 h 到 7 d:VRAM、GPU 利用率、功耗(Linux)、每秒 token 数(提示词 token 分为已缓存和需计算两部分)、p50/p95 延迟、提示词缓存命中率、抢占、按密钥和按客户端 IP 统计的请求数。队列积压而利用率上不去,说明“需要更高并发”;缓存占比低,说明“需要固定会话”。
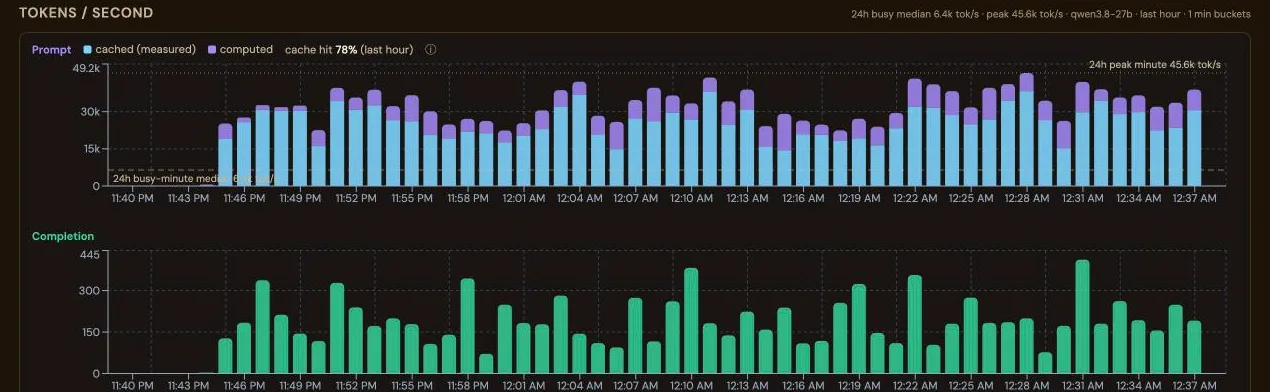
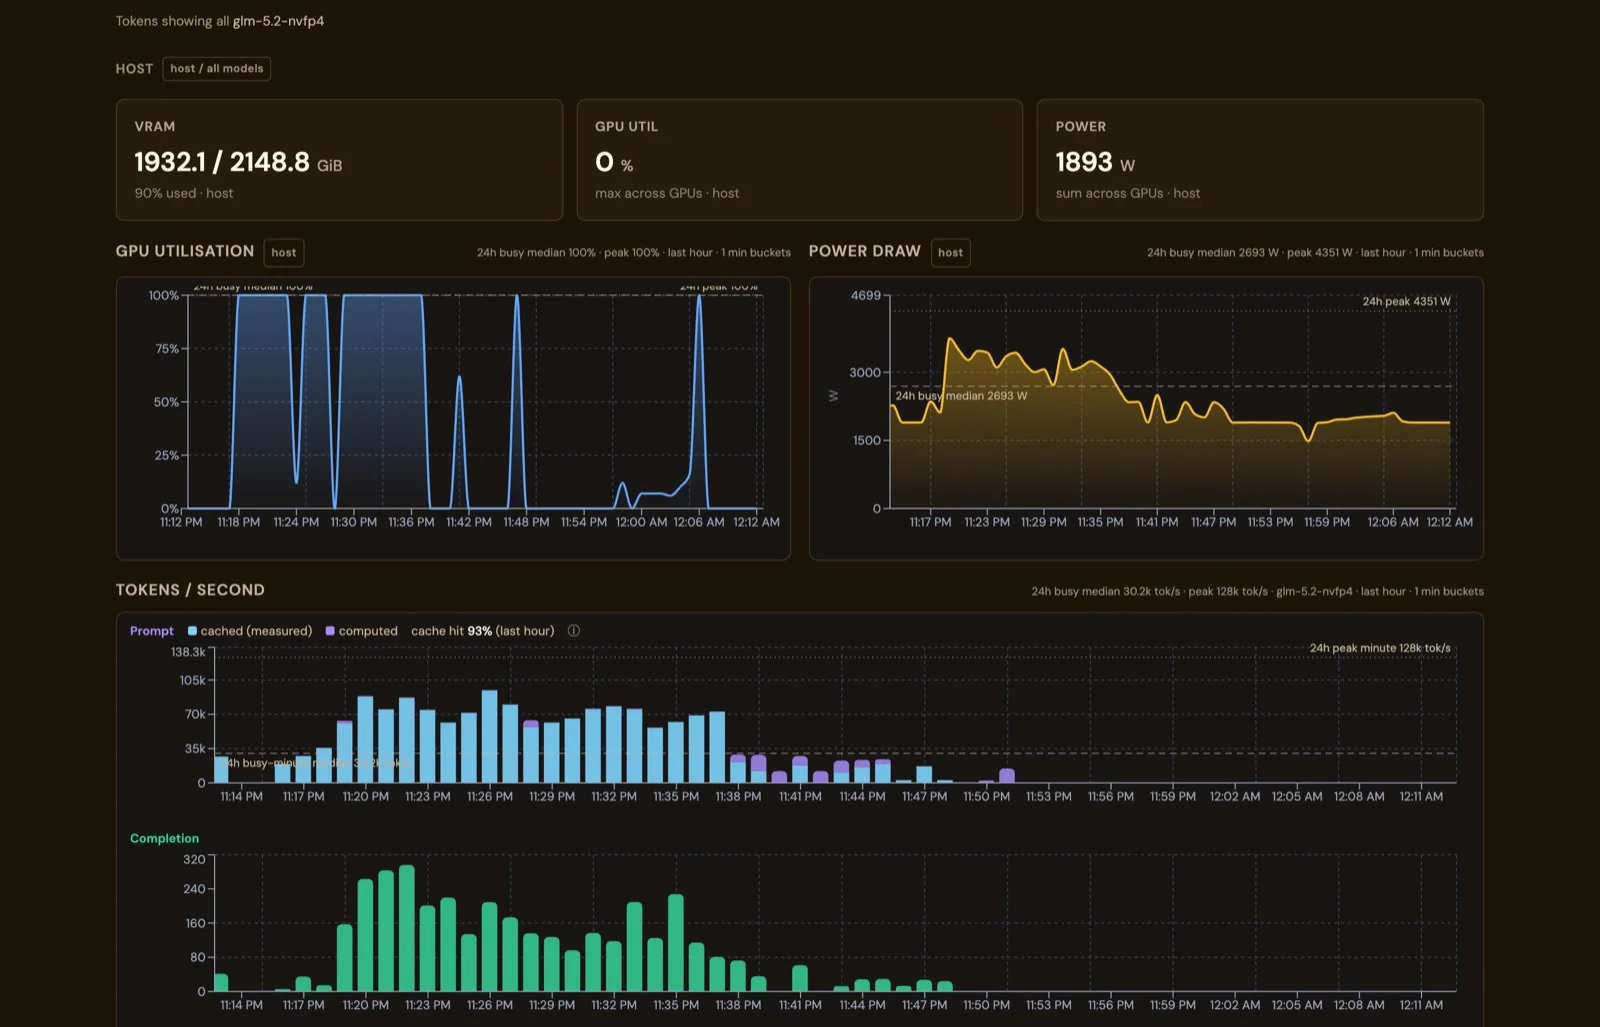
    每秒 token 数:提示词 token 分为已缓存和需计算两部分,下方为补全 token
  3. 在接入任何东西之前,先和模型聊聊。

    聊天和其他功能在同一个窗口中。流式 Markdown,支持代码高亮和数学公式;视觉模型每条消息最多可附带八张 PNG、JPEG 或 WebP 图片;每个聊天可设置温度、top-p、最大 token 数和系统提示词,并保存为默认值;聊天会被保留、自动命名,并且可以分叉。模型发出的工具调用会被渲染出来,因此你可以在智能体依赖工具调用之前先检查它。
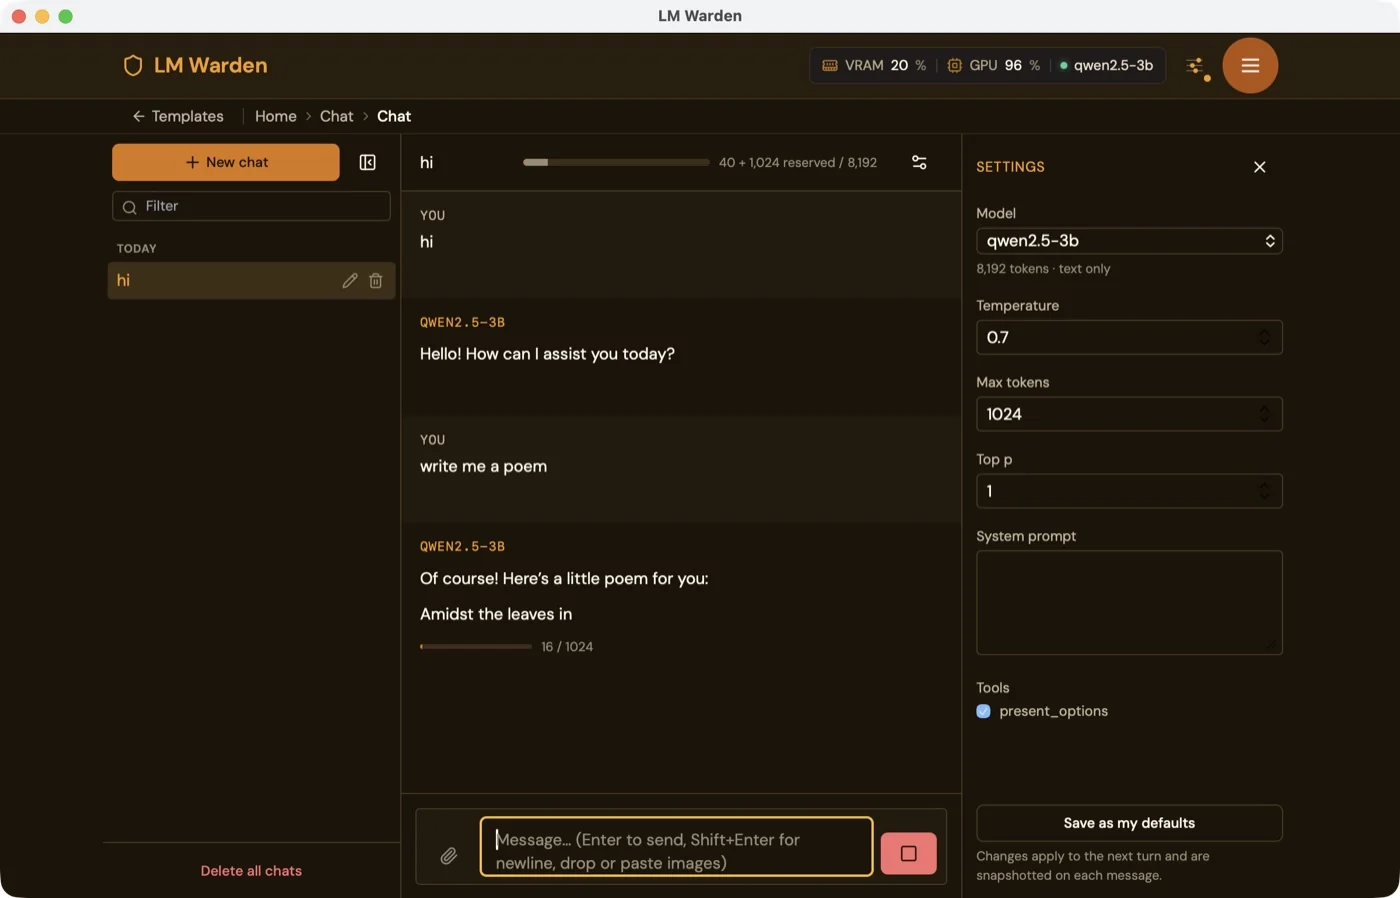
    Mac 应用控制台窗口中的聊天,正在从 qwen2.5-3b 流式输出,标题栏显示 GPU 96%
  4. 模型究竟看到了什么,又说了什么?

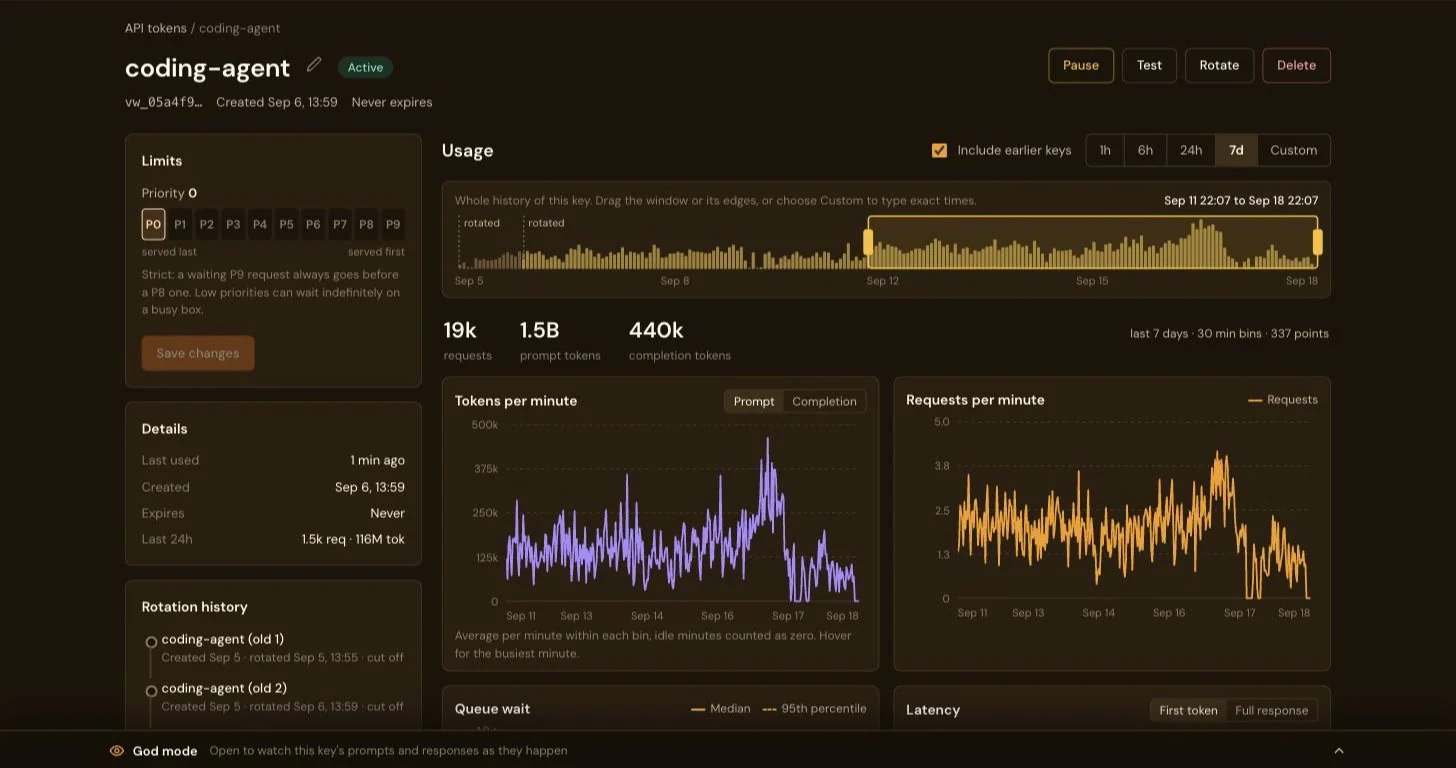
    God mode 用于调试提示词:在部署中开启 VW_GODMODE_ENABLED 后,每个密钥的页面都会出现一个停靠面板,实时流式显示该密钥的提示词和补全内容。默认关闭,关闭时完全不存在。它是一个有容量上限的内存环形缓冲区:不写入数据库或磁盘,重启即消失。任何拥有管理员会话的人都能打开它;warden 只有一个管理员角色,没有其他角色。
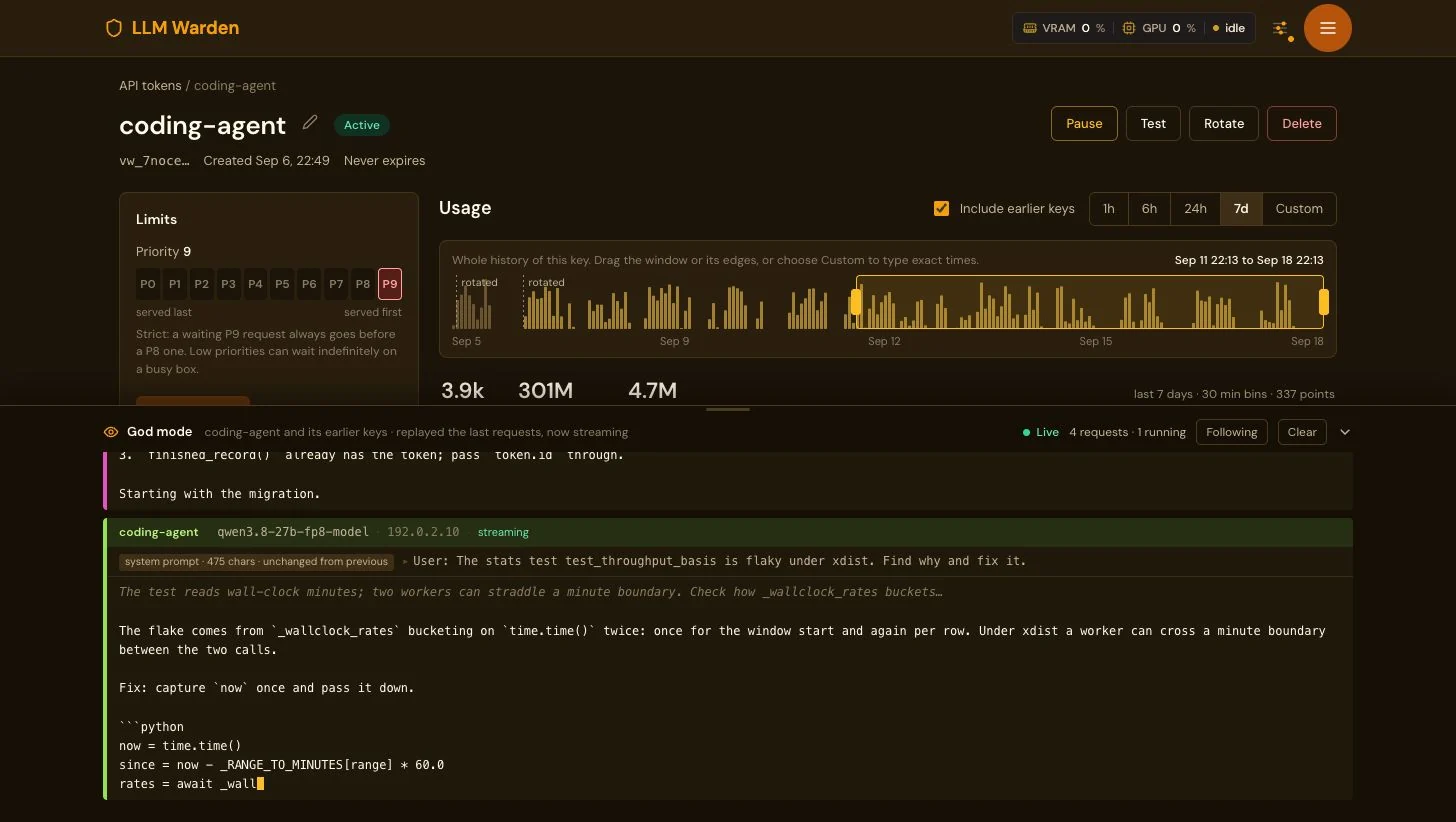
    API 密钥 coding-agent 的页面,底部打开了 God mode 停靠面板:Live、4 个请求、1 个正在运行;一个来自 192.0.2.10 的 qwen3.8-27b-fp8 请求正在流式输出,显示了关于一个不稳定的 stats 测试的用户提示词,以及模型正在写出的包含 Python 修复的回复

智能体的每一轮都会重读整个对话。

智能体每一轮都会重新发送全部历史,所以长对话的大部分内容是引擎已经读过的前缀。vLLM 会把这部分工作保存在前缀缓存中,但只保存在完成这项工作的副本上,而它自带的负载均衡器会把每一轮发给队列最短的副本。LM Warden 把每个新对话放到负载最低的副本上并让它留在那里,使用的是 Claude Code 本来就会发送的会话 ID。只有当该副本超过溢出阈值时,它才会转移请求。

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
一个对话的四轮请求,模型有四个副本。使用 vLLM 的负载均衡器时,每一轮都在接到它的副本上几乎从头预填充(把提示词读入缓存)。使用 LM Warden 时,对话一直留在副本 2 上,只有新的一轮需要预填充。这是机制示意图,不是测量结果。

在我们的四卡主机上实测(4 × RTX A4000,Qwen3-4B 作为四个单卡副本,模拟 Claude Code 风格的会话,先关闭亲和性再开启,两组连续运行):把对话固定到副本后,在 4 个并发会话时,从缓存提供的提示词 token 占比从 56% 升至 86%,首字节时间中位数从 2.05 降至 0.38 s。在我们测试的每一级中,每分钟输出 token 数都更高,p95 首字节时间(最慢的 5%)也都更低。实际在工作的副本数几乎没变(4 个会话时为 2.71 对 2.83,总共四个):收益来自缓存复用,而不是更多显卡投入工作。

Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
每一级的前缀缓存命中率:从缓存提供的提示词 token 数除以请求的提示词 token 数,四个副本合计,取自该级期间 vLLM 自身计数器的变化。只要还有余量,收益就会保持;到 32 个会话时对话开始溢出,收益随之消失。
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
4 到 32 个并发会话下的首字节时间,包括中位数和 p95,采用对数刻度,以便亚秒级和长达一分钟的数值能放在一起对比。开启亲和性后,在 16 个会话以内中位数要低得多(4 个会话时为 0.38 对 2.05 s),在 24 和 32 个会话时更高;p95 在每一级都更低,不过在 16 个会话时差距(24.9 对 26.2 s)在每组只跑一次的噪声范围之内。在客户端测量,经由互联网,计到第一个流式 token。

逐级加压:亲和性关闭 → 开启

SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

在我们的四卡主机上用一个小模型测量,先关闭亲和性,再开启,中间没有重启 vLLM:第二组开始时前缀缓存已经预热,两组的提示词都来自同一个随机种子。每一级持续 3 分钟,因此只能完成 9 到 31 个会话,多一个或少一个会话就会让每小时会话数变化 20;每分钟输出 token 数是更稳定的一列。你的模型、显卡和工作负载会有所不同;模型页面上的副本卡片会为你的环境显示同样的计数器。
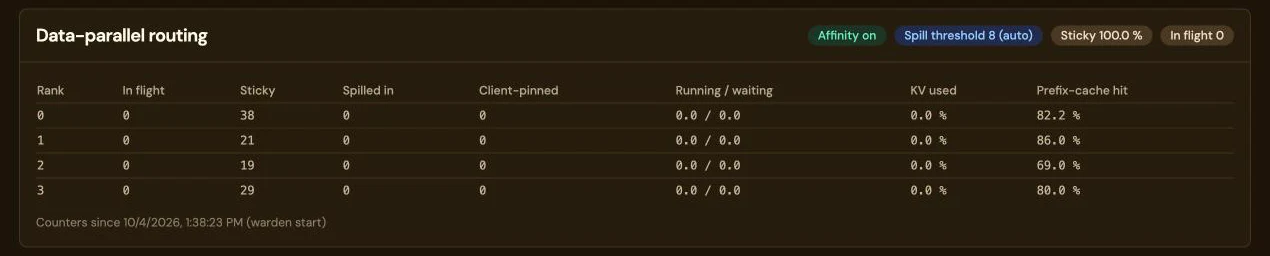
模型页面上的数据并行路由卡片,带有标签 Affinity on、Spill threshold 8 (auto)、Sticky 100.0% 和 In flight 0。表格列出副本 0 到 3 的进行中、粘滞(38、21、19 和 29)、溢入、客户端固定、运行中和等待中、已用 KV 以及前缀缓存命中率(82.2、86.0、69.0 和 80.0%),还有一行说明计数器从 warden 启动时开始累计。
模型页面上的同一组计数器:每个副本一行,显示它持有的请求、有多少对话留下(sticky)或通过溢出到达、正在运行和等待的请求、使用中的 KV 缓存以及前缀缓存命中率。记录于 2026 年 10 月 4 日,亲和性开启,溢出阈值为 8(自动):sticky 100%,副本 0 到 3 的前缀缓存命中率分别为 82.2%、86.0%、69.0% 和 80.0%。图中是控制台里的计数卡片,并非基准测试结果。点按卡片可放大。

代价在哪里。24 和 32 个会话这两级是有意让四块小显卡过载,每个副本都已饱和。输出仍然更高(每分钟 11,178 对 9,048 和 16,638 对 14,760 个 token),长尾延迟也短得多(p95 38 对 59 s,以及 39 对 83 s),但开启亲和性后首字节时间中位数更差:24 个会话时为 13.1 对 5.1 s,32 个会话时为 27.7 对 12.3 s。我们尚未查明原因,把溢出阈值从 8 降到 4 也没有改变这一点。

在繁忙的主机上两种都测一下。有余量时优势最大;长期满负荷运行的主机应该把两种设置都测一遍,亲和性可以按模型关闭。副本以及这种路由属于配备 NVIDIA GPU 的 Linux 安装;Mac 应用(测试版)不支持张量并行或数据并行。

完整方法:工作负载、压测工具、溢出阈值,以及此后一直按此方式运行的一台七卡主机 →

让你的编程智能体使用你自己的 GPU。

十款编程智能体只需一个 base URL 和一个密钥即可连接;其中两款还能继续用付费的 Claude 订阅处理更难的任务。

保留你的 Claude 订阅,把常规调用交给本地模型

Claude Code 和 Anthropic SDK 通过路由器接入。由一条规则指定由你的 GPU 应答哪些 Claude 模型;其余请求以你自己的登录或密钥发往 Anthropic。
Claude Code 请求的去向 智能体把每个请求都发给 LM Warden 的路由器。针对 claude-haiku 模型的请求会转到你 GPU 上的某个模型,并以该模型的身份应答。其他所有模型(包括 Opus)都以你自己的登录转发给 Anthropic。 Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* your GPUanswers as that model everything else,Opus included Anthropicon your own login Claude Code 请求的去向 智能体把每个请求都发给 LM Warden 的路由器。针对 claude-haiku 模型的请求会转到你 GPU 上的某个模型,并以该模型的身份应答。其他所有模型(包括 Opus)都以你自己的登录转发给 Anthropic。 Claude Codeor Anthropic SDK LM Warden routerrules, first match winsyour key stays yours claude-haiku* everythingelse, Opusincluded your GPUanswers as that model Anthropicon your own login
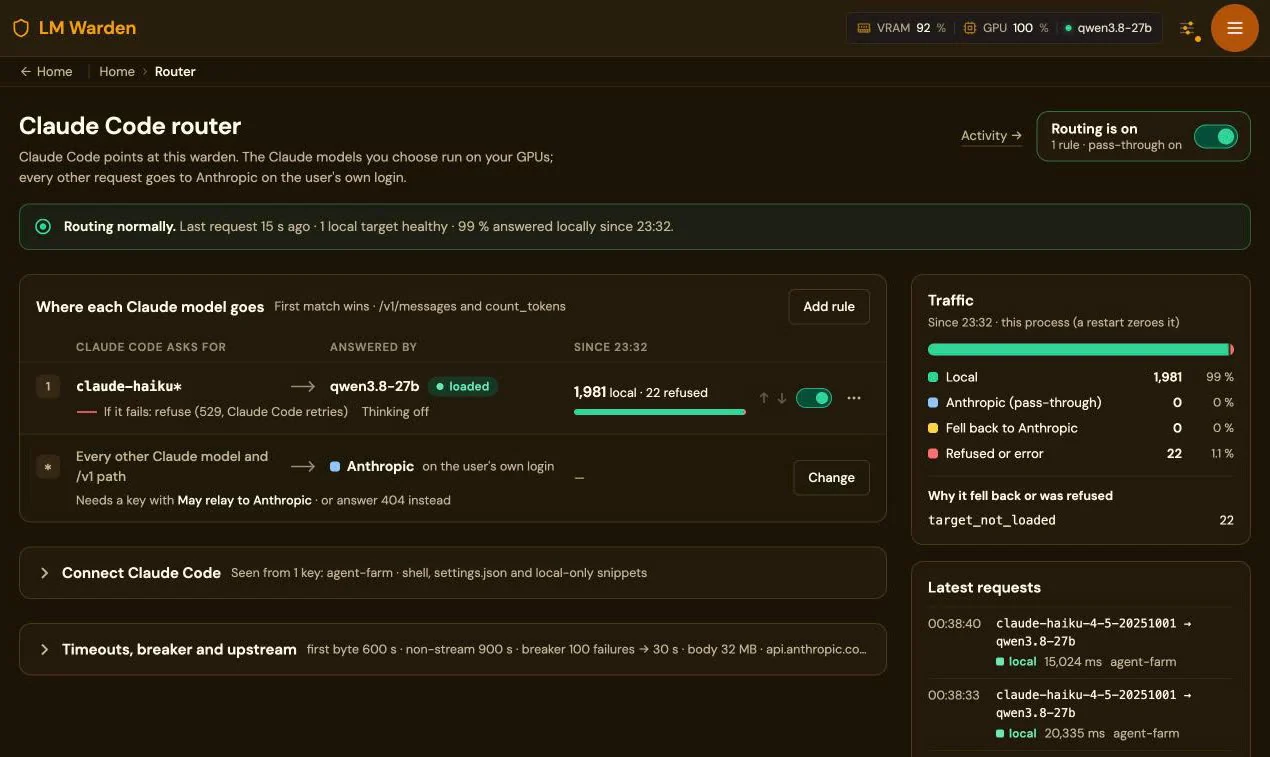
1,981 个请求在本地应答,占该主机自重启以来 Claude Code 流量的 99%。数据来自我们自己那台七卡主机的 Router 页面,2026 年 10 月 21 日;另有 22 个请求因目标模型未加载而被拒绝。
Claude Code 路由器页面:路由已开启,自 23:32 起 99% 在本地应答;规则 1 将 claude-haiku* 发往 qwen3.8-27b,本地 1,981 个、拒绝 22 个;其他所有 Claude 模型以用户自己的登录发往 Anthropic
Claude Code 2.1.227 或更新版本:ANTHROPIC_BASE_URL 指向 warden,warden 密钥放在 ANTHROPIC_CUSTOM_HEADERS 中,你的登录保持不变。我们尚未对回答质量做基准测试:请把常规、需求明确的工作交给本地模型。

Connect 会写好每个客户端的配置并发送测试请求。

在控制台中选择客户端、密钥和一个已加载的模型;它会根据实际加载的内容逐项检查要求(上下文窗口、工具调用、路由器是否开启),并给出可直接粘贴的文件。所有编程智能体,每个客户端一个页面,写明哪些可用以及我们观察到的情况。
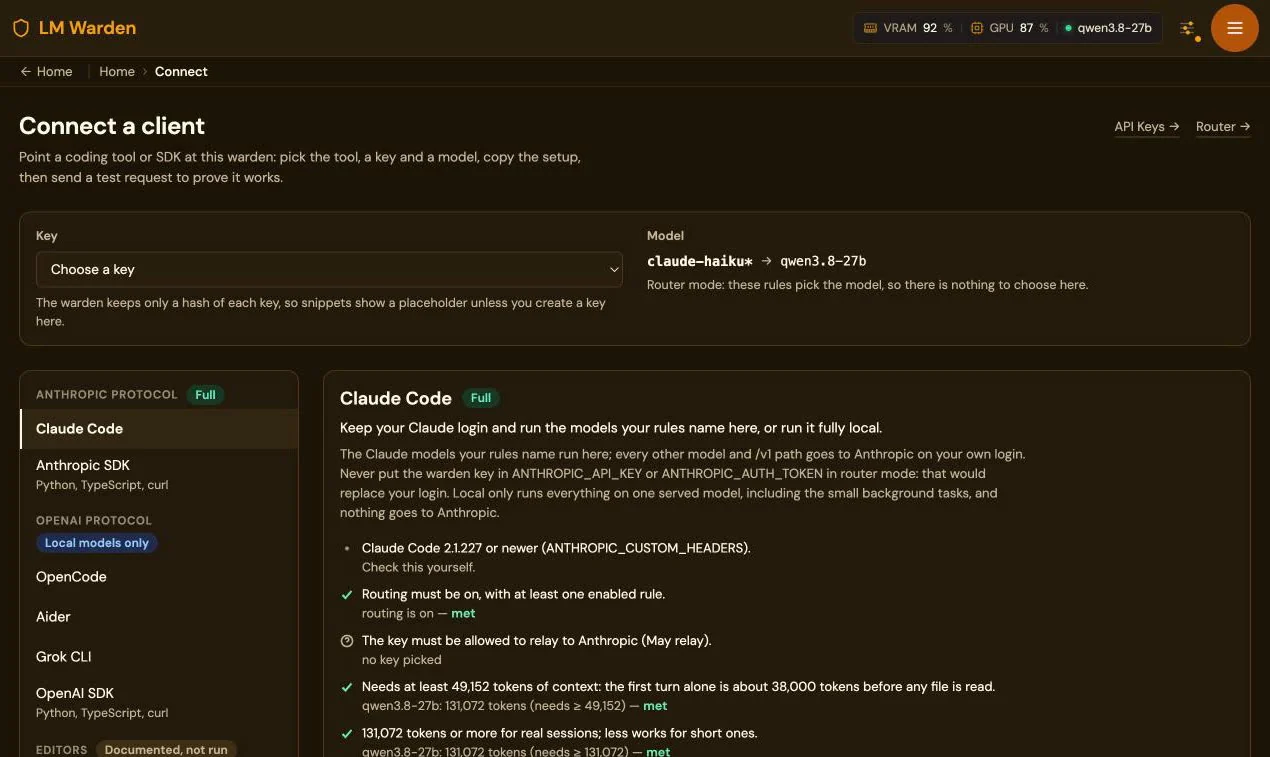
Connect a client 页面:密钥选择器、将 claude-haiku* 发往 qwen3.8-27b 的路由规则、按协议分组的客户端,以及已检查完各项要求的 Claude Code 面板

让你已经付费的 AI 来调优你自己的 GPU。

为你的显卡选模型,意味着要选择量化方式、引擎、如何在多块 GPU 间切分、给多大上下文以及 KV 缓存类型;每次猜测都要花一次下载和一次加载。控制台的每项操作都是一次 API 调用,因此 Claude Code、Codex 或其他能使用 shell 的智能体可以在你的硬件上、针对你的工作负载替你完成这项搜索。

循环流程

调优循环 盘点 GPU,在下载之前用适配预览筛选模型,加载候选切分方案,用真实请求做基准测试,调整设置,并让最优方案保持加载。基准测试和调整会反复进行,直到智能体满意为止。 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner 调优循环 盘点 GPU,在下载之前用适配预览筛选模型,加载候选切分方案,用真实请求做基准测试,调整设置,并让最优方案保持加载。基准测试和调整会反复进行,直到智能体满意为止。 1 Surveyyour GPUs 2 Shortlistfit-preview first 3 Loadcandidate layouts 4 BenchmarkTTFT, tokens/s 5 Adjustone thing at a time repeat until it stops improving 6 Keepthe winner

智能体会调用:GET /api/system/gpus,在任何下载之前调用 POST /api/models/fit-preview,注册并调用 suggest-config,拉取并加载,一次压力测试(找出并应用真实的上下文上限),GET /api/stats/v2/throughput 和 latency,以及它签发的用于发送测试流量的推理密钥。它会先读取 /agent-guide.md,这是一份为语言模型编写的这些调用的简短说明。

Models 页面上正在加载模型:每个步骤都显示已用时间和通常耗时
加载某个切分方案时,智能体关注的内容:每个步骤都附有以往加载的通常耗时。停滞不前的加载会被终止,其 GPU 随之释放。

四条可直接粘贴的提示词,以及你会得到什么

  1. 盘点并筛选。要求:列出我的 GPU,筛选三个适合智能体编程、能在至少 65,536 个 token 上下文下放得下的开放权重模型,用适配预览逐一检查,什么都不下载。你会得到:一张包含模型、量化方式、引擎、GPU、上下文和理由的表格。
  2. 为一个模型选择引擎和切分方式。要求:在我的显卡上决定用 vLLM 还是 llama.cpp,用张量并行还是数据并行副本;加载最好的两种方案,向每种发送同样的 20 个流式请求,在并发 1 和 8 下比较。你会得到:两者的首 token 时间和每秒 token 数,胜出方案保持加载,另一个被卸载,测试密钥被吊销。
  3. 找出真实上限并应用。要求:对已加载的模型做压力测试,应用测得的上下文,然后在并发 1、4 和 16 下,用约 2k 和 30k token 的提示词做基准测试。你会得到:写入模型设置的上下文上限,以及一张按并发数和提示词大小列出首 token 时间和每秒 token 数的表格。
  4. 用你自己的工作比较两个候选模型。要求:在并发 4 下,把 ./workload/*.txt 中的提示词分别重放给模型 A 和模型 B,并评判每个回答。你会得到:model-comparison.md,包含延迟、每秒 token 数、智能体评判的正确性和推荐结论;推荐的模型保持加载。

开始之前。管理员令牌拥有 warden 的全部管理权限(模型、密钥、设置;目前没有更细的权限范围):请给它设置较短的有效期,并在任务完成后到 Settings → Access Tokens 中吊销。压力测试会故意让引擎崩溃以找到其上限:请在没有其他人依赖的 warden 上运行这些提示词。下载量很大;提示词会在拉取前检查是否放得下,但请留意磁盘空间。

引擎和切分方式的选择(vLLM、张量并行或数据并行)仅适用于 Linux 安装;在 Mac 上可选的是单 GPU 上的 MLX 或 llama.cpp。负责调优的模型可以是你已经付费的任何模型;被调优的模型是你显卡上的那个。智能体调优页面:四条提示词全文。

一台 GPU 主机,由你的整个团队、家人和智能体共享。

API 密钥想建多少就建多少,然后分发出去:同事、家人、CI 任务、智能体集群,各自拥有自己的密钥、优先级和用量页面。硬件为所有人工作,重要的工作永远不必等待。

如实展示你的硬件状况:从一台 Mac 到八块 B300。

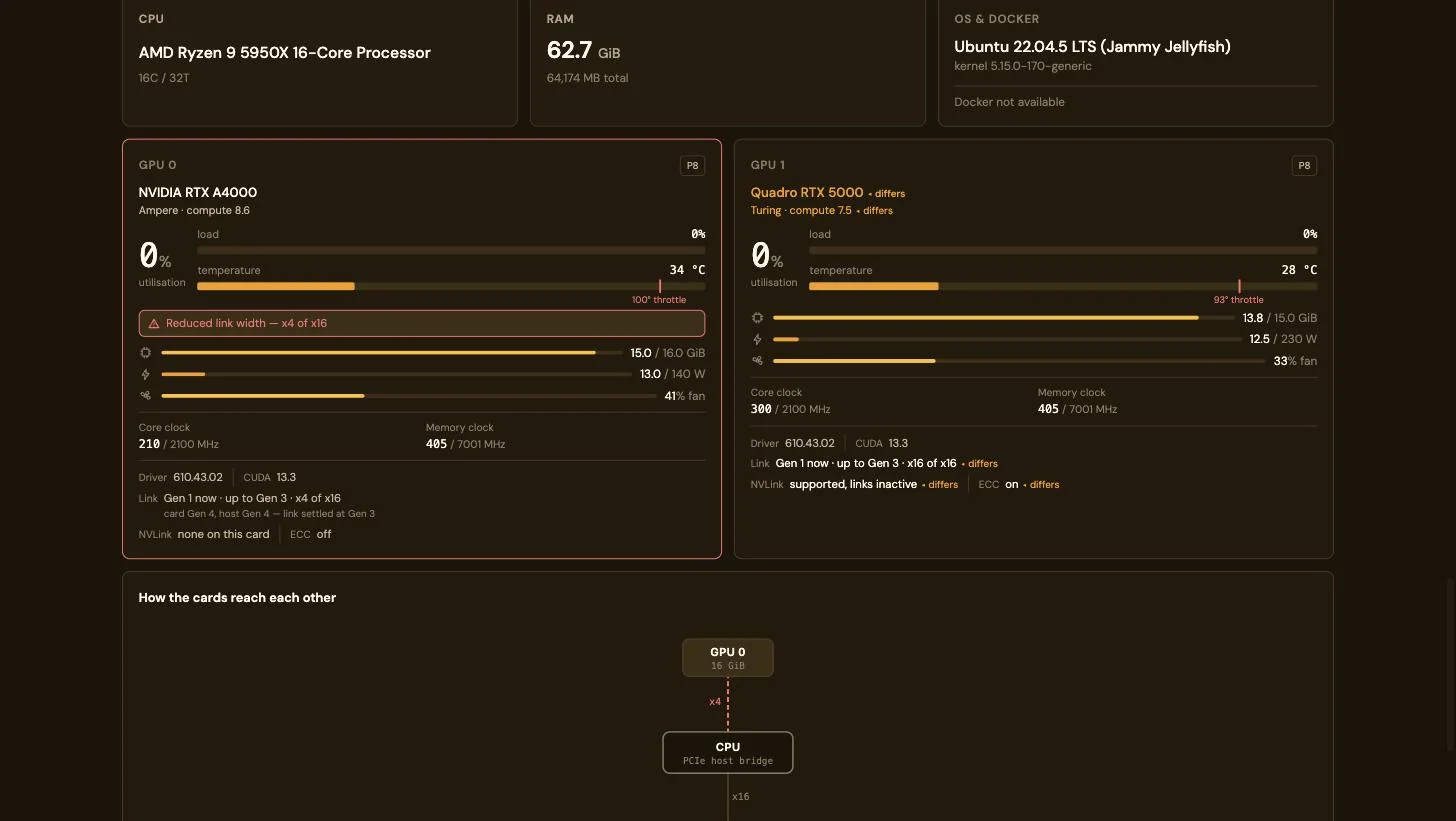
同一个控制台可以读取 16 GB 的 M1、工作站里两块型号不同的显卡,以及一台 8 × B300 NVSwitch 服务器,并且会指出瓶颈,而不是把它平均掉:在 x16 插槽上只以 x4 运行的 PCIe 链路、未激活的 NVLink 链路、各卡之间不同的 ECC 设置。
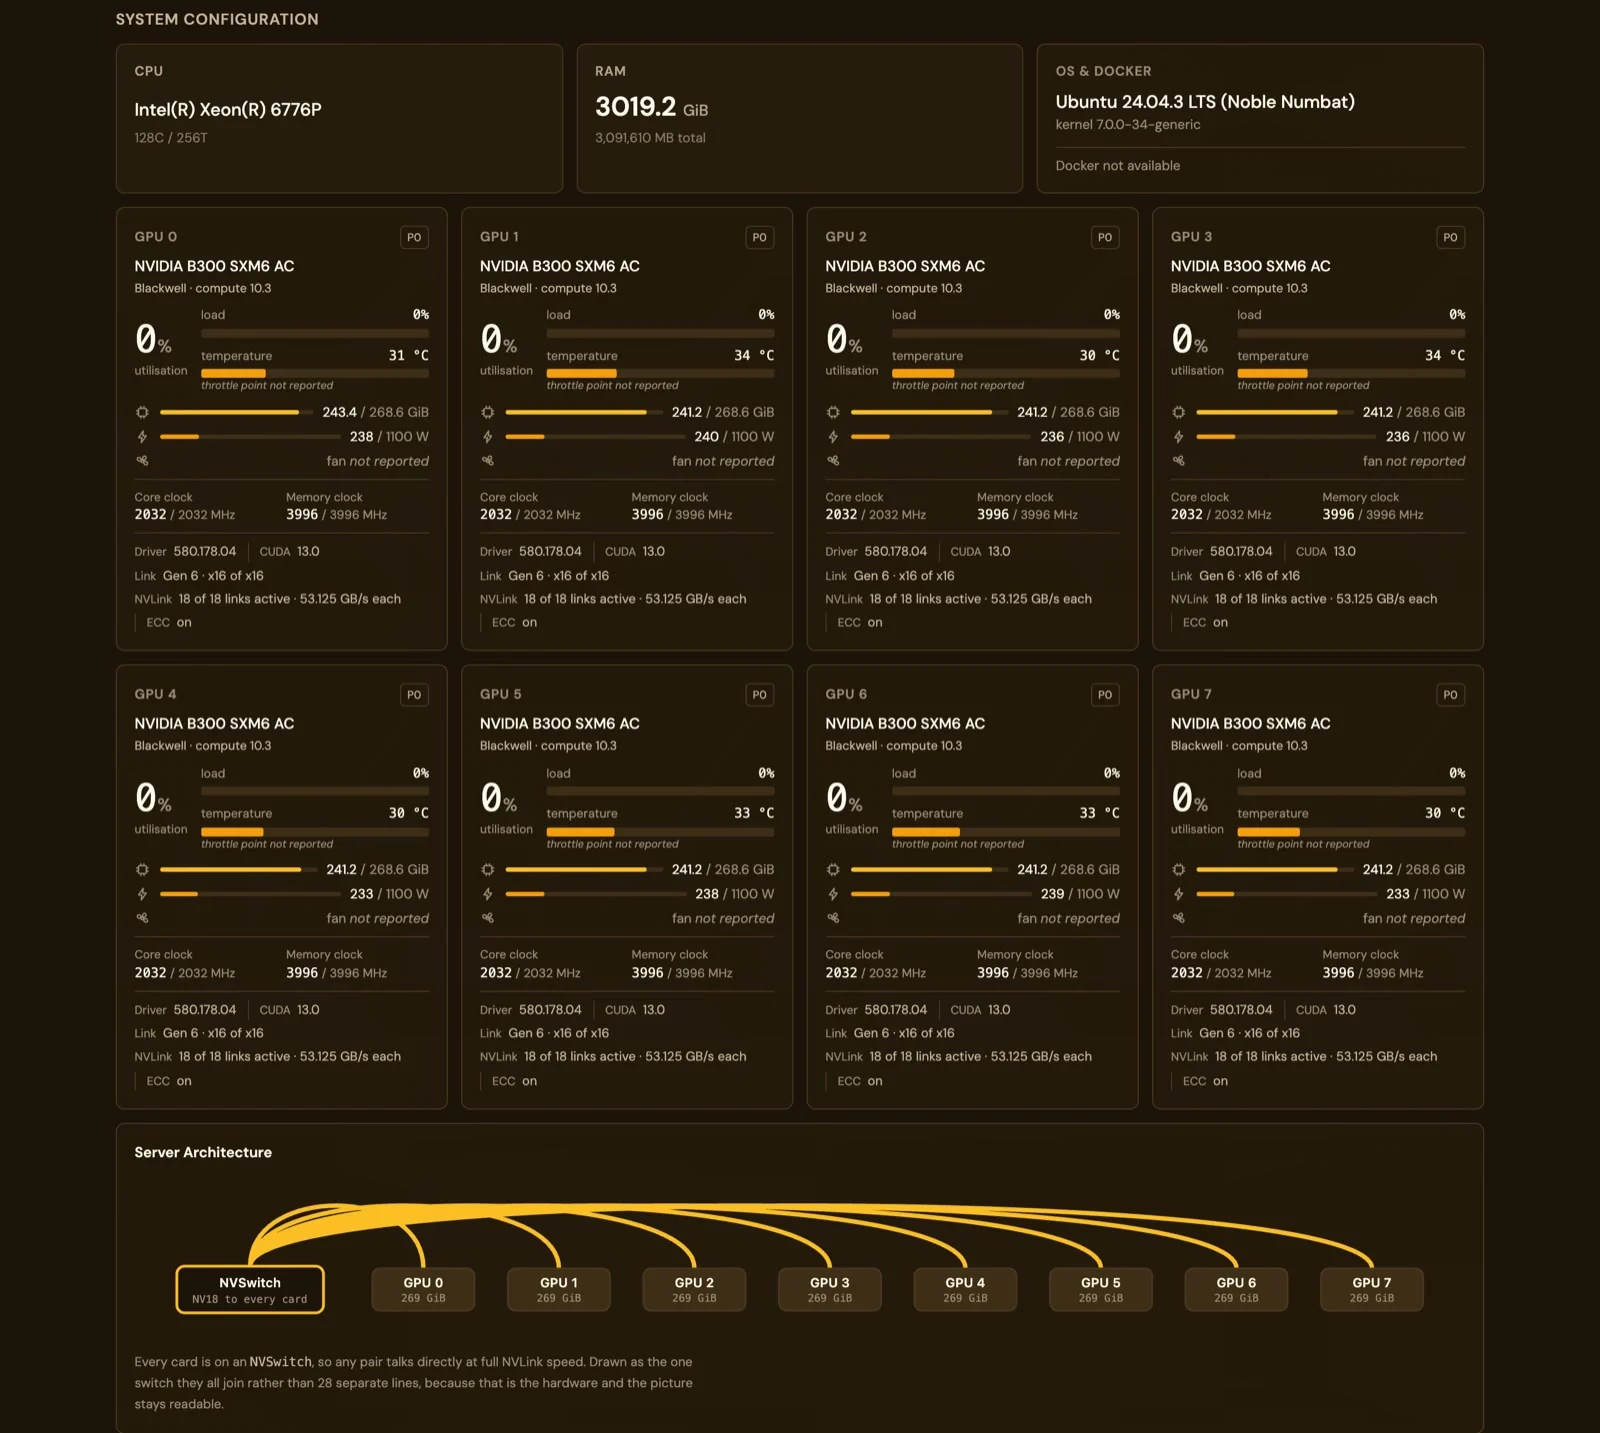
一台 8 × B300 服务器的系统配置:Intel Xeon 6776P,3019 GiB 内存,八个 NVIDIA B300 SXM6 面板,每个显示已用 241/268.6 GiB、Link Gen 6 x16 of x16、NVLink 18 条链路中 18 条激活且每条 53.125 GB/s、ECC 开启,以及一张 NVSwitch 连接所有显卡的服务器架构图
一个 NVSwitch 上的八块 B300 SXM6 显卡:每块卡 18 条 NVLink 链路中 18 条激活,ECC 开启,PCIe Gen 6 x16,以张量并行 8 运行 GLM-5.2 NVFP4 时每块卡已用 241/268.6 GiB。
两块型号不同的 GPU:一块 NVIDIA RTX A4000,带有红色的 Reduced link width x4 of x16 警告,当前 Link Gen 1、最高 Gen 3;旁边是一块 Quadro RTX 5000,其架构、VRAM、功耗上限、链路、NVLink 和 ECC 都被标记为 differs;下方是显卡通过 x4 和 x16 链路连接 CPU 的示意图
两块相隔多年购买的显卡:A4000 的链路在 x16 插槽上只协商到 x4,并以红色标出;Quadro 的架构、功耗上限、NVLink(支持,但链路未激活)和 ECC 都被标记为 differs。示意图标出了哪个插槽在降宽运行。
8 × B300 服务器上的 Stats:VRAM 已用 1932.1/2148.8 GiB,所有显卡合计功耗 1893 W,过去一小时的 GPU 利用率和功耗,以及分为已缓存和需计算两部分的每秒提示词 token 数,缓存命中率 93%
同一个 Stats 页面在最大规模下:VRAM 已用 1,932/2,149 GiB,所有显卡合计 1,893 W,该小时内峰值 4,351 W,93% 的提示词 token 来自缓存。
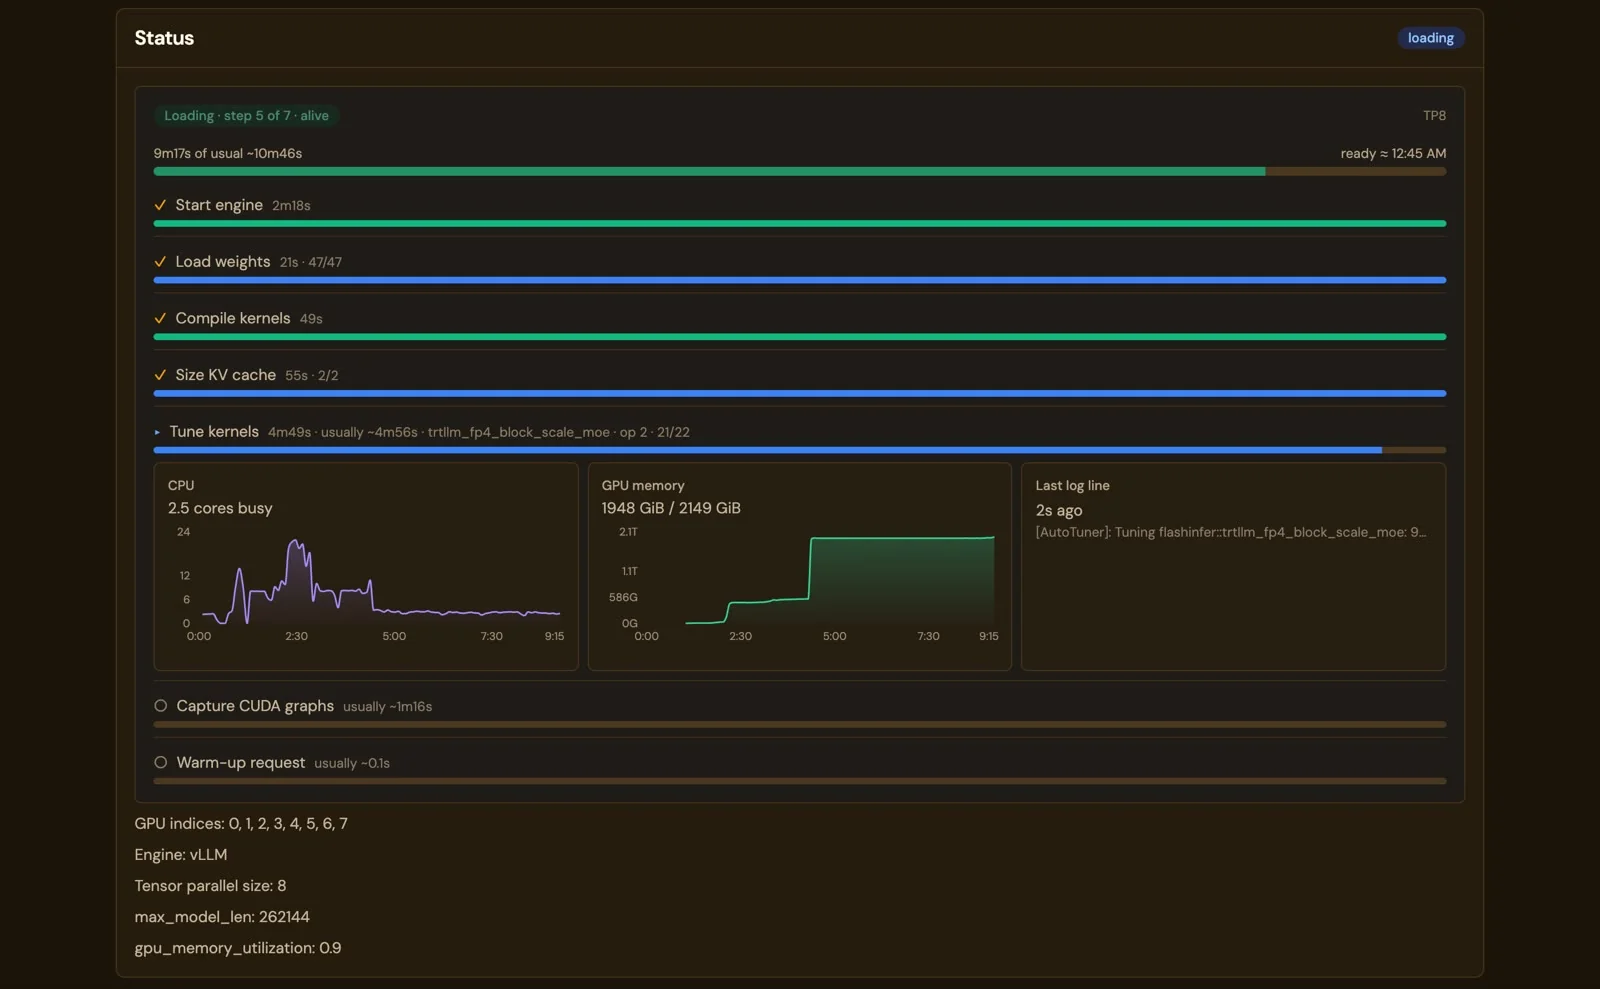
GLM-5.2 NVFP4 在八块 B300 上加载时的模型页面:通常需要 10 min 46 s,已进行 9 min 17 s;Start engine、Load weights 47/47、Compile kernels 和 Size KV cache 已完成,Tune kernels 进行到第 21/22 个操作,另有 CPU 和 GPU 内存图表以及最后一行日志
一次 10 分钟的加载,逐步可见:GLM-5.2 NVFP4 在八块 B300 上,通常需要 10 min 46 s,已进行 9 min 17 s,只要还在推进就不会标红。

每个面板按卡显示:温度与该卡自身降频温度的对比、功耗与功耗上限的对比、频率、风扇、当前协商的 PCIe 代数和宽度、显卡具备时的 ECC 和 NVLink,以及占用显存的进程。互连示意图读取自 nvidia-smi topo -m。在 Mac 上:GPU 使用率和 Metal 报告的内存预算,不含功耗。底层引擎由它自己的 /health 监控,而不是看进程表:外层进程仍在而引擎已失效时,会重新加载引擎并保留证据。

它能显示什么

GPU 监控

每块卡的数据单独呈现。

利用率、温度与该卡自身降频温度的对比、功耗与功耗上限的对比、VRAM、频率、PCIe 链路,以及哪个进程占用显存。不是整台主机的平均值。
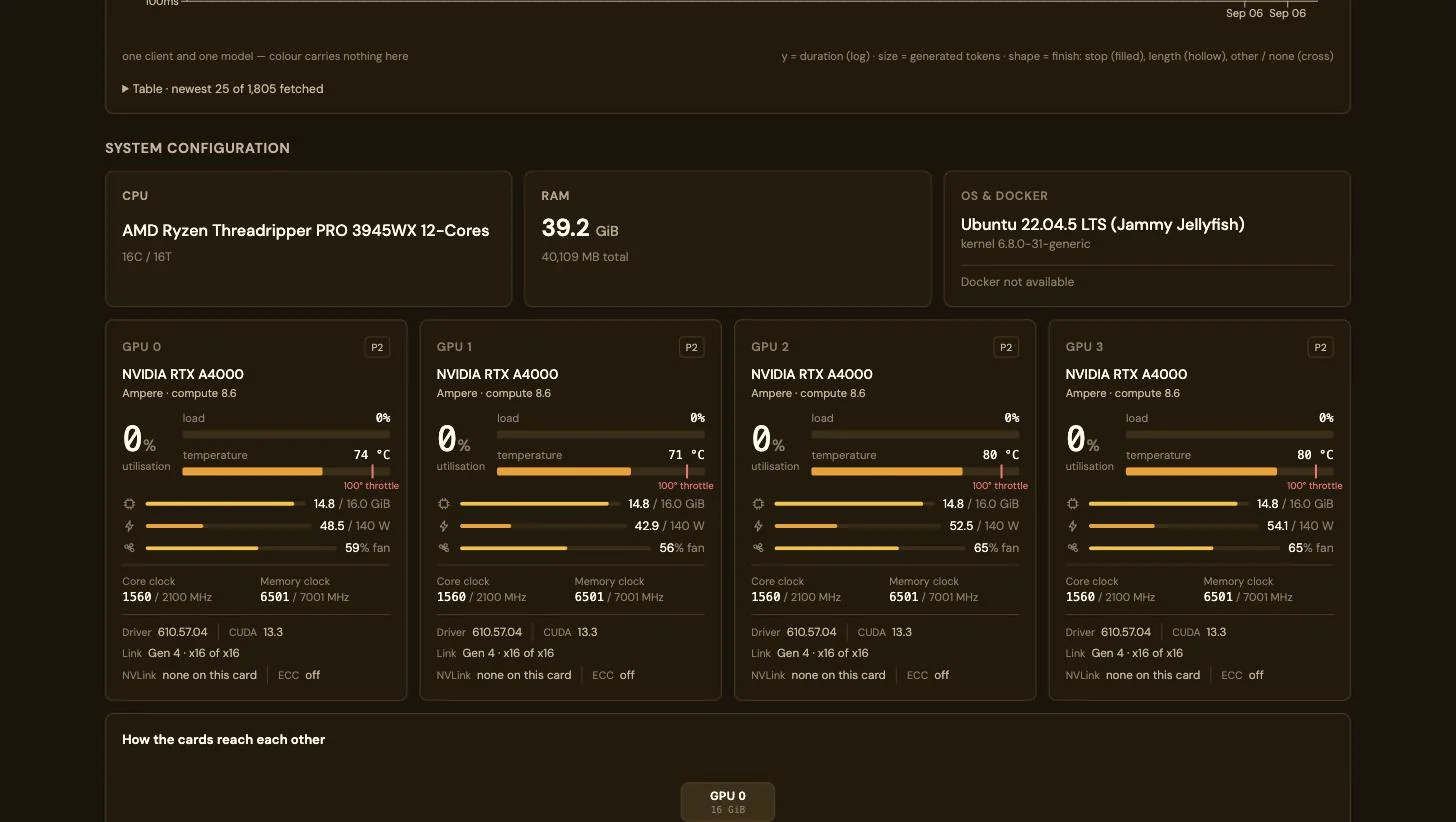
系统配置和四个 NVIDIA RTX A4000 显卡的 GPU 面板,逐卡显示利用率、温度、VRAM、功耗、风扇和频率

进行中的请求

实时查看每个智能体正在做什么。

每个请求及其密钥、会话和阶段:排队、预填充、思考、工具调用、应答。每个提示词有多少来自前缀缓存,按请求测量。
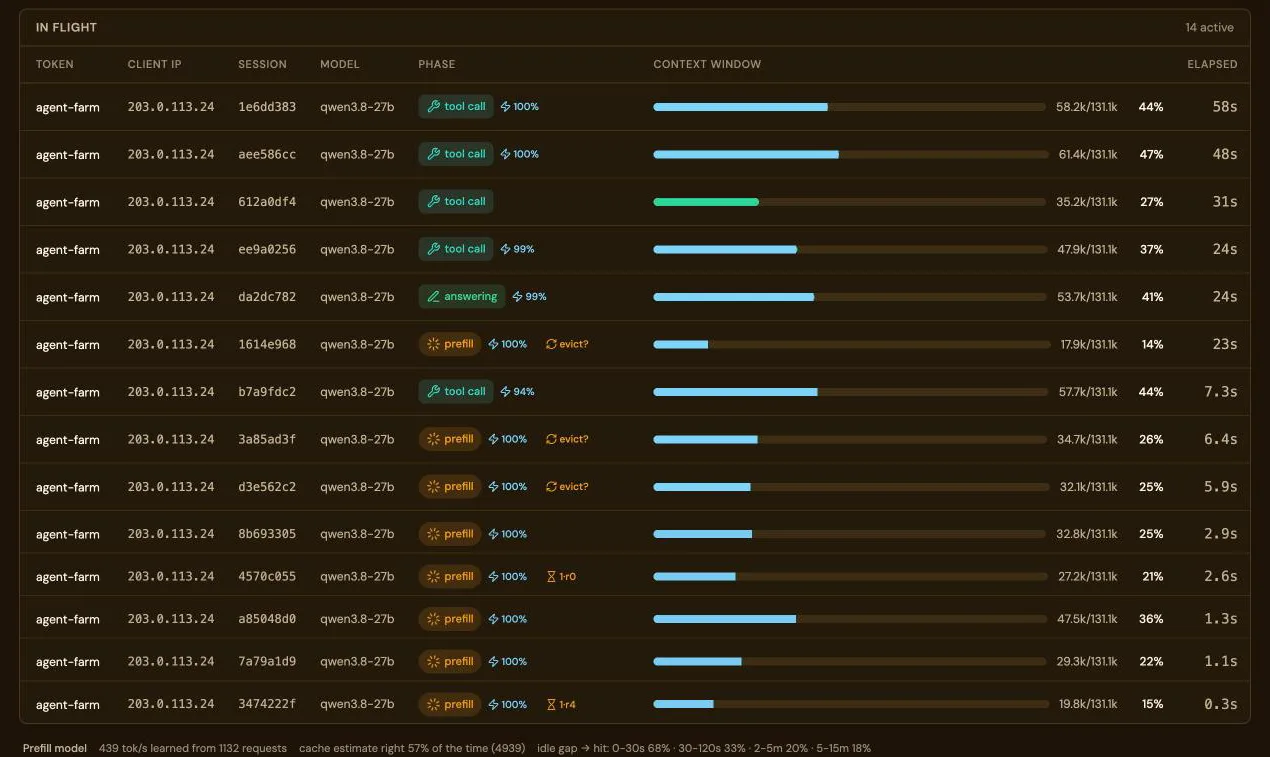
进行中的请求表格:十个活动请求,每个都显示密钥、会话、阶段和 token 数

编程智能体

Claude Code、Codex 和 OpenCode,在一个页面上完成连接。

Connect 会用此 warden 的地址、一个密钥和一个已加载的模型写好每个工具的配置,根据实际加载的内容检查要求,并发送测试请求。

Connect a client 页面,已选择 Claude Code 并完成要求检查

免费开源,公开开发。

LM Warden 以 Apache-2.0 许可证发布在 GitHub 上:安装脚本和 Compose 文件就是全部部署内容,两者你都可以直接查看。无需账户,没有许可证检查,没有遥测。vLLM、llama.cpp 和 MLX 是我们原样运行的上游项目。

mlx-rust-lm 即将推出

基于 Apple 官方 mlx-c 绑定,将 Apple 的 mlx-lm 从 Python 移植到 Rust,由 LM Warden 团队作为独立开源项目开发和维护。LM Warden 将把它用作第三个 Mac 引擎,最终取代占如今 Mac 下载包大部分体积的 Python 版 mlx-lm 引擎。非官方项目,与 Apple 无关。