Chaque tour est envoyé là où le précédent a laissé son cache.
Un agent renvoie tout son historique à chaque tour, si bien qu’une longue conversation se compose surtout d’un préfixe que le moteur a déjà lu. vLLM conserve ce travail dans son cache de préfixes (l’état d’attention des prompts déjà vus) et s’en dispense la fois suivante, quand le même préfixe revient, mais seulement sur le réplica qui a effectué le travail : chaque copie complète du modèle a son propre cache. Le répartiteur intégré à vLLM envoie chaque tour au réplica dont la file d’attente est la plus courte ; celui-ci n’a généralement jamais vu la conversation et relit donc tout l’historique. LM Warden place chaque nouvelle conversation sur le réplica le moins chargé (requêtes en cours, taux de remplissage de son cache et nombre de conversations actives qu’il détient) et l’y maintient, grâce à l’ID de session que Claude Code envoie déjà. Il ne déplace une requête que lorsque ce réplica dépasse son seuil de débordement : par défaut, quand les requêtes en cours dépassent le quart de la limite de séquences simultanées du modèle, soit 8 sur notre machine à quatre cartes.
Les réplicas, et donc ce routage, font partie de l’installation Linux avec GPU NVIDIA ; l’app Mac (bêta) n’offre ni parallélisme de tenseurs ni parallélisme de données.
Mesuré sur la machine à quatre cartes : avec les conversations fixées sur leur réplica, la part des jetons de prompt servis par le cache est passée de 56 à 86 % à 4 sessions simultanées, et le délai médian avant le premier octet est tombé de 2,05 à 0,38 s. Le nombre de jetons de sortie par minute était plus élevé à chaque palier testé, et le délai p95 avant le premier octet (les 5 % les plus lents) plus bas à chaque palier. Le nombre de réplicas réellement actifs a à peine bougé (2,71 contre 2,83 sur quatre à 4 sessions) : le gain vient de la réutilisation du cache, non d’un plus grand nombre de cartes sollicitées.
Les paliers à 24 et 32 sessions sont une surcharge délibérée de quatre petites cartes, où les attentes atteignent des dizaines de secondes, avec ou sans affinité. Le compromis y apparaît : les requêtes les plus lentes attendent toujours moins avec l’affinité, mais la médiane est plus longue. Les chiffres suivent.
- GPU
- 4 × NVIDIA RTX A4000, 16 Gio chacune
- Modèle
- qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
- Répartition
- data_parallel_size 4, tensor_parallel_size 1
- vLLM
- 0.26.0
- LM Warden
- Cette version
- Relevé
- 4 octobre 2026, les deux séries l’une après l’autre
- Charge
- Des sessions synthétiques du type Claude Code générées par notre propre banc de test, et non Claude Code lui-même : un prompt système partagé d’environ 3,5 k jetons, un premier message propre à chaque session (6 k en nominal, environ 7,2 k à 7,5 k mesurés), puis cinq tours supplémentaires d’environ 400 nouveaux jetons chacun, avec au plus 256 jetons générés par tour. Boucle fermée : une session lance son tour suivant dès que le précédent se termine. 3 minutes par palier.
| Sessions | Sessions/h off → on | Output tokens/min off → on | TTFB p50 off → on (s) | TTFB p95 off → on (s) | Replicas busy off → on | Prefix hits off → on (%) | Stayed on replica (%) |
|---|---|---|---|---|---|---|---|
| 4 | 180 → 240 | 5,886 → 6,744 | 2.05 → 0.38 | 3.5 → 2.84 | 2.71 → 2.83 | 56.2 → 86.4 | 100 |
| 8 | 300 → 380 | 8,364 → 10,752 | 2.33 → 0.48 | 6.32 → 5.03 | 3.74 → 3.74 | 44.3 → 86.1 | 100 |
| 16 | 300 → 360 | 9,558 → 12,204 | 3.25 → 0.85 | 26.24 → 24.88 | 3.91 → 3.69 | 33.2 → 48.6 | 100 |
| 24 | 300 → 420 | 9,048 → 11,178 | 5.06 → 13.14 | 58.82 → 38.34 | 3.91 → 4 | 32.8 → 37.9 | 89.1 |
| 32 | 520 → 620 | 14,760 → 16,638 | 12.32 → 27.66 | 82.84 → 38.92 | 4 → 4 | 31.6 → 31.6 | 67.3 |
Mesuré sur notre machine à quatre cartes avec un petit modèle, affinité d’abord désactivée puis activée, sans redémarrer vLLM entre les deux : la seconde série a démarré avec un cache de préfixes déjà chaud, et les deux ont tiré leurs prompts de la même graine. Chaque palier ne dure que 3 minutes, si bien qu’il ne termine que 9 à 31 sessions et qu’une session de plus ou de moins fait varier de 20 le nombre de sessions par heure ; la colonne la plus stable est celle des jetons de sortie par minute. Votre modèle, vos cartes et votre charge de travail seront différents ; le panneau des réplicas, sur la page d’un modèle, affiche les mêmes compteurs pour les vôtres.
Jusqu’à 16 sessions, l’affinité l’emporte à chaque palier sur le débit, les succès de cache de préfixes et les deux colonnes de délai avant le premier octet : les succès passent de 56 à 86 % à 4 sessions, le délai médian avant le premier octet de 2,05 à 0,38 s, et la sortie de 5 886 à 6 744 jetons par minute (de 180 à 240 sessions par heure). À 24 et 32 sessions, les paliers de surcharge, chaque réplica est saturé. La sortie reste plus élevée (11 178 contre 9 048 et 16 638 contre 14 760 jetons par minute) et les requêtes les plus lentes attendent bien moins (p95 38 contre 59 s, et 39 contre 83 s), mais le délai médian avant le premier octet est moins bon avec l’affinité : 13,1 contre 5,1 s à 24 sessions, 27,7 contre 12,3 s à 32. Nous n’en avons pas isolé la cause, et abaisser le seuil de débordement de 8 à 4 n’y a rien changé. L’avantage est maximal tant qu’il reste de la marge ; sur une machine qui tourne à sa limite, mesurez les deux réglages, sachant que l’affinité peut être désactivée modèle par modèle.
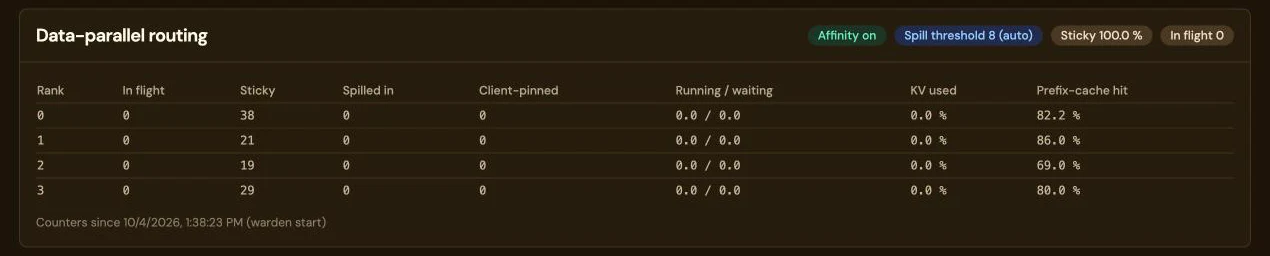 Affinité activée, seuil de débordement 8 (auto)
Taux de succès par réplica, d’après les propres compteurs de vLLM
sticky) ou arrivées par débordement, ce qui s’exécute et ce qui attend, le cache KV utilisé et le taux de succès du cache de préfixes. Relevé le 4 octobre 2026 avec l’affinité activée et le seuil de débordement à 8 (auto) : sticky 100 %, 38, 21, 19 et 29 requêtes sticky sur les réplicas 0 à 3, et un taux de succès du cache de préfixes de 82,2 ; 86,0 ; 69,0 et 80,0 %. Les compteurs partent du redémarrage du warden, et tout le trafic de cette période s’est déroulé avec l’affinité activée : des sessions d’agent synthétiques et de vrais tours de Claude Code. C’est une capture du panneau, pas un résultat de mesure. Faites défiler l’image horizontalement pour voir toutes les colonnes.La machine qui est à l’origine du routage par réplica l’utilise depuis. Elle compte sept RTX 5090 qui servent un modèle 27B, sous forme de sept réplicas d’une carte chacun, à une ferme d’agents Claude Code sans interface. Notre première règle de placement hachait l’ID de session : chaque session restait bien sur son réplica, mais sans tenir compte de la charge. Avec 26 sessions d’agent d’environ 58 k jetons chacune, trois réplicas restaient inactifs pendant que d’autres remplissaient leur cache jusqu’à 93 %, et la part des jetons de prompt servis par le cache est tombée de 81 % après un redémarrage à 28 % en 35 minutes environ. Nous avons alors réduit la ferme à 16 sessions, environ deux par réplica, pour que les ensembles de travail tiennent dans le cache, et placé les nouvelles conversations sur le réplica le moins chargé. Sur l’heure suivante, cette part s’est établie entre 78 et 79 %. C’est une observation, pas un test A/B : une seule charge de travail et deux changements simultanés, donc le gain n’est pas dû au seul placement. La règle empirique qui s’en dégage : le nombre de sessions simultanées multiplié par leur contexte typique doit rester inférieur au cache total de la machine.
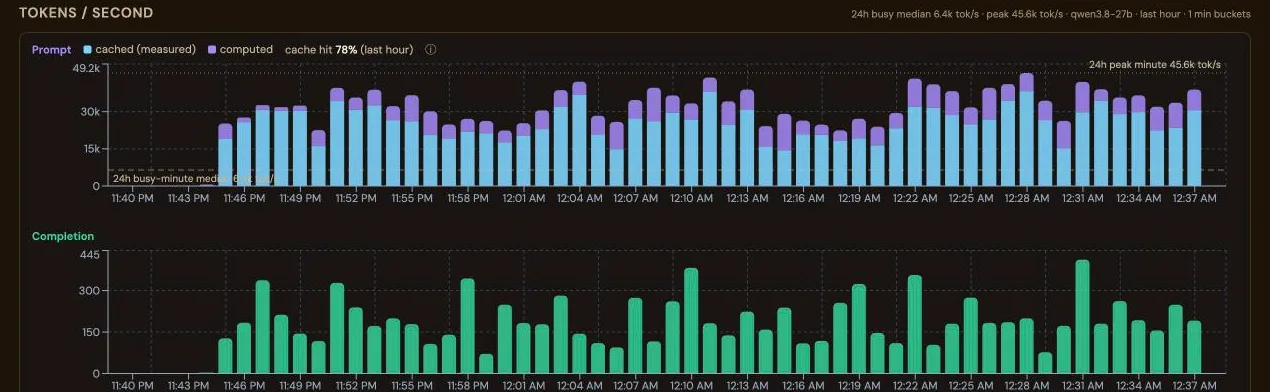 Mesuré par le moteur, par requête