LM Warden

下一轮请求会回到上一轮留下缓存的那个副本。

智能体每一轮都会重新发送它的全部历史,因此长对话的大部分内容都是引擎已经读过的前缀。vLLM 把这部分工作保存在前缀缓存中(即它见过的提示词的注意力状态),下次同样的前缀到来时就可以跳过,但这只在做过这项工作的那个副本上有效:模型的每一份完整拷贝都有自己的缓存。vLLM 自带的负载均衡器把每一轮发给队列最短的副本,而那个副本通常从未见过这段对话,于是要把整个历史重新读一遍。LM Warden 把每个新对话放到负载最低的副本上(综合考虑进行中的请求数、缓存占用率和该副本持有的活跃对话数),并借助 Claude Code 本来就会发送的会话 ID,让对话一直留在那里。只有当该副本超过溢出阈值时,才会把请求移走:默认阈值是进行中的请求超过模型并发序列上限的四分之一,在我们的四卡主机上为 8。

副本以及这种路由属于配备 NVIDIA GPU 的 Linux 安装;Mac 应用(测试版)不支持张量并行或数据并行。

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
图 6一个对话的四轮请求,模型有四个副本。使用 vLLM 的负载均衡器时,每一轮都在接到它的副本上几乎从头预填充(把提示词读入缓存)。使用 LM Warden 时,对话一直留在副本 2 上,只有新的一轮需要预填充。这是机制示意图,不是测量结果。

在四卡主机上实测:把对话固定到副本后,在 4 个并发会话时,从缓存提供的提示词 token 占比从 56% 升至 86%,首字节时间中位数从 2.05 降至 0.38 s。在我们测试的每一级中,每分钟输出 token 数都更高,p95 首字节时间(最慢的 5%)也都更低。实际在工作的副本数几乎没变(4 个会话时为 2.71 对 2.83,总共四个):收益来自缓存复用,而不是更多显卡投入工作。

24 和 32 个会话这两级是对四块小显卡的刻意超载,无论是否开启亲和性,等待时间都会长达数十秒。这时取舍就显现出来了:开启亲和性时长尾延迟仍然更短,但中位数更长。数据如下。

GPU
4 × NVIDIA RTX A4000,每块 16 GiB
模型
qwen3-4b-dp4(Qwen/Qwen3-4B-Instruct-2507),bf16
切分方式
data_parallel_size 4,tensor_parallel_size 1
vLLM
0.26.0
LM Warden
本版本
采集时间
2026 年 10 月 4 日,两组连续运行
负载
来自我们自己压测工具的模拟 Claude Code 风格会话,而不是 Claude Code 本身:约 3.5k token 的共享系统提示词;每个会话独有的第一条消息(标称 6k,实测约 7.2k 到 7.5k);之后再进行五轮,每轮约 400 个新 token,每轮最多输出 256 个 token。采用闭环方式:一个会话的上一轮结束后,立即开始下一轮。每一级 3 分钟。
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
图 7并发会话数为 4 到 32 时的首字节时间,包括中位数和 p95,采用对数刻度,以便亚秒级和长达一分钟的数值能放在一起对比。开启亲和性后,在 16 个会话以内中位数要低得多(4 个会话时为 0.38 对 2.05 s),在 24 和 32 个会话时更高;p95 在每一级都更低,不过在 16 个会话时差距(24.9 对 26.2 s)在每组只跑一次的噪声范围之内。在客户端测量,经由互联网,计到第一个流式 token。
SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

在我们的四卡主机上用一个小模型测量,先关闭亲和性,再开启,中间没有重启 vLLM:第二组开始时前缀缓存已经预热,两组的提示词都来自同一个随机种子。每一级持续 3 分钟,因此只能完成 9 到 31 个会话,多一个或少一个会话就会让每小时会话数变化 20;每分钟输出 token 数是更稳定的一列。你的模型、显卡和工作负载会有所不同;模型页面上的副本卡片会为你的环境显示同样的计数器。

在 16 个会话以内,开启亲和性在每一级的吞吐量、前缀缓存命中以及两列首字节时间上都领先:4 个会话时,命中率从 56% 升至 86%,首字节时间中位数从 2.05 降至 0.38 s,输出从每分钟 5,886 升至 6,744 个 token(每小时会话数从 180 升至 240)。在 24 和 32 个会话这两个超载级别,每个副本都已饱和。输出仍然更高(每分钟 11,178 对 9,048 个 token,以及 16,638 对 14,760 个 token),长尾延迟也短得多(p95 为 38 对 59 s,以及 39 对 83 s),但开启亲和性时首字节时间中位数更差:24 个会话时为 13.1 对 5.1 s,32 个会话时为 27.7 对 12.3 s。我们还没有查明原因,把溢出阈值从 8 降到 4 也没有改变这一点。有余量时优势最大;长期满负荷运行的主机应该把两种设置都测一遍,亲和性可以按模型关闭。

Replicas busy by concurrent sessionsAverage replicas with running requests, of four, affinity on against vLLM’s balancer: 4 sessions 2.71 off, 2.83 on; 8 sessions 3.74 off, 3.74 on; 16 sessions 3.91 off, 3.69 on; 24 sessions 3.91 off, 4 on; 32 sessions 4 off, 4 on.affinity onvLLM balancerReplicas busy01234replicas busy, of 448162432concurrent sessionsvLLM balancer, 4 sessions: 2.71vLLM balancer, 8 sessions: 3.74vLLM balancer, 16 sessions: 3.91vLLM balancer, 24 sessions: 3.91vLLM balancer, 32 sessions: 4vLLM balanceraffinity on, 4 sessions: 2.83affinity on, 8 sessions: 3.74affinity on, 16 sessions: 3.69affinity on, 24 sessions: 4affinity on, 32 sessions: 4affinity on
图 8四个副本中忙碌的副本数:每次轮询时有请求在运行的副本数,在一级内取平均。不是 GPU 利用率。亲和性几乎不改变它;收益在图 9 中。
Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
图 9每一级的前缀缓存命中率:从缓存提供的提示词 token 数除以请求的提示词 token 数,四个副本合计,取自该级期间 vLLM 自身计数器的变化。只要还有余量,收益就会保持;到 32 个会话时对话开始溢出,收益随之消失。
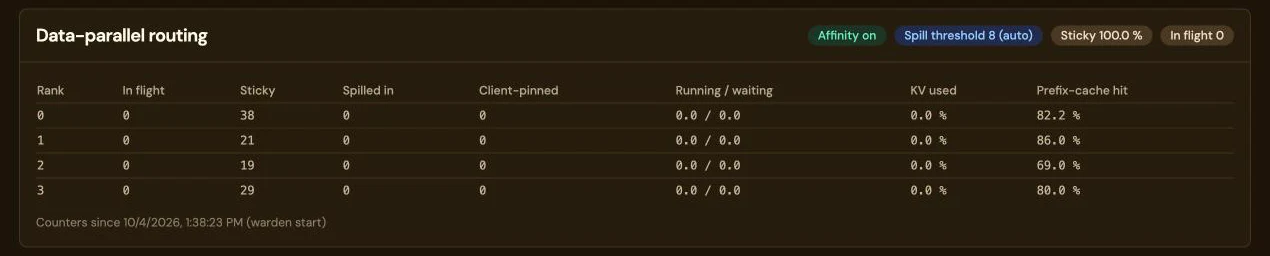
模型页面上的数据并行路由卡片,带有标签 Affinity on、Spill threshold 8 (auto)、Sticky 100.0% 和 In flight 0。表格列出副本 0 到 3 的进行中、粘滞(38、21、19 和 29)、溢入、客户端固定、运行中和等待中、已用 KV 以及前缀缓存命中率(82.2、86.0、69.0 和 80.0%),还有一行说明计数器从 warden 启动时开始累计。 亲和性开启,溢出阈值 8(自动) 每个副本的命中率,来自 vLLM 自身的计数器
图 10模型页面上的同一组计数器:每个副本一行,显示它持有的请求、有多少对话留下(sticky)或通过溢出到达、正在运行和等待的请求、使用中的 KV 缓存以及前缀缓存命中率。记录于 2026 年 10 月 4 日,亲和性开启,溢出阈值为 8(自动):sticky 100%,副本 0 到 3 上分别有 38、21、19 和 29 个 sticky 请求,前缀缓存命中率分别为 82.2%、86.0%、69.0% 和 80.0%。计数器从 warden 重启时开始累计,该时段内的所有流量都开启了亲和性:模拟的智能体会话加上真实的 Claude Code 轮次。图中是控制台里的计数卡片,并非基准测试结果。左右滚动图片可查看所有列。

最初促使我们做副本路由的那台主机,此后一直在用它。这台主机有七块 RTX 5090,以七个单卡副本运行一个 27B 模型,为一组无头(headless)Claude Code 智能体提供服务。我们最初的放置规则是对会话 ID 做哈希,这样能保持粘滞,却看不到负载。在 26 个各约 58k token 的智能体会话下,三个副本闲置,其他副本的缓存却被用到 93%,从缓存提供的提示词 token 占比从重启后的 81% 在约 35 分钟内跌到 28%。随后我们把智能体减少到 16 个会话,约每个副本两个,使工作集能放进缓存,并把新对话放到负载最低的副本上。接下来一小时里该占比为 78% 到 79%。这是观察,不是 A/B 测试:同一个工作负载,两项改动同时进行,所以收益并不全来自放置策略。由此得出的经验法则是:让并发会话数乘以其典型上下文长度,保持在主机的总缓存容量以下。
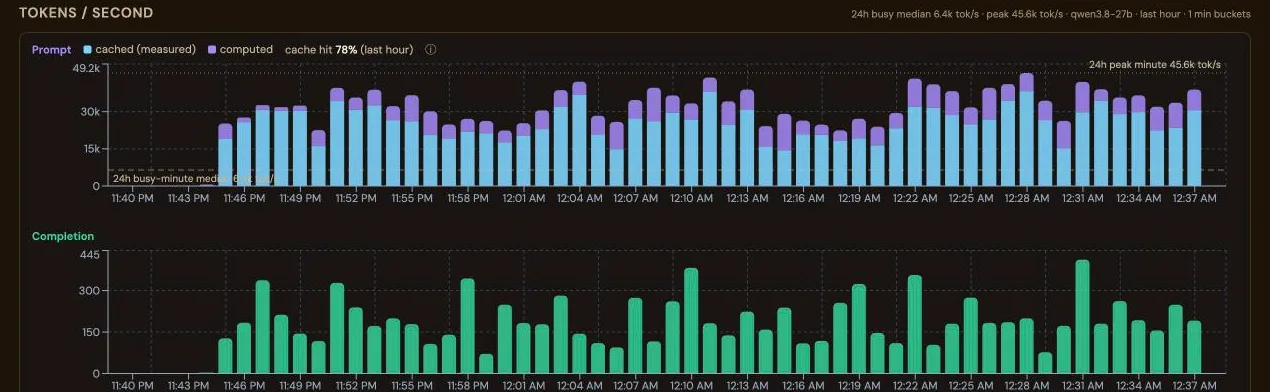
Stats 页面上一小时内的 Tokens per second 图表。提示词柱分为缓存命中(实测,蓝色)和计算(紫色)两部分,介于每秒约 15k 到 45k 个 token 之间,每根柱子大部分是蓝色,汇总显示过去一小时缓存命中率为 78%。每秒补全 token 数介于约 70 到 420 之间,以绿色画在下方。 由引擎按请求测量
图 11七卡主机上每秒的提示词 token 数,分为每个副本从其前缀缓存读取的部分和必须计算的部分,并显示过去一小时的占比:78%。缓存部分是引擎对每个已完成请求的自身计数,不是估计;引擎没有测量的请求计为计算部分。记录于 2026 年 10 月 5 日。左右滚动图片可查看整个小时。