Die nächste Runde landet dort, wo die letzte ihren Cache hinterlassen hat.
Ein Agent sendet in jeder Runde seinen gesamten Verlauf erneut, daher besteht eine lange Unterhaltung größtenteils aus einem Präfix, das die Engine schon gelesen hat. vLLM bewahrt diese Arbeit in seinem Präfix-Cache auf (dem Attention-Zustand bereits gesehener Prompts) und überspringt sie, wenn dasselbe Präfix das nächste Mal ankommt, aber nur auf dem Replikat, das die Arbeit geleistet hat: Jede vollständige Kopie des Modells hat ihren eigenen Cache. Der eigene Balancer von vLLM schickt jede Runde an das Replikat mit der kürzesten Warteschlange, das die Unterhaltung meist nie gesehen hat und daher den gesamten Verlauf erneut liest. LM Warden platziert jede neue Unterhaltung auf dem am wenigsten ausgelasteten Replikat (laufende Anfragen, Füllstand seines Caches und Zahl der aktiven Unterhaltungen darauf) und belässt sie dort, anhand der Sitzungs-ID, die Claude Code ohnehin sendet. Eine Anfrage wird nur verschoben, wenn dieses Replikat seinen Überlaufschwellenwert überschreitet: standardmäßig laufende Anfragen über einem Viertel des Limits gleichzeitiger Sequenzen des Modells, auf unserem Rechner mit vier Karten sind das 8.
Replikate, und damit dieses Routing, gehören zur Linux-Installation mit NVIDIA-GPUs; die Mac-App (Beta) hat weder Tensor- noch Datenparallelität.
Abb. 6Vier Runden einer Unterhaltung auf einem Modell mit vier Replikaten. Mit dem Balancer von vLLM wird jede Runde fast von Grund auf im Prefill verarbeitet (ihr Prompt in den Cache eingelesen), auf welchem Replikat sie auch landet. Mit LM Warden bleibt die Unterhaltung auf Replikat 2, und nur die neue Runde geht durch den Prefill. Eine Zeichnung des Mechanismus, keine Messung.
Gemessen auf dem Rechner mit vier Karten: Mit fest zugeordneten Unterhaltungen stieg der Anteil der aus dem Cache bedienten Prompt-Token bei 4 parallelen Sitzungen von 56 auf 86 %, und die mediane Zeit bis zum ersten Byte sank von 2,05 auf 0,38 s. Die Ausgabe-Token pro Minute waren bei jeder gemessenen Stufe höher, und das p95 der Zeit bis zum ersten Byte (die langsamsten 5 %) war bei jeder Stufe niedriger. Die Zahl der arbeitenden Replikate änderte sich kaum (2,71 gegenüber 2,83 von vier bei 4 Sitzungen): Der Vorteil kommt aus der Wiederverwendung des Caches, nicht aus zusätzlich arbeitenden Karten.
Die Stufen mit 24 und 32 Sitzungen sind eine bewusste Überlastung von vier kleinen Karten, bei der die Wartezeiten mit oder ohne Affinität Dutzende Sekunden erreichen. Dort zeigt sich der Zielkonflikt: Die langsamsten Anfragen warten mit Affinität immer noch kürzer, aber der Median ist länger. Die Zahlen dazu folgen.
GPUs
4 × NVIDIA RTX A4000, je 16 GiB
Modell
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Aufteilung
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
Dieses Release
Aufgezeichnet
4. Oktober 2026, beide Varianten direkt hintereinander
Last
Synthetische Sitzungen im Stil von Claude Code aus unserem eigenen Testaufbau, nicht Claude Code selbst: ein gemeinsamer System-Prompt von etwa 3,5 Tsd. Token, eine für jede Sitzung eigene erste Nachricht (nominell 6 Tsd., gemessen etwa 7,2 bis 7,5 Tsd.), dann fünf weitere Runden mit je etwa 400 neuen Token, höchstens 256 Token Ausgabe pro Runde. Geschlossene Schleife: Eine Sitzung beginnt ihre nächste Runde, sobald die letzte endet. 3 Minuten pro Stufe.
Abb. 7Zeit bis zum ersten Byte bei 4 bis 32 parallelen Sitzungen, Median und p95, auf logarithmischer Skala, damit die Stufen unter einer Sekunde neben den minutenlangen lesbar bleiben. Mit Affinität ist der Median bis 16 Sitzungen weit niedriger (0,38 gegenüber 2,05 s bei 4) und bei 24 und 32 höher; das p95 ist bei jeder Stufe niedriger, wobei der Abstand bei 16 (24,9 gegenüber 26,2 s) im Rauschen eines einzigen Durchlaufs pro Variante liegt. Gemessen beim Client, über das Internet, bis zum ersten gestreamten Token.
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
Gemessen auf unserem Rechner mit vier Karten und einem kleinen Modell, Affinität zuerst aus, dann an, ohne vLLM dazwischen neu zu starten: Die zweite Variante begann mit einem warmen Präfix-Cache, und beide Varianten zogen ihre Prompts aus demselben Seed. Jede Stufe dauert 3 Minuten, daher werden nur 9 bis 31 Sitzungen abgeschlossen, und eine Sitzung mehr oder weniger verschiebt die Sitzungen pro Stunde um 20; die Ausgabe-Token pro Minute sind die stabilere Spalte. Ihr Modell, Ihre Karten und Ihre Last werden abweichen; das Replikat-Panel auf der Seite eines Modells zeigt dieselben Zähler für Ihre Konfiguration.
Bis 16 Sitzungen liegt die Affinität bei jeder Stufe vorn, bei Durchsatz, Treffern im Präfix-Cache und beiden Spalten der Zeit bis zum ersten Byte: Die Treffer steigen bei 4 Sitzungen von 56 auf 86 %, die mediane Zeit bis zum ersten Byte sinkt von 2,05 auf 0,38 s, und die Ausgabe steigt von 5.886 auf 6.744 Token pro Minute (Sitzungen pro Stunde von 180 auf 240). Bei 24 und 32 Sitzungen, den Überlaststufen, ist jedes Replikat ausgelastet. Die Ausgabe ist dennoch höher (11.178 gegenüber 9.048 und 16.638 gegenüber 14.760 Token pro Minute), und die langsamsten Anfragen warten deutlich kürzer (p95 38 gegenüber 59 s und 39 gegenüber 83 s), aber die mediane Zeit bis zum ersten Byte ist mit Affinität schlechter: 13,1 gegenüber 5,1 s bei 24 Sitzungen, 27,7 gegenüber 12,3 s bei 32. Die Ursache haben wir nicht isoliert, und eine Senkung des Überlaufschwellenwerts von 8 auf 4 änderte nichts daran. Der Vorteil ist am größten, solange Spielraum besteht; läuft ein Rechner an seiner Grenze, sollten Sie beide Einstellungen messen – die Affinität lässt sich pro Modell abschalten.
Abb. 8Beschäftigte Replikate, von vier: Replikate mit laufenden Anfragen bei jeder Abfrage, gemittelt über eine Stufe. Nicht die GPU-Auslastung. Die Affinität ändert daran kaum etwas; der Vorteil zeigt sich in Abb. 9.
Abb. 9Trefferquote des Präfix-Caches in jeder Stufe: aus dem Cache bediente Prompt-Token geteilt durch angefragte Prompt-Token, alle vier Replikate zusammengefasst, berechnet aus der Änderung der eigenen Zähler von vLLM während der Stufe. Der Vorteil bleibt erhalten, solange Spielraum besteht, und ist bei 32 Sitzungen verschwunden, wo Unterhaltungen überlaufen.
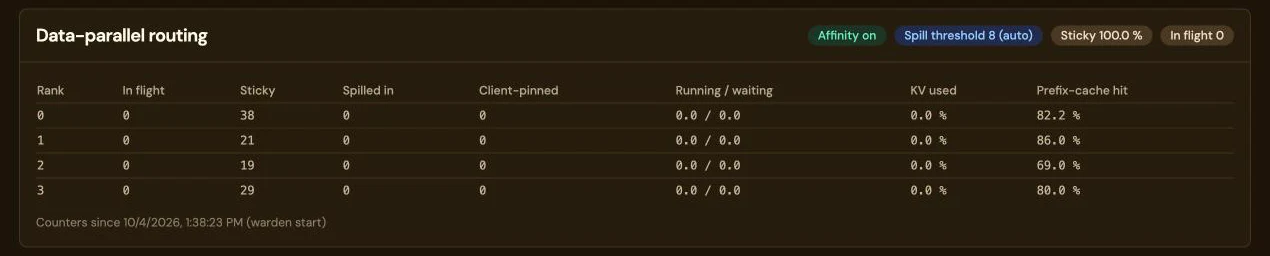
Affinität an, Überlaufschwellenwert 8 (auto)Trefferquote pro Replikat, aus den eigenen Zählern von vLLM
Abb. 10Dieselben Zähler auf der Seite eines Modells: eine Zeile pro Replikat mit den Anfragen, die es gerade bearbeitet, wie viele Unterhaltungen geblieben (sticky) oder durch Überlauf hinzugekommen sind, was läuft und wartet, belegter KV-Cache und die Trefferquote des Präfix-Caches. Aufgenommen am 4. Oktober 2026 mit Affinität an und dem Überlaufschwellenwert bei 8 (auto): sticky 100 %, 38, 21, 19 und 29 Sticky-Anfragen auf den Replikaten 0 bis 3 und eine Trefferquote des Präfix-Caches von 82,2; 86,0; 69,0 und 80,0 %. Die Zähler laufen seit dem Neustart des Wardens, und der gesamte Verkehr in diesem Zeitraum lief mit Affinität: synthetische Agent-Sitzungen plus echte Runden von Claude Code. Das ist ein Screenshot des Panels, kein Messergebnis. Scrollen Sie das Bild seitlich, um alle Spalten zu sehen.
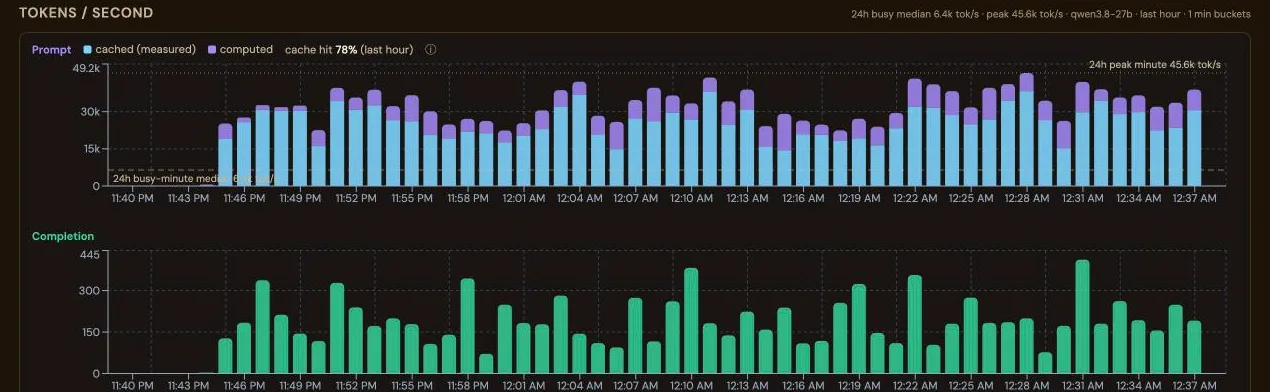
Der Rechner, der das Replikat-Routing ursprünglich angestoßen hat, läuft seitdem damit. Er hat sieben RTX 5090, die ein 27B-Modell als sieben Replikate mit je einer Karte für eine Farm von Agenten bereitstellen, die Claude Code ohne Benutzeroberfläche ausführen. Unsere erste Platzierungsregel hashte die Sitzungs-ID: Sitzungen blieben so zwar auf ihrem Replikat, die Last wurde aber nicht berücksichtigt. Mit 26 Agent-Sitzungen von je etwa 58 Tsd. Token lagen drei Replikate brach, während andere ihren Cache bis auf 93 % füllten, und der Anteil der aus dem Cache bedienten Prompt-Token fiel von 81 % nach einem Neustart auf 28 % innerhalb von etwa 35 Minuten. Daraufhin haben wir die Farm auf 16 Sitzungen reduziert, etwa zwei pro Replikat, damit die Arbeitsmengen in den Cache passen, und neue Unterhaltungen auf das am wenigsten ausgelastete Replikat gelegt. In der folgenden Stunde lag der Cache-Anteil bei 78 bis 79 %. Das ist eine Beobachtung, kein A/B-Test: eine Last und zwei gleichzeitige Änderungen, der Vorteil geht also nicht allein auf die Platzierung zurück. Die Faustregel, die sich daraus ergibt: Gleichzeitige Sitzungen mal ihr typischer Kontext sollten unter dem gesamten Cache des Rechners bleiben.
Von der Engine gemessen, pro Anfrage
Abb. 11Prompt-Token pro Sekunde auf dem Rechner mit sieben GPUs, aufgeteilt in das, was jedes Replikat aus seinem Präfix-Cache gelesen hat, und das, was es berechnen musste, mit dem Anteil für die letzte Stunde: 78 %. Der zwischengespeicherte Teil ist die eigene Zählung der Engine für jede abgeschlossene Anfrage, keine Schätzung; eine Anfrage, die sie nicht gemessen hat, zählt als berechnet. Aufgezeichnet am 5. Oktober 2026. Scrollen Sie das Bild seitlich, um die ganze Stunde zu sehen.
 Affinität an, Überlaufschwellenwert 8 (auto)
Trefferquote pro Replikat, aus den eigenen Zählern von vLLM
 Von der Engine gemessen, pro Anfrage