Наступний раунд потрапляє туди, де попередній залишив свій кеш.
Агент у кожному раунді заново надсилає всю історію, тому довга розмова — це здебільшого префікс, який рушій уже прочитав. vLLM зберігає цю роботу в кеші префіксів (стан уваги для вже побачених промптів) і пропускає її, коли той самий префікс надходить наступного разу, але тільки на репліці, яка цю роботу виконала: кожна повна копія моделі має власний кеш. Власний балансувальник vLLM надсилає кожен раунд на репліку з найкоротшою чергою, яка зазвичай цієї розмови ще не бачила, тож вона знову читає всю історію. LM Warden розміщує кожну нову розмову на найменш завантаженій репліці (запити в роботі, заповненість кешу й кількість активних розмов на ній) і тримає її там, використовуючи ідентифікатор сеансу, який Claude Code уже надсилає. Запит переноситься, лише коли репліка перевищує поріг переповнення: за замовчуванням — коли запитів у роботі більше за чверть ліміту одночасних послідовностей моделі, 8 на нашому сервері з чотирма картами.
Репліки, а отже й ця маршрутизація, є частиною інсталяції для Linux з GPU NVIDIA; застосунок для Mac (бета-версія) не має ні тензорного паралелізму, ні паралелізму за даними.
Рис. 6Чотири раунди однієї розмови на моделі з чотирма репліками. З балансувальником vLLM кожен раунд проходить prefill (промпт зчитується в кеш) майже з нуля на тій репліці, якій він дістався. З LM Warden розмова лишається на репліці 2, і prefill проходить лише новий раунд. Схема механізму, а не вимірювання.
Виміряно на сервері з чотирма картами: коли розмови закріплено, частка токенів промпту, обслужених із кешу, зросла з 56 до 86 % на 4 одночасних сеансах, а медіанний час до першого байта знизився з 2,05 до 0,38 с. Кількість вихідних токенів за хвилину була вищою на кожному кроці, який ми запускали, а p95 часу до першого байта (найповільніші 5 %) — нижчим на кожному кроці. Кількість реплік, що працюють, майже не змінилася (2,71 проти 2,83 з чотирьох на 4 сеансах): виграш дає повторне використання кешу, а не більша кількість задіяних карт.
Кроки з 24 і 32 сеансами — це навмисне перевантаження чотирьох невеликих карт, де очікування сягають десятків секунд із прив’язкою чи без неї. Саме тут і видно компроміс: хвіст із прив’язкою все одно коротший, але медіана довша. Цифри — нижче.
GPU
4 × NVIDIA RTX A4000, по 16 ГіБ
Модель
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Розкладка
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
Цей випуск
Знято
4 жовтня 2026 р., обидва варіанти поспіль
Навантаження
Синтетичні сеанси в стилі Claude Code з нашого власного тестового стенда, а не сам Claude Code: спільний системний промпт близько 3,5 тис. токенів, перше повідомлення, унікальне для сеансу (номінально 6 тис., виміряно близько 7,2–7,5 тис.), потім ще п’ять раундів приблизно по 400 нових токенів, не більше 256 вихідних токенів за раунд. Замкнений цикл: сеанс починає наступний раунд, коли закінчується попередній. 3 хвилини на крок.
Рис. 7Час до першого байта на 4–32 одночасних сеансах, медіана й p95, у логарифмічній шкалі, щоб значення менше за секунду читалися поряд із хвилинними. З прив’язкою медіана значно нижча до 16 сеансів (0,38 проти 2,05 с на 4) і вища на 24 і 32; p95 нижчий на кожному кроці, хоча на 16 різниця (24,9 проти 26,2 с) у межах шуму одного запуску на варіант. Виміряно на клієнті, через інтернет, до першого потокового токена.
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
Виміряно на нашому сервері з чотирма картами на невеликій моделі, спочатку з вимкненою прив’язкою, потім з увімкненою, без перезапуску vLLM між ними: другий варіант почався з уже прогрітим кешем префіксів, а обидва варіанти брали промпти з одного й того самого seed. Кожен крок триває 3 хвилини, тож завершує лише від 9 до 31 сеансу, і один сеанс більше чи менше змінює кількість сеансів за годину на 20; стабільніший стовпець — вихідні токени за хвилину. Ваша модель, карти й навантаження будуть іншими; картка реплік на сторінці моделі показує ті самі лічильники для вашої.
До 16 сеансів прив’язка попереду на кожному кроці за пропускною здатністю, влучаннями в кеш префіксів і обома стовпцями часу до першого байта: влучання зростають з 56 до 86 % на 4 сеансах, медіанний час до першого байта знижується з 2,05 до 0,38 с, а кількість вихідних токенів — з 5 886 до 6 744 за хвилину (сеансів за годину — зі 180 до 240). На 24 і 32 сеансах, кроках перевантаження, кожна репліка насичена. Вихідних токенів за хвилину все ще більше (11 178 проти 9 048 і 16 638 проти 14 760), а повільний хвіст значно коротший (p95 38 проти 59 с і 39 проти 83 с), але медіанний час до першого байта з прив’язкою гірший: 13,1 проти 5,1 с на 24 сеансах, 27,7 проти 12,3 с на 32. Ми не з’ясували причину, а зниження порогу переповнення з 8 до 4 нічого не змінило. Перевага найбільша, поки є запас; серверу, що працює на межі, варто виміряти обидва налаштування, а прив’язку можна вимкнути для окремої моделі.
Рис. 8Зайняті репліки з чотирьох: репліки з запитами в роботі на кожному опитуванні, усереднено за крок. Це не використання GPU. Прив’язка на це майже не впливає; виграш — на рис. 9.
Рис. 9Частка влучань у кеш префіксів на кожному кроці: токени промпту, обслужені з кешу, поділені на запитані токени промпту, сумарно для всіх чотирьох реплік, за зміною власних лічильників vLLM за крок. Виграш зберігається, поки є запас, і зникає на 32 сеансах, коли розмови через переповнення переходять на інші репліки.
Прив’язку ввімкнено, поріг переповнення 8 (авто)Частка влучань для кожної репліки, із власних лічильників vLLM
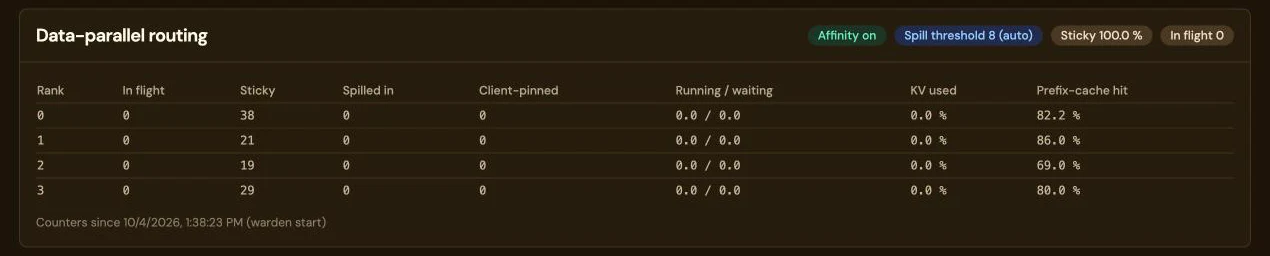
Рис. 10Ті самі лічильники на сторінці моделі: по рядку на репліку із запитами на ній, скільки розмов лишилося (sticky) чи прийшло через переповнення, що виконується й чекає, зайнятий KV-кеш і частка влучань у кеш префіксів. Записано 4 жовтня 2026 р. з увімкненою прив’язкою й порогом переповнення 8 (авто): sticky 100 %, 38, 21, 19 і 29 запитів sticky на репліках від 0 до 3 і частка влучань у кеш префіксів 82,2; 86,0; 69,0 і 80,0 %. Лічильники ведуться від перезапуску LM Warden, і весь трафік у цьому вікні йшов з увімкненою прив’язкою: синтетичні сеанси агентів плюс реальні раунди Claude Code. Це знімок панелі, а не результат тесту. Прокрутіть зображення вбік, щоб побачити всі стовпці.
Сервер, через який ми взагалі взялися за маршрутизацію реплік, відтоді з нею й працює. На ньому сім RTX 5090 обслуговують модель 27B як сім реплік по одній карті для групи агентів Claude Code, що працюють без інтерфейсу. Наше перше правило розміщення хешувало ідентифікатор сеансу: воно було стабільним, але не враховувало навантаження. На 26 сеансах агентів приблизно по 58 тис. токенів три репліки простоювали, тоді як інші заповнювали кеш до 93 %, а частка токенів промпту, обслужених із кешу, впала з 81 % після перезапуску до 28 % приблизно за 35 хвилин. Тоді ми скоротили кількість сеансів до 16, приблизно по два на репліку, щоб робочі набори вміщалися в кеш, і почали розміщувати нові розмови на найменш завантаженій репліці. Протягом наступної години частка становила 78–79 %. Це спостереження, а не A/B-тест: одне навантаження й дві зміни, зроблені разом, тож виграш дає не лише розміщення. Емпіричне правило, яке з цього випливає: кількість одночасних сеансів, помножена на їхній типовий контекст, має бути меншою за загальний кеш сервера.
Виміряно рушієм для кожного запиту
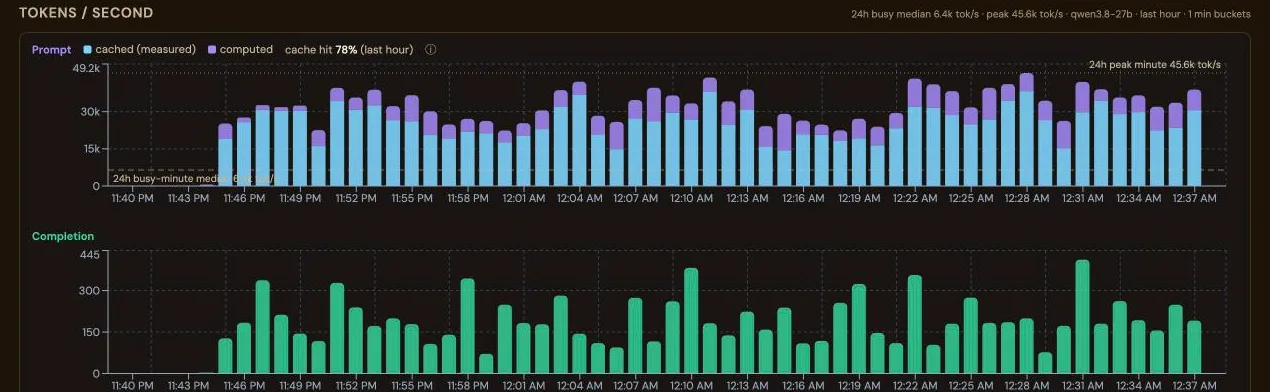
Рис. 11Токени промпту за секунду на сервері із сімома GPU, поділені на те, що кожна репліка прочитала з кешу префіксів, і те, що довелося обчислити, з часткою за останню годину: 78 %. Кешована частина — це власний підрахунок рушія для кожного завершеного запиту, а не оцінка; запит, який він не виміряв, зараховується як обчислений. Записано 5 жовтня 2026 р. Прокрутіть зображення вбік, щоб побачити всю годину.
 Прив’язку ввімкнено, поріг переповнення 8 (авто)
Частка влучань для кожної репліки, із власних лічильників vLLM
 Виміряно рушієм для кожного запиту