अगला टर्न वहीं पहुँचता है जहाँ पिछले टर्न का कैश मौजूद है।
एजेंट हर टर्न में अपनी पूरी हिस्ट्री दोबारा भेजता है, इसलिए लंबी बातचीत का ज़्यादातर हिस्सा ऐसा प्रीफ़िक्स होता है जिसे इंजन पहले ही पढ़ चुका है। vLLM यह काम अपने प्रीफ़िक्स कैश में रखता है (पहले देखे गए प्रॉम्प्ट की अटेंशन स्थिति) और अगली बार वही प्रीफ़िक्स आने पर उसे दोबारा नहीं पढ़ता, लेकिन सिर्फ़ उसी रेप्लिका पर जिसने वह काम किया था: मॉडल की हर पूरी कॉपी का अपना अलग कैश होता है। vLLM का अपना बैलेंसर हर टर्न को उस रेप्लिका पर भेजता है जिसकी क़तार सबसे छोटी हो, और उस रेप्लिका ने आम तौर पर यह बातचीत पहले कभी नहीं देखी होती, इसलिए उसे पूरी हिस्ट्री फिर से पढ़नी पड़ती है। LM Warden हर नई बातचीत को सबसे कम लोड वाली रेप्लिका पर रखता है (चल रहे अनुरोध, कैश कितना भरा है, और उस पर कितनी सक्रिय बातचीत हैं, यह देखकर) और उसे वहीं बनाए रखता है; इसके लिए वह सेशन ID इस्तेमाल करता है जो Claude Code पहले से भेजता है। कोई अनुरोध दूसरी रेप्लिका पर तभी जाता है जब मौजूदा रेप्लिका अपनी स्पिल सीमा पार कर ले: डिफ़ॉल्ट रूप से, जब चल रहे अनुरोध मॉडल की समवर्ती सीक्वेंस सीमा के एक-चौथाई से ज़्यादा हो जाएँ; हमारी चार-कार्ड मशीन पर यह 8 है।
रेप्लिका, और इसलिए यह रूटिंग, NVIDIA GPU वाले Linux इंस्टॉल का हिस्सा हैं; Mac ऐप (बीटा) में टेंसर या डेटा पैरेललिज़्म नहीं है।
चित्र 6चार रेप्लिका वाले मॉडल पर एक बातचीत के चार टर्न। vLLM के बैलेंसर के साथ, हर टर्न को जिस भी रेप्लिका को वह मिला उस पर लगभग शुरू से प्रीफ़िल किया जाता है (उसका प्रॉम्प्ट कैश में पढ़ा जाता है)। LM Warden के साथ बातचीत रेप्लिका 2 पर रहती है और सिर्फ़ नया टर्न प्रीफ़िल होता है। यह तंत्र का चित्र है, माप नहीं।
चार-कार्ड मशीन पर मापा गया: बातचीत पिन करने पर, 4 समवर्ती सेशन पर कैश से मिले प्रॉम्प्ट टोकन का हिस्सा 56 से बढ़कर 86% हो गया, और पहले बाइट तक का मीडियन समय 2.05 से घटकर 0.38 s हो गया। हमारे चलाए हर चरण में प्रति मिनट आउटपुट टोकन ज़्यादा थे, और पहले बाइट तक का p95 समय (सबसे धीमे 5%) हर चरण में कम था। काम कर रही रेप्लिका की संख्या लगभग नहीं बदली (4 सेशन पर चार में से 2.71 बनाम 2.83): फ़ायदा कैश के दोबारा उपयोग से है, ज़्यादा कार्ड के काम करने से नहीं।
24 और 32 सेशन वाले चरणों में चार छोटे कार्ड पर जान-बूझकर ज़रूरत से ज़्यादा लोड डाला गया है, जहाँ एफ़िनिटी हो या न हो, इंतज़ार दसियों सेकंड तक पहुँच जाता है। यहीं इसकी क़ीमत दिखती है: एफ़िनिटी के साथ सबसे धीमे अनुरोधों का इंतज़ार अब भी कम है, लेकिन मीडियन ज़्यादा है। आँकड़े नीचे हैं।
GPU
4 × NVIDIA RTX A4000, हर एक 16 GiB
मॉडल
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
लेआउट
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
यह रिलीज़
कैप्चर किया गया
4 अक्टूबर 2026, दोनों रन एक के ठीक बाद एक
लोड
हमारे अपने टेस्ट टूल से बनाए गए, Claude Code जैसे सिंथेटिक सेशन, असली Claude Code नहीं: लगभग 3.5k टोकन का साझा सिस्टम प्रॉम्प्ट, हर सेशन का अपना अलग पहला संदेश (तय आकार 6k, मापने पर लगभग 7.2k से 7.5k), फिर पाँच और टर्न, हर एक में लगभग 400 नए टोकन, और हर टर्न में ज़्यादा से ज़्यादा 256 टोकन आउटपुट। क्लोज़्ड लूप: पिछला टर्न ख़त्म होते ही सेशन अपना अगला टर्न शुरू करता है। हर चरण 3 मिनट।
चित्र 7समवर्ती सेशन 4 से 32 होने पर पहले बाइट तक का समय, मीडियन और p95, लॉग स्केल पर, ताकि एक सेकंड से कम वाले चरण और मिनट भर वाले चरण साथ-साथ पढ़े जा सकें। एफ़िनिटी के साथ मीडियन 16 सेशन तक काफ़ी कम है (4 पर 0.38 बनाम 2.05 s) और 24 व 32 पर ज़्यादा; p95 हर चरण में कम है, हालाँकि 16 पर अंतर (24.9 बनाम 26.2 s) इतना छोटा है कि हर स्थिति के सिर्फ़ एक रन में यह संयोग भी हो सकता है। क्लाइंट की ओर से, इंटरनेट पर, पहले स्ट्रीम हुए टोकन तक मापा गया।
Sessions
Sessions/h off → on
Output tokens/min off → on
TTFB p50 off → on (s)
TTFB p95 off → on (s)
Replicas busy off → on
Prefix hits off → on (%)
Stayed on replica (%)
4
180 → 240
5,886 → 6,744
2.05 → 0.38
3.5 → 2.84
2.71 → 2.83
56.2 → 86.4
100
8
300 → 380
8,364 → 10,752
2.33 → 0.48
6.32 → 5.03
3.74 → 3.74
44.3 → 86.1
100
16
300 → 360
9,558 → 12,204
3.25 → 0.85
26.24 → 24.88
3.91 → 3.69
33.2 → 48.6
100
24
300 → 420
9,048 → 11,178
5.06 → 13.14
58.82 → 38.34
3.91 → 4
32.8 → 37.9
89.1
32
520 → 620
14,760 → 16,638
12.32 → 27.66
82.84 → 38.92
4 → 4
31.6 → 31.6
67.3
हमारी चार-कार्ड मशीन पर एक छोटे मॉडल के साथ मापा गया: पहले एफ़िनिटी बंद, फिर चालू, बीच में vLLM रीस्टार्ट किए बिना। इसलिए दूसरा रन पहले से भरे प्रीफ़िक्स कैश के साथ शुरू हुआ, और दोनों रन के प्रॉम्प्ट एक ही सीड से बने। हर चरण 3 मिनट चलता है, इसलिए उसमें सिर्फ़ 9 से 31 सेशन पूरे होते हैं और एक सेशन कम-ज़्यादा होने से प्रति घंटा सेशन का आँकड़ा 20 तक बदल जाता है; प्रति मिनट आउटपुट टोकन ज़्यादा भरोसेमंद कॉलम है। आपका मॉडल, कार्ड और वर्कलोड अलग होंगे; मॉडल के पेज पर रेप्लिका कार्ड आपकी मशीन के लिए यही काउंटर दिखाता है।
16 सेशन तक एफ़िनिटी हर चरण में थ्रूपुट, प्रीफ़िक्स-कैश हिट और पहले बाइट तक के समय के दोनों कॉलम में आगे है: 4 सेशन पर हिट 56 से 86% हो जाते हैं, पहले बाइट तक का मीडियन समय 2.05 से 0.38 s, और आउटपुट 5,886 से 6,744 टोकन प्रति मिनट (प्रति घंटा सेशन 180 से 240)। 24 और 32 सेशन पर, यानी ओवरलोड वाले चरणों में, हर रेप्लिका पूरी तरह भरी है। आउटपुट अब भी ज़्यादा है (11,178 बनाम 9,048 और 16,638 बनाम 14,760 टोकन प्रति मिनट) और सबसे धीमे अनुरोधों का इंतज़ार काफ़ी कम है (p95 38 बनाम 59 s, और 39 बनाम 83 s), लेकिन एफ़िनिटी के साथ पहले बाइट तक का मीडियन समय ख़राब है: 24 सेशन पर 13.1 बनाम 5.1 s, 32 पर 27.7 बनाम 12.3 s। इसकी वजह हमने अभी अलग से पता नहीं की है, और स्पिल सीमा 8 से घटाकर 4 करने से भी यह नहीं बदला। फ़ायदा तब सबसे ज़्यादा होता है जब गुंजाइश हो; जो मशीन अपनी सीमा पर चलती है, उस पर दोनों सेटिंग माप लेनी चाहिए, और एफ़िनिटी हर मॉडल के लिए अलग से बंद की जा सकती है।
चित्र 8चार में से व्यस्त रेप्लिका: हर पोल पर जिन रेप्लिका में अनुरोध चल रहे थे, एक चरण में औसत। यह GPU उपयोग नहीं है। एफ़िनिटी इसे लगभग नहीं बदलती; फ़ायदा चित्र 9 में है।
चित्र 9हर चरण में प्रीफ़िक्स-कैश हिट दर: कैश से दिए गए प्रॉम्प्ट टोकन को माँगे गए कुल प्रॉम्प्ट टोकन से भाग देकर, चारों रेप्लिका को मिलाकर, चरण के दौरान vLLM के अपने काउंटर में आए बदलाव से निकाली गई। यह फ़ायदा तब तक रहता है जब तक गुंजाइश है, और 32 सेशन पर ख़त्म हो जाता है, जहाँ बातचीत दूसरी रेप्लिका पर स्पिल होने लगती है।
एफ़िनिटी चालू, स्पिल सीमा 8 (auto)हर रेप्लिका की हिट दर, vLLM के अपने काउंटर से
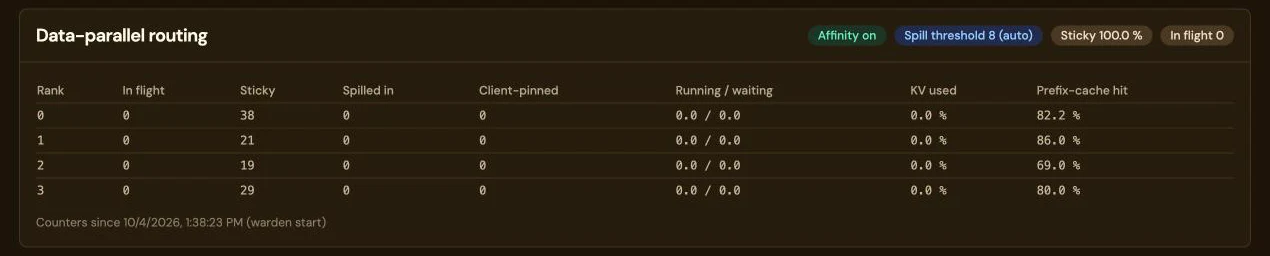
चित्र 10मॉडल के पेज पर वही काउंटर: हर रेप्लिका की एक पंक्ति, जिसमें उसके पास मौजूद अनुरोध, कितनी बातचीत वहीं टिकी रहीं (sticky) या स्पिल होकर आईं, क्या चल रहा है और क्या प्रतीक्षा में है, इस्तेमाल में KV कैश और प्रीफ़िक्स-कैश हिट दर। 4 अक्टूबर 2026 को एफ़िनिटी चालू और स्पिल सीमा 8 (auto) के साथ रिकॉर्ड किया गया: sticky 100%, रेप्लिका 0 से 3 पर 38, 21, 19 और 29 sticky अनुरोध, और प्रीफ़िक्स-कैश हिट दर 82.2, 86.0, 69.0 और 80.0%। काउंटर warden के रीस्टार्ट से गिन रहे हैं, और उस दौरान का सारा ट्रैफ़िक एफ़िनिटी चालू रहते चला: सिंथेटिक एजेंट सेशन और असली Claude Code टर्न। यह कंसोल के कार्ड का स्क्रीनशॉट है, बेंचमार्क का नतीजा नहीं। हर कॉलम देखने के लिए इमेज को दाएँ-बाएँ स्क्रॉल करें।
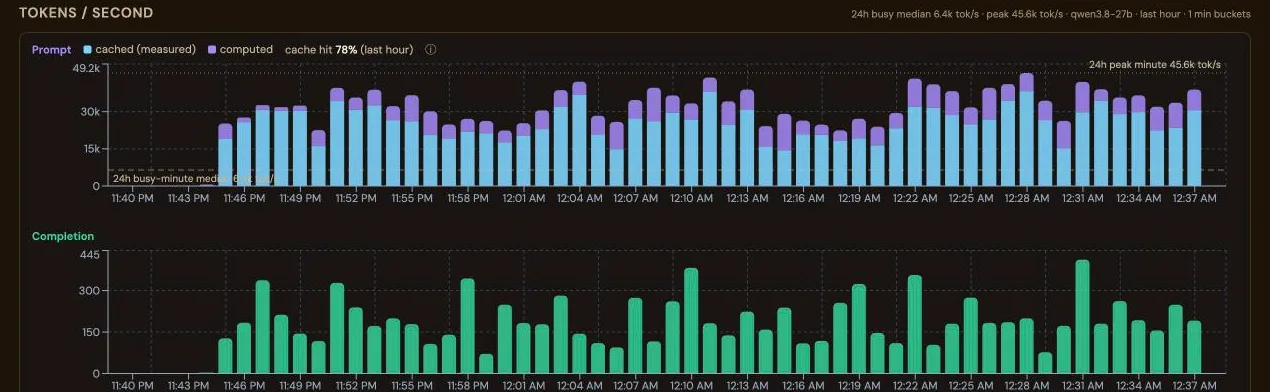
जिस मशीन पर सबसे पहले रेप्लिका रूटिंग की ज़रूरत महसूस हुई, वह तब से इसी के साथ चल रही है। उसमें सात RTX 5090 हैं, जो एक 27B मॉडल को सात एक-कार्ड रेप्लिका के रूप में चलाकर हेडलेस Claude Code एजेंटों के एक पूरे समूह को जवाब देते हैं। हमारा पहला प्लेसमेंट नियम सेशन ID के हैश पर चलता था: बातचीत अपनी रेप्लिका पर टिकी रहती थी, लेकिन लोड का ध्यान नहीं रखा जाता था। लगभग 58k टोकन वाले 26 एजेंट सेशन के साथ तीन रेप्लिका ख़ाली पड़ी रहीं, जबकि बाकी का कैश 93% तक भर गया, और कैश से मिले प्रॉम्प्ट टोकन का हिस्सा रीस्टार्ट के बाद के 81% से लगभग 35 मिनट में 28% पर आ गया। फिर हमने सेशन घटाकर 16 कर दिए, यानी हर रेप्लिका पर लगभग दो, ताकि सक्रिय डेटा कैश में समा जाए, और नई बातचीत को सबसे कम लोड वाली रेप्लिका पर रखना शुरू किया। अगले घंटे में यह हिस्सा 78 से 79% रहा। यह एक अवलोकन है, A/B टेस्ट नहीं: एक ही वर्कलोड और एक साथ किए गए दो बदलाव, इसलिए पूरा फ़ायदा सिर्फ़ प्लेसमेंट का नहीं है। इससे एक मोटा अनुमान निकलता है: समवर्ती सेशन की संख्या गुणा उनका सामान्य कॉन्टेक्स्ट, मशीन के कुल कैश से कम रखें।
इंजन द्वारा, हर अनुरोध के लिए मापा गया
चित्र 11सात-GPU मशीन पर प्रति सेकंड प्रॉम्प्ट टोकन, दो हिस्सों में: हर रेप्लिका ने अपने प्रीफ़िक्स कैश से क्या पढ़ा और उसे नए सिरे से क्या गणना करनी पड़ी, साथ में पिछले घंटे का कैश हिस्सा: 78%। कैश वाला हिस्सा हर पूरे हुए अनुरोध के लिए इंजन की अपनी गिनती है, अनुमान नहीं; जिस अनुरोध को इंजन ने नहीं मापा, वह गणना वाले हिस्से में गिना जाता है। 5 अक्टूबर 2026 को रिकॉर्ड किया गया। पूरा घंटा देखने के लिए इमेज को दाएँ-बाएँ स्क्रॉल करें।
 एफ़िनिटी चालू, स्पिल सीमा 8 (auto)
हर रेप्लिका की हिट दर, vLLM के अपने काउंटर से
 इंजन द्वारा, हर अनुरोध के लिए मापा गया