LM Warden

次のターンは、前のターンがキャッシュを残した場所へ。

エージェントは毎ターン履歴全体を送り直すので、長い会話の大部分はエンジンがすでに読んだプレフィックスです。vLLM はその処理結果をプレフィックス キャッシュ (見たことのあるプロンプトのアテンション状態) に保持し、同じプレフィックスが次に来たときには処理を省きます。ただし、それが有効なのは処理を行ったレプリカだけです。モデルの完全なコピーはそれぞれ独自のキャッシュを持っています。vLLM 自身のバランサーは各ターンをキューが最も短いレプリカに送りますが、そのレプリカは通常その会話を一度も処理していないため、履歴全体をもう一度読み込むことになります。LM Warden は、新しい会話を最も負荷の低いレプリカ (実行中のリクエスト、キャッシュの埋まり具合、保持している進行中の会話の数で判断) に配置し、Claude Code がすでに送っているセッション ID を使ってそこに留めます。リクエストを移すのは、そのレプリカがスピルしきい値を超えたときだけです。既定では、実行中のリクエストがモデルの同時シーケンス上限の四分の一を超えたときで、四枚のカードを積んだ自社マシンでは 8 です。

レプリカと、それを前提とするこのルーティングは、NVIDIA GPU を使う Linux インストールの機能です。Mac アプリ (ベータ版) にはテンソル並列もデータ並列もありません。

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
図 6四レプリカのモデルでの一つの会話の四ターン。vLLM のバランサーでは、各ターンが受け取ったレプリカでほぼ最初からプリフィル (プロンプトをキャッシュに読み込むこと) されます。LM Warden では会話がレプリカ 2 に留まり、新しいターンだけがプリフィルされます。仕組みの図であり、測定結果ではありません。

四枚のカードを積んだマシンでの実測:会話を固定すると、同時 4 セッションでキャッシュから提供されたプロンプト トークンの割合は 56 から 86% に上がり、最初のバイトまでの時間の中央値は 2.05 から 0.38 s に下がりました。毎分の出力トークン数は実行したすべての段階で高く、最初のバイトまでの時間の p95 (最も遅い 5%) もすべての段階で低くなりました。処理を行っているレプリカの数はほとんど変わりません (4 セッションで四つ中 2.71 対 2.83)。効果はキャッシュの再利用によるもので、働くカードが増えたからではありません。

24 と 32 セッションの段階は、小さなカード四枚に対する意図的な過負荷で、アフィニティの有無にかかわらず待ち時間は数十秒に達します。そこではトレードオフが現れます。アフィニティありのほうがテール レイテンシは依然として短いものの、中央値は長くなります。数値は以下のとおりです。

GPU
4 × NVIDIA RTX A4000、各 16 GiB
モデル
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507)、bf16
レイアウト
data_parallel_size 4、tensor_parallel_size 1
vLLM
0.26.0
LM Warden
このリリース
記録日
2026 年 10 月 4 日、両条件を連続して実行
負荷
Claude Code そのものではなく、自社のテスト ハーネスによる Claude Code 風の合成セッション:約 3.5k トークンの共通システム プロンプト、セッション固有の最初のメッセージ (公称 6k、実測約 7.2k~7.5k)、続いてそれぞれ約 400 トークンを新たに加えるターンがさらに五つ。出力はターンあたり最大 256 トークン。クローズド ループで、前のターンが終わるとセッションは次のターンを始めます。各段階 3 分。
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
図 7同時 4~32 セッションでの最初のバイトまでの時間 (中央値と p95)。一秒未満の段階と一分近い段階を並べて読めるよう対数目盛です。アフィニティありでは 16 セッションまで中央値がはるかに低く (4 セッションで 0.38 対 2.05 s)、24 と 32 では高くなります。p95 はすべての段階で低いものの、16 での差 (24.9 対 26.2 s) は各条件一回ずつの実行のノイズの範囲内です。クライアント側で、インターネット経由、最初にストリーミングされたトークンまでを測定。
SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

四枚のカードを積んだ自社マシンで小さなモデルを使い、アフィニティをまずオフ、次にオンにして、間で vLLM を再起動せずに測定しました。二回目はプレフィックス キャッシュが温まった状態で始まり、両方とも同じシードからプロンプトを生成しています。各段階は 3 分なので、完了するセッションは 9~31 にとどまり、セッションが一つ増減するだけで一時間あたりのセッション数が 20 動きます。毎分の出力トークン数のほうが安定した列です。モデル、カード、ワークロードによって結果は異なります。モデルのページにあるレプリカ カードで、自分の環境の同じカウンターを確認できます。

16 セッションまでは、スループット、プレフィックス キャッシュ ヒット、最初のバイトまでの時間の両方の列で、アフィニティがすべての段階で優位です。4 セッションでヒット率は 56 から 86% に、最初のバイトまでの時間の中央値は 2.05 から 0.38 s に、出力は毎分 5,886 から 6,744 トークンに (一時間あたりのセッション数は 180 から 240 に) なります。過負荷の段階である 24 と 32 セッションでは、すべてのレプリカが飽和します。出力はそれでも高く (毎分 11,178 対 9,048 トークン、16,638 対 14,760 トークン)、テール レイテンシもずっと短い (p95 で 38 対 59 s、39 対 83 s) のですが、最初のバイトまでの時間の中央値はアフィニティありのほうが悪くなります (24 セッションで 13.1 対 5.1 s、32 セッションで 27.7 対 12.3 s)。原因はまだ特定できておらず、スピルしきい値を 8 から 4 に下げても変わりませんでした。効果が最も大きいのは余裕があるときです。上限近くで動いているマシンでは両方の設定を測定してください。アフィニティはモデルごとにオフにできます。

Replicas busy by concurrent sessionsAverage replicas with running requests, of four, affinity on against vLLM’s balancer: 4 sessions 2.71 off, 2.83 on; 8 sessions 3.74 off, 3.74 on; 16 sessions 3.91 off, 3.69 on; 24 sessions 3.91 off, 4 on; 32 sessions 4 off, 4 on.affinity onvLLM balancerReplicas busy01234replicas busy, of 448162432concurrent sessionsvLLM balancer, 4 sessions: 2.71vLLM balancer, 8 sessions: 3.74vLLM balancer, 16 sessions: 3.91vLLM balancer, 24 sessions: 3.91vLLM balancer, 32 sessions: 4vLLM balanceraffinity on, 4 sessions: 2.83affinity on, 8 sessions: 3.74affinity on, 16 sessions: 3.69affinity on, 24 sessions: 4affinity on, 32 sessions: 4affinity on
図 8稼働中のレプリカ数 (四つ中):各ポーリング時にリクエストを実行していたレプリカの数を、段階ごとに平均したもの。GPU 使用率ではありません。アフィニティはこれをほとんど変えません。効果は図 9 に表れています。
Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
図 9各段階のプレフィックス キャッシュ ヒット率:キャッシュから提供されたプロンプト トークン数を要求されたプロンプト トークン数で割ったもの。四つのレプリカすべてを合算し、その段階での vLLM 自身のカウンターの変化から算出。効果は余裕があるうちは続き、会話がスピルする 32 セッションでは消えます。
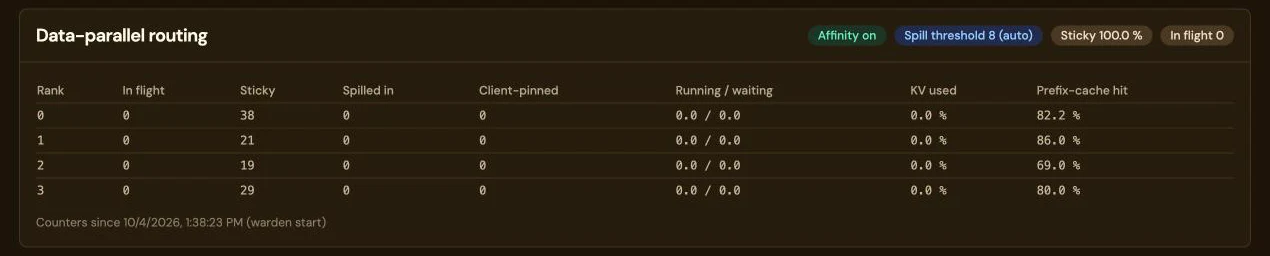
モデルのページにある Data-parallel routing カード。ラベルには Affinity on、Spill threshold 8 (auto)、Sticky 100.0%、In flight 0。表にはレプリカ 0~3 の実行中、スティッキー (38、21、19、29)、スピルによる受け入れ、クライアント固定、実行中と待機中、KV 使用量、プレフィックス キャッシュ ヒット率 (82.2、86.0、69.0、80.0%) が並び、カウンターは warden の起動時から集計されているという一行がある。 アフィニティ オン、スピルしきい値 8 (自動) レプリカごとのヒット率 (vLLM 自身のカウンターから)
図 10モデルのページにある同じカウンター:レプリカごとに一行で、保持しているリクエスト、留まった会話 (sticky) とスピルで来た会話の数、実行中と待機中の数、使用中の KV キャッシュ、プレフィックス キャッシュ ヒット率を表示します。2026 年 10 月 4 日、アフィニティ オン、スピルしきい値 8 (自動) で記録:sticky 100%、レプリカ 0~3 の sticky リクエストは 38、21、19、29、プレフィックス キャッシュ ヒット率は 82.2、86.0、69.0、80.0%。カウンターは warden の再起動から集計されており、その期間のトラフィックはすべてアフィニティ オンで流れました。合成のエージェント セッションと、実際の Claude Code のターンです。画像はコンソールのカードそのもので、ベンチマーク結果ではありません。画像を横にスクロールするとすべての列が見られます。

最初にレプリカ ルーティングのきっかけとなったマシンは、それ以来このルーティングで動いています。RTX 5090 を七枚積み、27B モデルを一枚ずつ七つのレプリカとして、ヘッドレスの Claude Code エージェント群に提供しています。最初の配置ルールはセッション ID をハッシュするもので、スティッキーではあるものの負荷が見えていませんでした。それぞれ約 58k トークンのエージェント セッションが 26 あると、三つのレプリカがアイドル状態のままである一方でほかのレプリカはキャッシュを 93% まで使い、キャッシュから提供されたプロンプト トークンの割合は、再起動後の 81% から約 35 分で 28% まで落ちました。そこでエージェント群を 16 セッション (レプリカあたり約二つ) に減らしてワーキング セットがキャッシュに収まるようにし、新しい会話を最も負荷の低いレプリカに配置しました。その後の一時間は 78~79% でした。これは A/B テストではなく観察です。一つのワークロードで二つの変更を同時に行ったので、効果は配置だけによるものではありません。ここから言える経験則は、同時セッション数と典型的なコンテキスト長の積を、マシンのキャッシュ総量より小さく抑えることです。
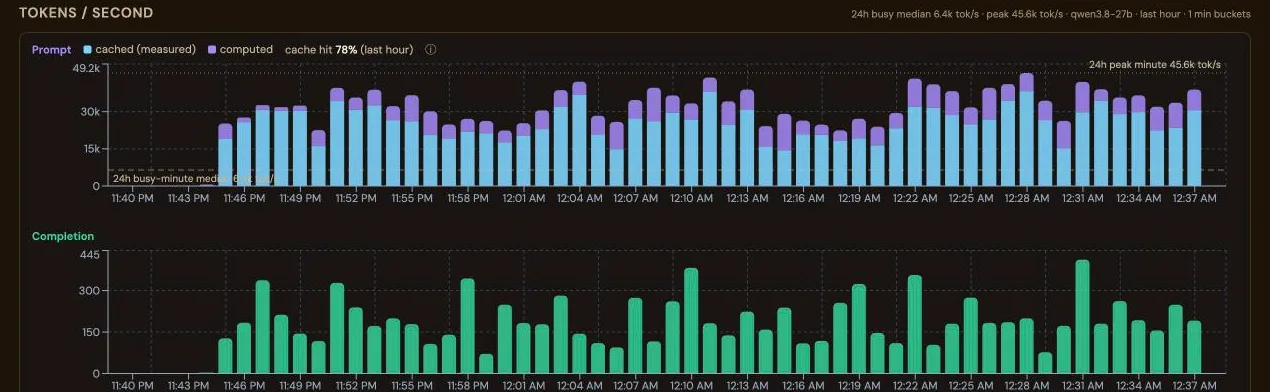
Stats ページの一時間分の Tokens per second グラフ。プロンプトの棒はキャッシュ分 (実測、青) と計算分 (紫) に分かれ、毎秒約 15k~45k トークンの間で、どの棒も大部分が青。概要には直近一時間のキャッシュ ヒット 78% とある。毎秒の生成トークン数は約 70~420 で、下に緑で描かれている。 リクエストごとにエンジンが測定
図 11GPU 七枚のマシンでの毎秒のプロンプト トークン数。各レプリカがプレフィックス キャッシュから読んだ分と計算が必要だった分に分け、直近一時間の割合 78% を示しています。キャッシュ分は完了した各リクエストについてのエンジン自身のカウントで、推定ではありません。エンジンが測定しなかったリクエストは計算分として数えます。2026 年 10 月 5 日に記録。画像を横にスクロールすると一時間全体が見られます。