LM Warden

Chaque tour est envoyé là où le précédent a laissé son cache.

Un agent renvoie tout son historique à chaque tour, si bien qu’une longue conversation se compose surtout d’un préfixe que le moteur a déjà lu. vLLM conserve ce travail dans son cache de préfixes (l’état d’attention des prompts déjà vus) et s’en dispense la fois suivante, quand le même préfixe revient, mais seulement sur le réplica qui a effectué le travail : chaque copie complète du modèle a son propre cache. Le répartiteur intégré à vLLM envoie chaque tour au réplica dont la file d’attente est la plus courte ; celui-ci n’a généralement jamais vu la conversation et relit donc tout l’historique. LM Warden place chaque nouvelle conversation sur le réplica le moins chargé (requêtes en cours, taux de remplissage de son cache et nombre de conversations actives qu’il détient) et l’y maintient, grâce à l’ID de session que Claude Code envoie déjà. Il ne déplace une requête que lorsque ce réplica dépasse son seuil de débordement : par défaut, quand les requêtes en cours dépassent le quart de la limite de séquences simultanées du modèle, soit 8 sur notre machine à quatre cartes.

Les réplicas, et donc ce routage, font partie de l’installation Linux avec GPU NVIDIA ; l’app Mac (bêta) n’offre ni parallélisme de tenseurs ni parallélisme de données.

Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history, every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Why affinity: one conversation over four turnsTwo panels of four replicas. First: each of four turns of one conversation lands on a different replica and is almost entirely prefilled from scratch. Second: all four turns stay on one replica and only the new turn is prefilled; the rest is served from the prefix cache.served from the prefix cacheprefilled from scratchvLLM’s balancer: a turn lands anywherereplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: about the whole history,every turnLM Warden: a conversation stays on its replicareplica 0replica 1replica 2replica 3t1t2t3t4prefilled again: only the new turn
Fig. 6Quatre tours d’une conversation sur un modèle à quatre réplicas. Avec le répartiteur de vLLM, chaque tour repasse par le prefill (le moteur lit le prompt et remplit son cache) presque depuis zéro, sur le réplica qui l’a reçu. Avec LM Warden, la conversation reste sur le réplica 2 et seul le nouveau tour passe par le prefill. Un schéma du mécanisme, pas une mesure.

Mesuré sur la machine à quatre cartes : avec les conversations fixées sur leur réplica, la part des jetons de prompt servis par le cache est passée de 56 à 86 % à 4 sessions simultanées, et le délai médian avant le premier octet est tombé de 2,05 à 0,38 s. Le nombre de jetons de sortie par minute était plus élevé à chaque palier testé, et le délai p95 avant le premier octet (les 5 % les plus lents) plus bas à chaque palier. Le nombre de réplicas réellement actifs a à peine bougé (2,71 contre 2,83 sur quatre à 4 sessions) : le gain vient de la réutilisation du cache, non d’un plus grand nombre de cartes sollicitées.

Les paliers à 24 et 32 sessions sont une surcharge délibérée de quatre petites cartes, où les attentes atteignent des dizaines de secondes, avec ou sans affinité. Le compromis y apparaît : les requêtes les plus lentes attendent toujours moins avec l’affinité, mais la médiane est plus longue. Les chiffres suivent.

GPU
4 × NVIDIA RTX A4000, 16 Gio chacune
Modèle
qwen3-4b-dp4 (Qwen/Qwen3-4B-Instruct-2507), bf16
Répartition
data_parallel_size 4, tensor_parallel_size 1
vLLM
0.26.0
LM Warden
Cette version
Relevé
4 octobre 2026, les deux séries l’une après l’autre
Charge
Des sessions synthétiques du type Claude Code générées par notre propre banc de test, et non Claude Code lui-même : un prompt système partagé d’environ 3,5 k jetons, un premier message propre à chaque session (6 k en nominal, environ 7,2 k à 7,5 k mesurés), puis cinq tours supplémentaires d’environ 400 nouveaux jetons chacun, avec au plus 256 jetons générés par tour. Boucle fermée : une session lance son tour suivant dès que le précédent se termine. 3 minutes par palier.
Time to first byte by concurrent sessionsMedian and 95th-percentile time to first byte on the four-card box at 4 to 32 concurrent sessions, affinity on against vLLM’s balancer, on a log scale from 0.3 to 100 seconds. 4 sessions: median 2.05 s off, 0.38 s on, p95 3.5 s off, 2.84 s on; 8 sessions: median 2.33 s off, 0.48 s on, p95 6.32 s off, 5.03 s on; 16 sessions: median 3.25 s off, 0.85 s on, p95 26.24 s off, 24.88 s on; 24 sessions: median 5.06 s off, 13.14 s on, p95 58.82 s off, 38.34 s on; 32 sessions: median 12.32 s off, 27.66 s on, p95 82.84 s off, 38.92 s on.affinity onvLLM balancerTime to first byte, median0.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 2.05 svLLM balancer, 8 sessions: 2.33 svLLM balancer, 16 sessions: 3.25 svLLM balancer, 24 sessions: 5.06 svLLM balancer, 32 sessions: 12.32 svLLM balanceraffinity on, 4 sessions: 0.38 saffinity on, 8 sessions: 0.48 saffinity on, 16 sessions: 0.85 saffinity on, 24 sessions: 13.14 saffinity on, 32 sessions: 27.66 saffinity onTime to first byte, p950.3131030100seconds, log scale48162432concurrent sessionsvLLM balancer, 4 sessions: 3.5 svLLM balancer, 8 sessions: 6.32 svLLM balancer, 16 sessions: 26.24 svLLM balancer, 24 sessions: 58.82 svLLM balancer, 32 sessions: 82.84 svLLM balanceraffinity on, 4 sessions: 2.84 saffinity on, 8 sessions: 5.03 saffinity on, 16 sessions: 24.88 saffinity on, 24 sessions: 38.34 saffinity on, 32 sessions: 38.92 saffinity on
Fig. 7Délai avant le premier octet de 4 à 32 sessions simultanées, médiane et p95, sur une échelle logarithmique pour que les paliers inférieurs à la seconde restent lisibles à côté de ceux qui atteignent la minute. Avec l’affinité, la médiane est bien plus basse jusqu’à 16 sessions (0,38 contre 2,05 s à 4) et plus haute à 24 et 32 ; le p95 est plus bas à chaque palier, même si à 16 l’écart (24,9 contre 26,2 s) reste dans le bruit d’une seule exécution par série. Mesuré côté client, via Internet, jusqu’au premier jeton reçu en streaming.
SessionsSessions/h off → onOutput tokens/min off → onTTFB p50 off → on (s)TTFB p95 off → on (s)Replicas busy off → onPrefix hits off → on (%)Stayed on replica (%)
4180 → 2405,886 → 6,7442.05 → 0.383.5 → 2.842.71 → 2.8356.2 → 86.4100
8300 → 3808,364 → 10,7522.33 → 0.486.32 → 5.033.74 → 3.7444.3 → 86.1100
16300 → 3609,558 → 12,2043.25 → 0.8526.24 → 24.883.91 → 3.6933.2 → 48.6100
24300 → 4209,048 → 11,1785.06 → 13.1458.82 → 38.343.91 → 432.8 → 37.989.1
32520 → 62014,760 → 16,63812.32 → 27.6682.84 → 38.924 → 431.6 → 31.667.3

Mesuré sur notre machine à quatre cartes avec un petit modèle, affinité d’abord désactivée puis activée, sans redémarrer vLLM entre les deux : la seconde série a démarré avec un cache de préfixes déjà chaud, et les deux ont tiré leurs prompts de la même graine. Chaque palier ne dure que 3 minutes, si bien qu’il ne termine que 9 à 31 sessions et qu’une session de plus ou de moins fait varier de 20 le nombre de sessions par heure ; la colonne la plus stable est celle des jetons de sortie par minute. Votre modèle, vos cartes et votre charge de travail seront différents ; le panneau des réplicas, sur la page d’un modèle, affiche les mêmes compteurs pour les vôtres.

Jusqu’à 16 sessions, l’affinité l’emporte à chaque palier sur le débit, les succès de cache de préfixes et les deux colonnes de délai avant le premier octet : les succès passent de 56 à 86 % à 4 sessions, le délai médian avant le premier octet de 2,05 à 0,38 s, et la sortie de 5 886 à 6 744 jetons par minute (de 180 à 240 sessions par heure). À 24 et 32 sessions, les paliers de surcharge, chaque réplica est saturé. La sortie reste plus élevée (11 178 contre 9 048 et 16 638 contre 14 760 jetons par minute) et les requêtes les plus lentes attendent bien moins (p95 38 contre 59 s, et 39 contre 83 s), mais le délai médian avant le premier octet est moins bon avec l’affinité : 13,1 contre 5,1 s à 24 sessions, 27,7 contre 12,3 s à 32. Nous n’en avons pas isolé la cause, et abaisser le seuil de débordement de 8 à 4 n’y a rien changé. L’avantage est maximal tant qu’il reste de la marge ; sur une machine qui tourne à sa limite, mesurez les deux réglages, sachant que l’affinité peut être désactivée modèle par modèle.
Replicas busy by concurrent sessionsAverage replicas with running requests, of four, affinity on against vLLM’s balancer: 4 sessions 2.71 off, 2.83 on; 8 sessions 3.74 off, 3.74 on; 16 sessions 3.91 off, 3.69 on; 24 sessions 3.91 off, 4 on; 32 sessions 4 off, 4 on.affinity onvLLM balancerReplicas busy01234replicas busy, of 448162432concurrent sessionsvLLM balancer, 4 sessions: 2.71vLLM balancer, 8 sessions: 3.74vLLM balancer, 16 sessions: 3.91vLLM balancer, 24 sessions: 3.91vLLM balancer, 32 sessions: 4vLLM balanceraffinity on, 4 sessions: 2.83affinity on, 8 sessions: 3.74affinity on, 16 sessions: 3.69affinity on, 24 sessions: 4affinity on, 32 sessions: 4affinity on
Fig. 8Réplicas actifs, sur quatre : nombre de réplicas ayant des requêtes en cours à chaque relevé, en moyenne sur un palier. Ce n’est pas l’utilisation des GPU. L’affinité ne le modifie presque pas ; le gain apparaît dans la fig. 9.
Prefix-cache hit rate by concurrent sessionsShare of prompt tokens served from the prefix cache in each step, all four replicas pooled, affinity on against vLLM’s balancer: 4 sessions 56.2% off, 86.4% on; 8 sessions 44.3% off, 86.1% on; 16 sessions 33.2% off, 48.6% on; 24 sessions 32.8% off, 37.9% on; 32 sessions 31.6% off, 31.6% on.affinity onvLLM balancerPrefix-cache hit rate0255075100% of prompt tokens48162432concurrent sessionsvLLM balancer, 4 sessions: 56.2%vLLM balancer, 8 sessions: 44.3%vLLM balancer, 16 sessions: 33.2%vLLM balancer, 24 sessions: 32.8%vLLM balancer, 32 sessions: 31.6%vLLM balanceraffinity on, 4 sessions: 86.4%affinity on, 8 sessions: 86.1%affinity on, 16 sessions: 48.6%affinity on, 24 sessions: 37.9%affinity on, 32 sessions: 31.6%affinity on
Fig. 9Taux de succès du cache de préfixes à chaque palier : jetons de prompt servis par le cache rapportés aux jetons de prompt demandés, les quatre réplicas cumulés, d’après la variation des propres compteurs de vLLM sur le palier. Le gain se maintient tant qu’il reste de la marge et disparaît à 32 sessions, quand les conversations débordent vers d’autres réplicas.
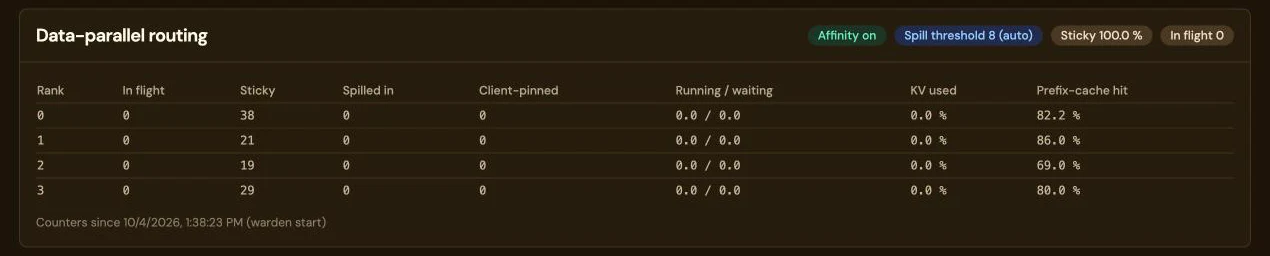
Le panneau Data-parallel routing sur la page d’un modèle, avec les badges Affinity on, Spill threshold 8 (auto), Sticky 100.0% et In flight 0. Un tableau liste les réplicas 0 à 3 avec in flight, sticky (38, 21, 19 et 29), spilled in, client-pinned, running et waiting, le KV utilisé et le taux de succès du cache de préfixes (82,2 ; 86,0 ; 69,0 et 80,0 %), et une ligne indiquant que les compteurs comptent depuis le démarrage du warden. Affinité activée, seuil de débordement 8 (auto) Taux de succès par réplica, d’après les propres compteurs de vLLM
Fig. 10Les mêmes compteurs sur la page d’un modèle : une ligne par réplica avec les requêtes qu’il détient, le nombre de conversations restées sur place (sticky) ou arrivées par débordement, ce qui s’exécute et ce qui attend, le cache KV utilisé et le taux de succès du cache de préfixes. Relevé le 4 octobre 2026 avec l’affinité activée et le seuil de débordement à 8 (auto) : sticky 100 %, 38, 21, 19 et 29 requêtes sticky sur les réplicas 0 à 3, et un taux de succès du cache de préfixes de 82,2 ; 86,0 ; 69,0 et 80,0 %. Les compteurs partent du redémarrage du warden, et tout le trafic de cette période s’est déroulé avec l’affinité activée : des sessions d’agent synthétiques et de vrais tours de Claude Code. C’est une capture du panneau, pas un résultat de mesure. Faites défiler l’image horizontalement pour voir toutes les colonnes.

La machine qui est à l’origine du routage par réplica l’utilise depuis. Elle compte sept RTX 5090 qui servent un modèle 27B, sous forme de sept réplicas d’une carte chacun, à une ferme d’agents Claude Code sans interface. Notre première règle de placement hachait l’ID de session : chaque session restait bien sur son réplica, mais sans tenir compte de la charge. Avec 26 sessions d’agent d’environ 58 k jetons chacune, trois réplicas restaient inactifs pendant que d’autres remplissaient leur cache jusqu’à 93 %, et la part des jetons de prompt servis par le cache est tombée de 81 % après un redémarrage à 28 % en 35 minutes environ. Nous avons alors réduit la ferme à 16 sessions, environ deux par réplica, pour que les ensembles de travail tiennent dans le cache, et placé les nouvelles conversations sur le réplica le moins chargé. Sur l’heure suivante, cette part s’est établie entre 78 et 79 %. C’est une observation, pas un test A/B : une seule charge de travail et deux changements simultanés, donc le gain n’est pas dû au seul placement. La règle empirique qui s’en dégage : le nombre de sessions simultanées multiplié par leur contexte typique doit rester inférieur au cache total de la machine.
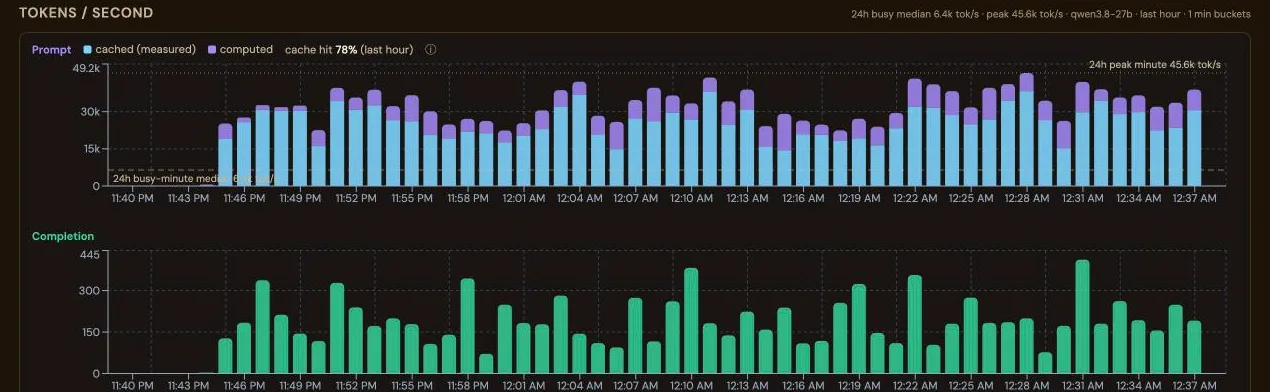
Le graphique Tokens per second de la page Stats sur une heure. Les barres de prompt sont divisées entre jetons en cache (mesurés), en bleu, et jetons calculés, en violet, entre environ 15 k et 45 k jetons par seconde, la majeure partie de chaque barre étant bleue, avec le résumé cache hit 78% sur la dernière heure. Les jetons de complétion par seconde, entre environ 70 et 420, sont tracés en vert en dessous. Mesuré par le moteur, par requête
Fig. 11Jetons de prompt par seconde sur la machine à sept GPU, répartis entre ce que chaque réplica a lu dans son cache de préfixes et ce qu’il a dû calculer, avec la part sur la dernière heure : 78 %. La partie en cache est le décompte établi par le moteur lui-même pour chaque requête terminée, pas une estimation ; une requête qu’il n’a pas mesurée est comptée comme calculée. Relevé le 5 octobre 2026. Faites défiler l’image horizontalement pour voir toute l’heure.