LM Warden

Les petits plus que vous découvrirez une fois LM Warden en service.

God mode
Suivez en temps réel les prompts et les réponses d’une clé, depuis un panneau sur sa page. Conservés uniquement en mémoire, diffusés seulement pendant que le panneau est ouvert, et désactivés tant que vous ne définissez pas VW_GODMODE_ENABLED.
Jetons admin
Les jetons vwa_ permettent aux scripts, à la CI et aux agents de piloter l’API de contrôle sans mot de passe administrateur, sans gestion de cookies de session ni en-tête CSRF. Affichés une seule fois, stockés sous forme de hachage SHA-256.
Un gestionnaire de cache HuggingFace
Ce qui occupe le disque et à quel modèle cela appartient. Supprimez les fichiers orphelins, et exportez ou importez tout le cache sous forme d’archive tar.
Un seul port
L’interface, l’API de contrôle et /v1 partagent :8080. Votre propre terminaison TLS, ingress ou SSO se place devant sans modification.
Aucune connexion sortante nécessaire
Trois archives d’images et, en option, une archive du cache de modèles : c’est tout ce qu’il faut transférer vers un hôte isolé du réseau. HF_HUB_OFFLINE=1 bloque même le téléchargement des poids.
Statistiques du Router
Chaque décision sur /router/stats : local, transmis, repli, refusé, avec le motif, par règle et par cible, et l’état du disjoncteur. Compteurs propres à chaque processus ; aucun en-tête ni corps de requête n’est enregistré.
Une page de configuration par client
Connect génère la configuration de Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, des SDK Anthropic et OpenAI et de trois éditeurs, avec l’adresse de ce warden, une clé et un modèle chargé, et envoie une requête de test.
Codex CLI
Testé le 5 octobre 2026 sur un warden avec Codex 0.160 : appels de l’outil shell, modification d’un fichier, session maintenue sur un seul réplica. La réflexion est activée par défaut ; model_reasoning_effort = "none" la désactive. Modèles locaux uniquement : les règles du routeur ne s’appliquent pas.
Un espace de chat pour tester
Discutez avec un modèle chargé dans le navigateur, images comprises, avant de confier une clé à qui que ce soit.

Trois choses apprises à nos dépens.

Le moteur a planté quatre fois en une journée, et le proxy continuait de lui transmettre des requêtes.

Le cœur du moteur vLLM plantait tandis que le processus parent vllm serve restait actif : le processus semblait vivant et les requêtes continuaient de lui être envoyées. Désormais, un chien de garde interroge le point de terminaison /health du moteur lui-même plutôt que la table des processus. Quand le moteur cesse de répondre, le chien de garde conserve les éléments de diagnostic, dont les dernières lignes du journal, et recharge le modèle.

Le panneau de journal en direct d’un modèle sous charge : des lignes du serveur d’API vLLM répondant à GET /metrics, des POST /v1/chat/completions d’un client, des lignes du moteur indiquant 10 requêtes en cours et 0 en attente, et une ligne GET /health, toutes renvoyant 200 OK La sonde du chien de garde, à laquelle répond le moteur
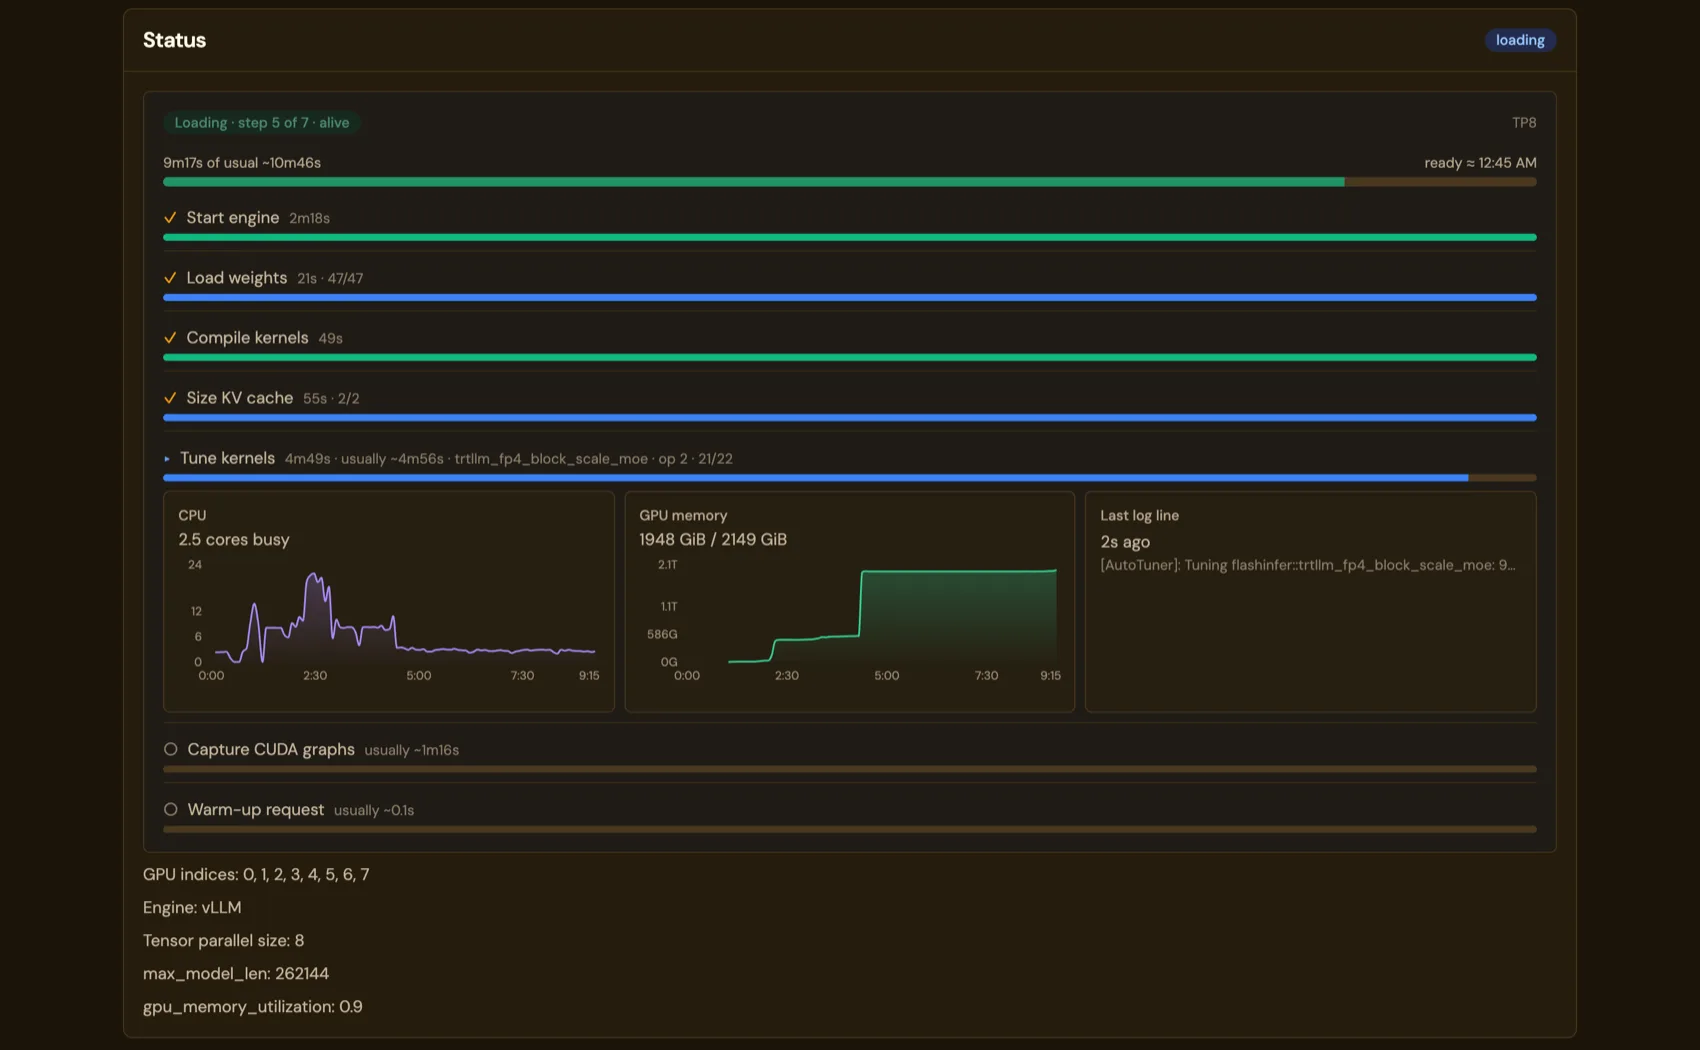
Fig. 15Le journal en direct sur la page d’un modèle pendant la même charge : des collectes de /metrics, des complétions de chat qui arrivent, le décompte établi par le moteur (10 requêtes en cours, aucune en attente) et, entre les deux, une sonde /health. Faites défiler l’image horizontalement pour lire les lignes entières.

Un chargement de 12 minutes se terminait autrefois en erreur.

Un gros modèle peut mettre douze minutes ou plus à charger. Jusqu’ici, le warden appliquait un délai fixe : à l’échéance, il inscrivait une erreur rouge « still loading » sur le modèle, alors que le moteur continuait de charger. La page du modèle affiche désormais chaque étape du chargement avec sa barre de progression, la durée habituelle de chacune d’après les chargements précédents, et les indicateurs CPU et mémoire GPU. Un chargement bloqué est arrêté et ses GPU libérés ; rien ne passe au rouge tant qu’un chargement progresse. GLM-5.2 NVFP4 en parallélisme de tenseurs 8 sur huit NVIDIA B300 se charge en 11 à 12 minutes environ ; un chargement aussi long dépassait auparavant le délai de 600 s.

La page du modèle pendant le chargement de GLM-5.2 NVFP4 sur huit NVIDIA B300 : 9 min 17 s écoulées pour une durée habituelle de 10 min 46 s ; Start engine, Load weights 47 sur 47, Compile kernels et Size KV cache terminées ; Tune kernels à l’op 2, 21 sur 22 ; graphiques CPU et mémoire GPU avec 1 948 sur 2 149 Gio utilisés ; Capture CUDA graphs et Warm-up request encore à venir, chacune avec sa durée habituelle
Fig. 16GLM-5.2 NVFP4 en cours de chargement en parallélisme de tenseurs 8 sur huit B300, au bout de neuf minutes. Le réglage des noyaux est l’étape la plus longue ; les graphiques montrent que le moteur est bien actif alors que le journal ne fait que répéter la progression du réglage.

Une carte de 16 Gio contient moins que ce que le calcul laisse prévoir.

Les poids d’un modèle 8B en bf16 pèsent à eux seuls environ 15 Gio, et le chargement échoue faute de mémoire. Nous avons testé chaque ligne ci-dessous sur des cartes RTX A4000 et Quadro RTX 5000 de 16 Gio, et nous les avons évaluées en lisant les réponses du modèle dans l’espace de chat, sans nous fier à un simple contrôle de santé.

ModèleCe qui fonctionneCe qui ne fonctionne pas
openai/gpt-oss-20bDeux cartes, parallélisme de tenseurs 2, max_model_len 32000, gpu_memory_utilization de 0,7 à 0,9Une carte : le MoE 20B ne tient pas
Llama 3.1 8B, classe Mistral 7BUne carte, avec un checkpoint AWQ-INT4, --enforce-eager et gpu_memory_utilization 0,9Le dépôt bf16 : environ 15 Gio de poids, mémoire insuffisante au chargement
Deux modèles à la foisUn modèle par carte, chacun tenant sur sa propre carteDeux modèles partageant une carte

Vérifié avec vLLM 0.20.0. Les mesures de réplicas ci-dessus utilisaient la 0.26.0. Cette version embarque la 0.32.0 ; le premier chargement chronométré avec elle est celui de GLM-5.2 NVFP4 en parallélisme de tenseurs 8 sur huit B300, en 11 à 12 minutes environ. Les règles de capacité n’ont pas été remesurées sur la 0.32. Le tableau complet et ses justifications se trouvent dans HAZARDS.md. Pas de GPU NVIDIA ? Une bêta existe pour les Mac à puce Apple, Windows sera la prochaine plateforme, et d’autres GPU sont sur la feuille de route.