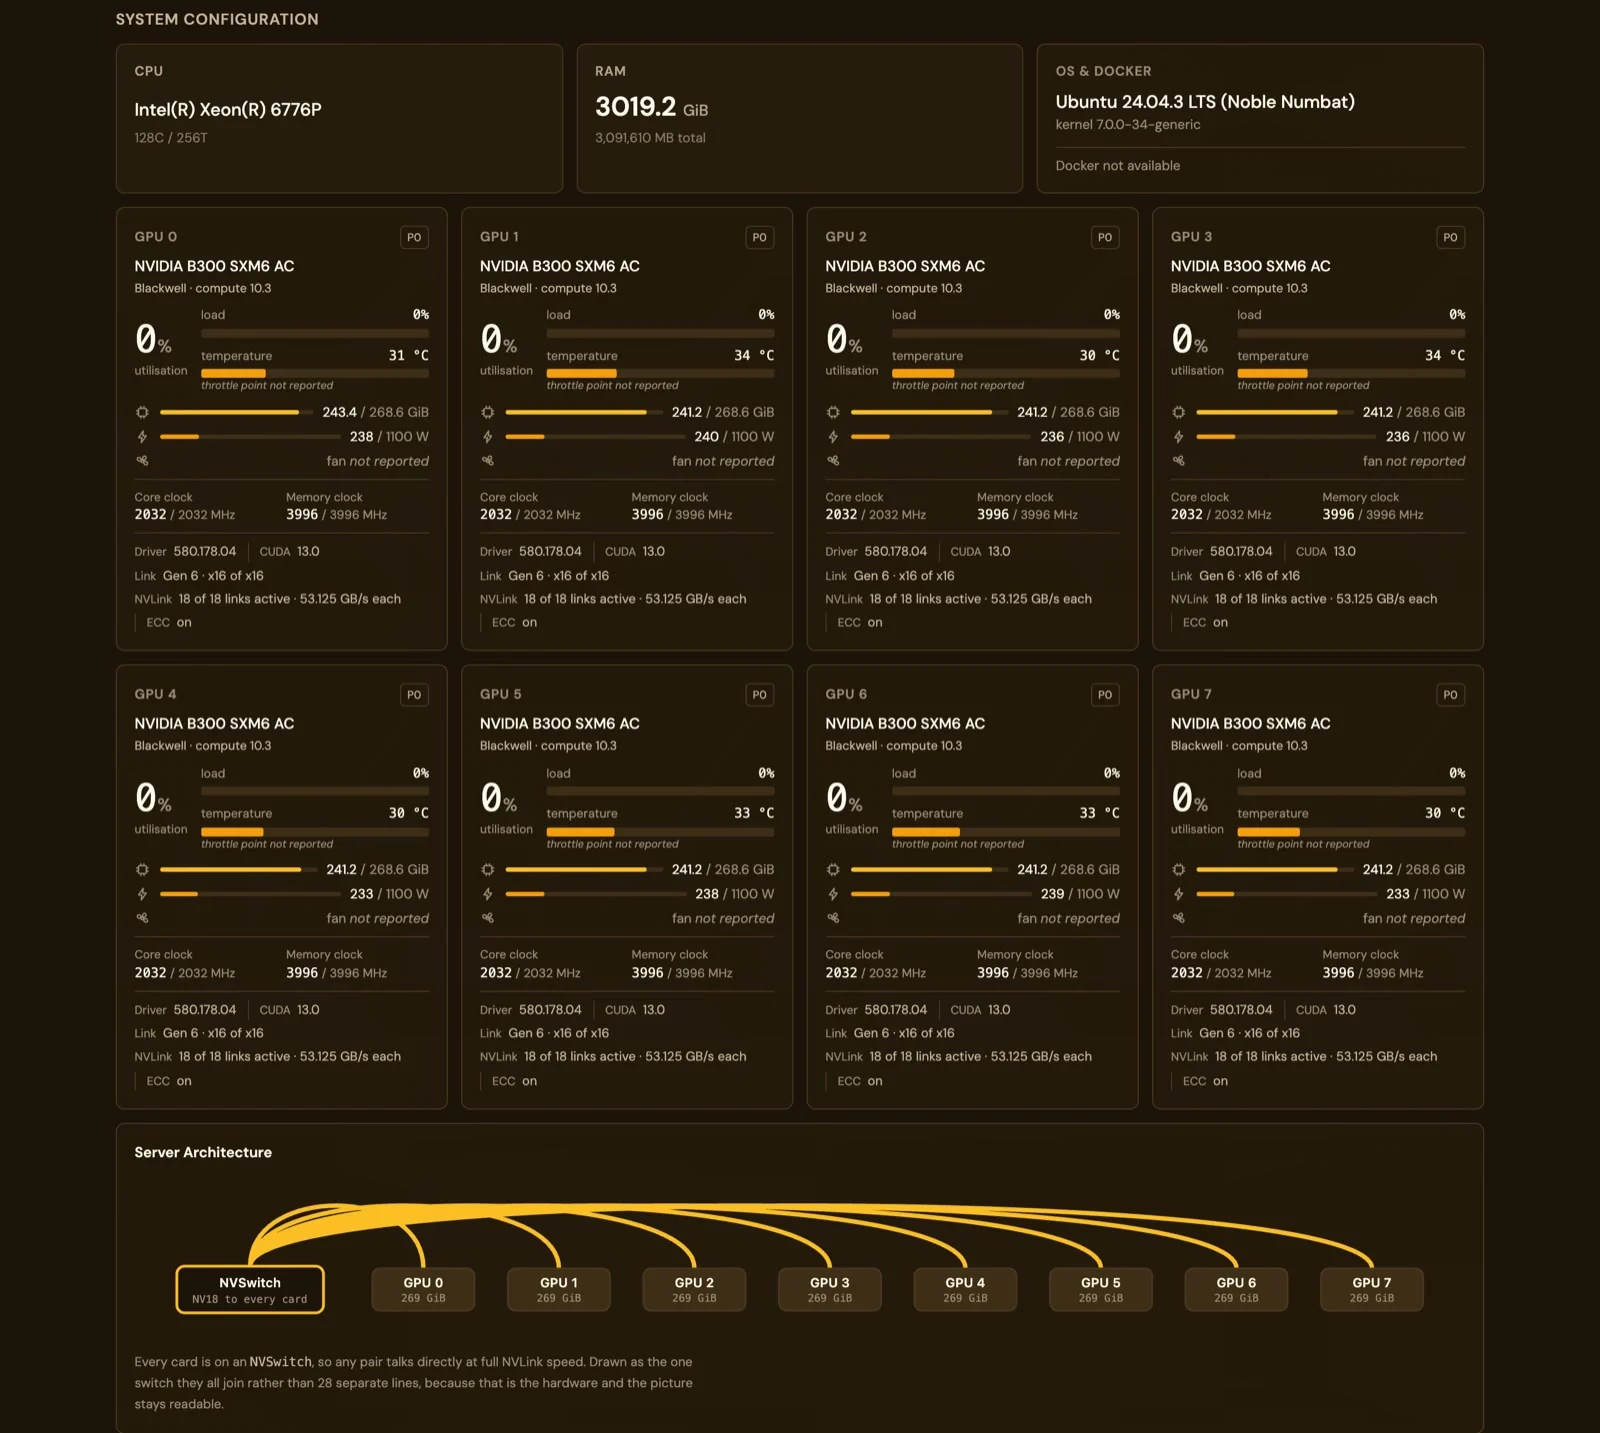
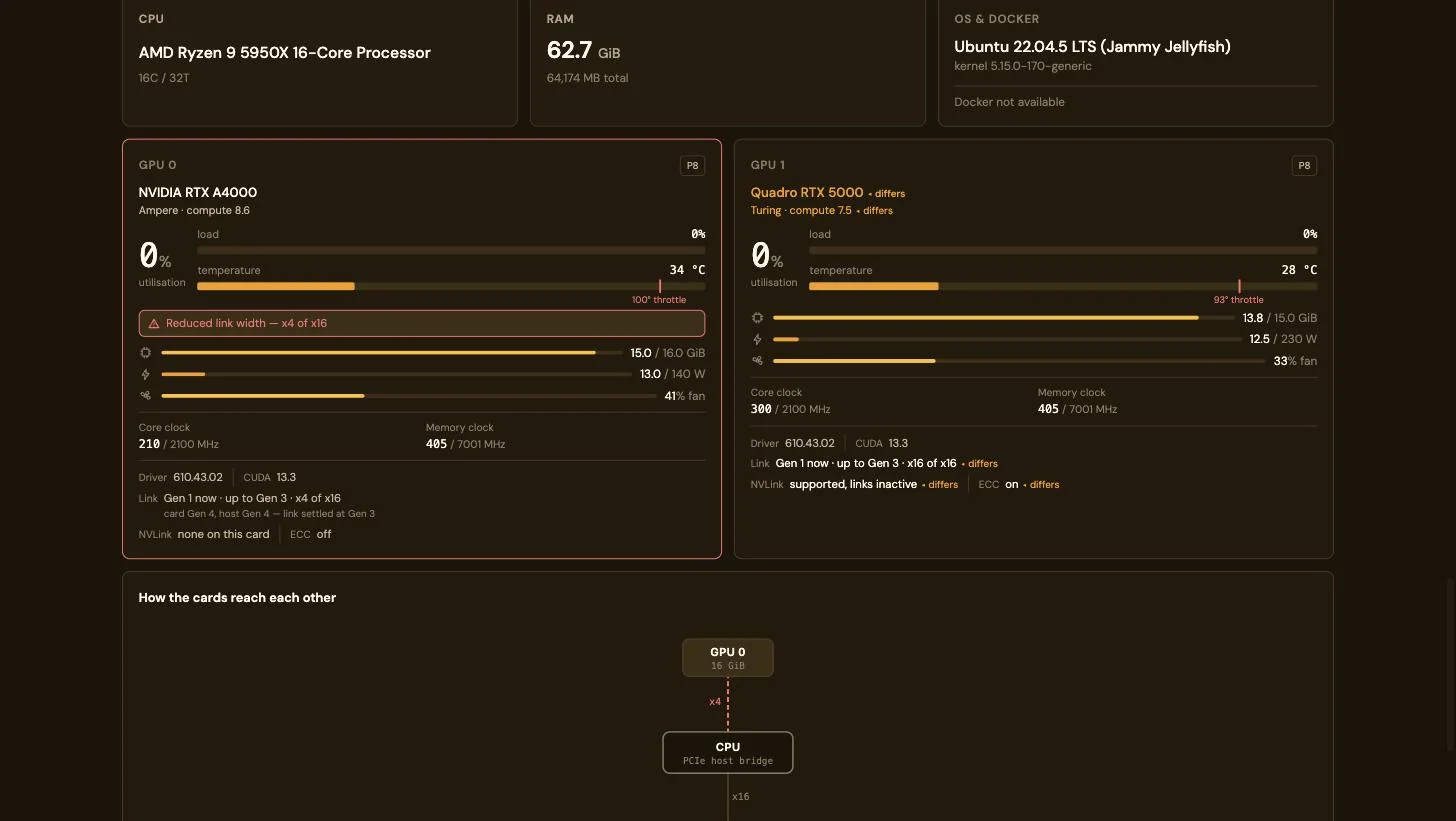
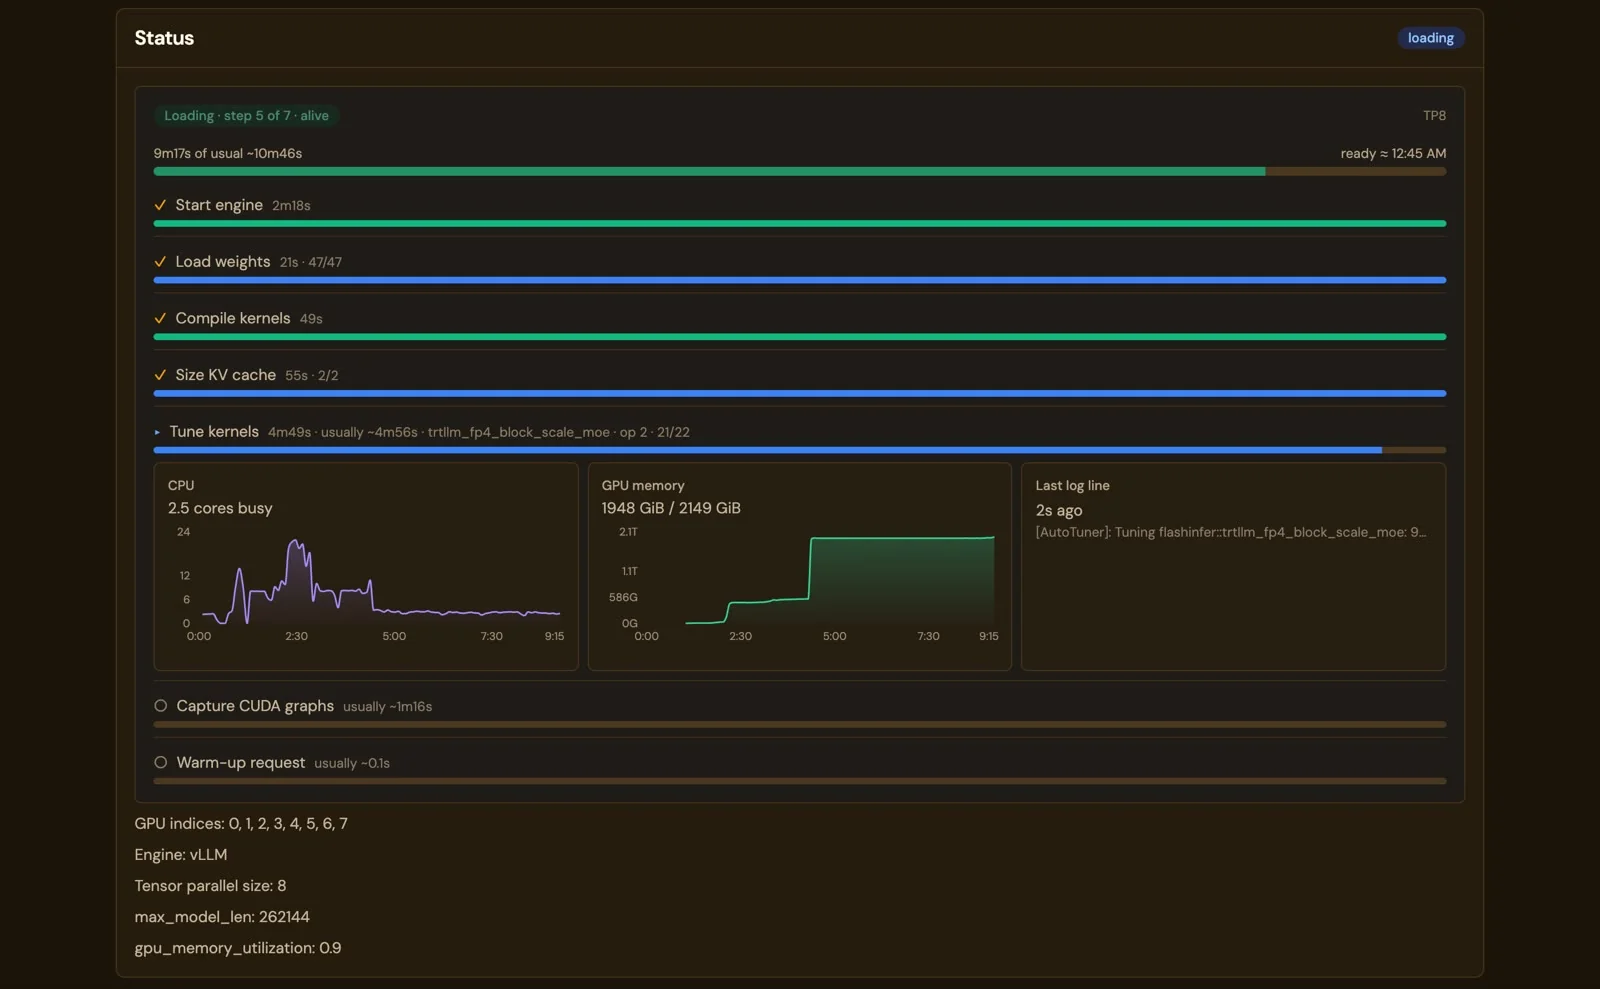
Sie haben GPUs gekauft. Arbeiten sie oder warten sie?
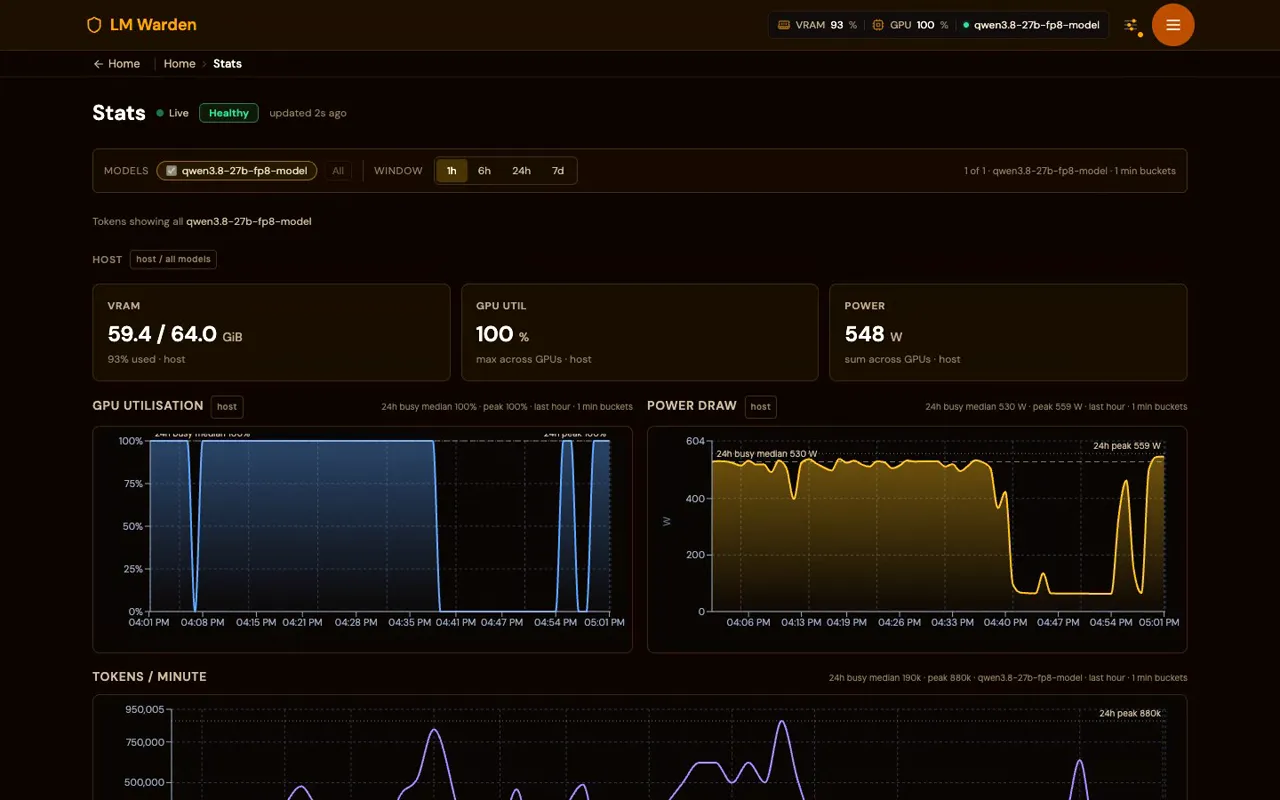
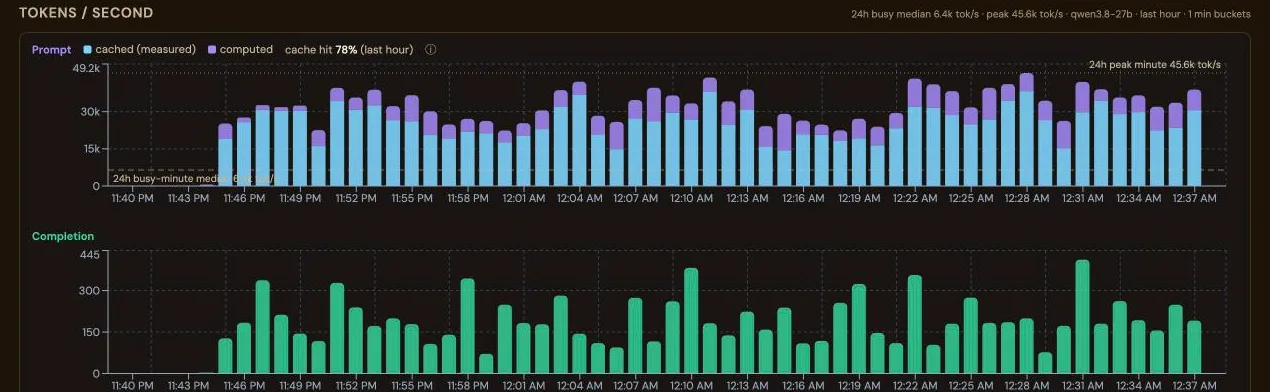
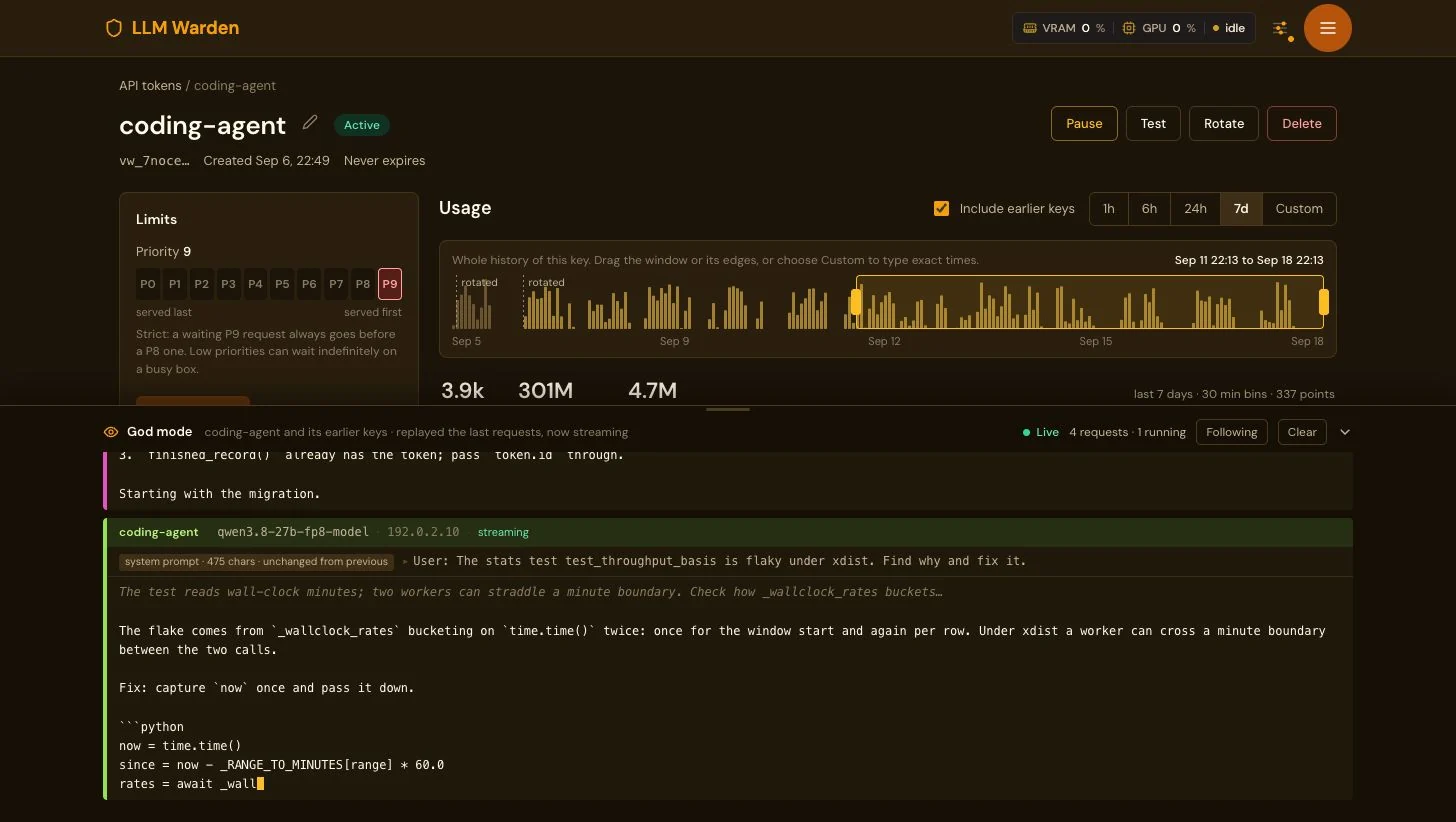
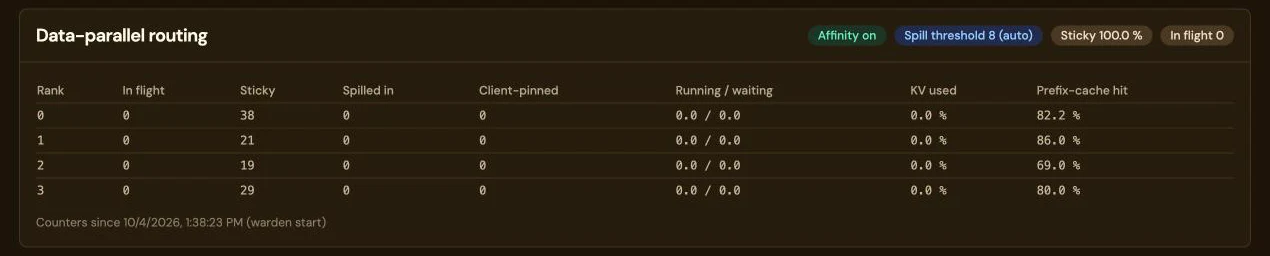
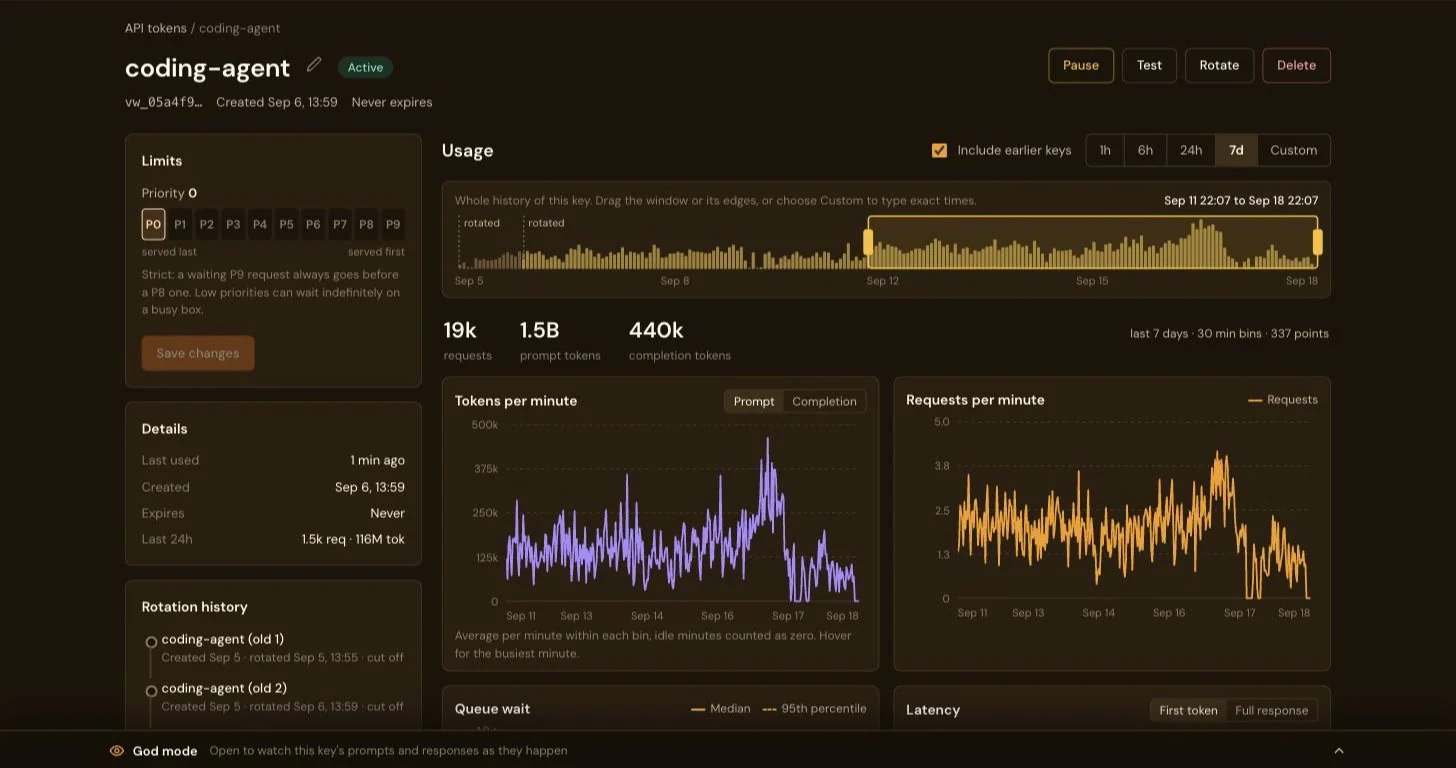
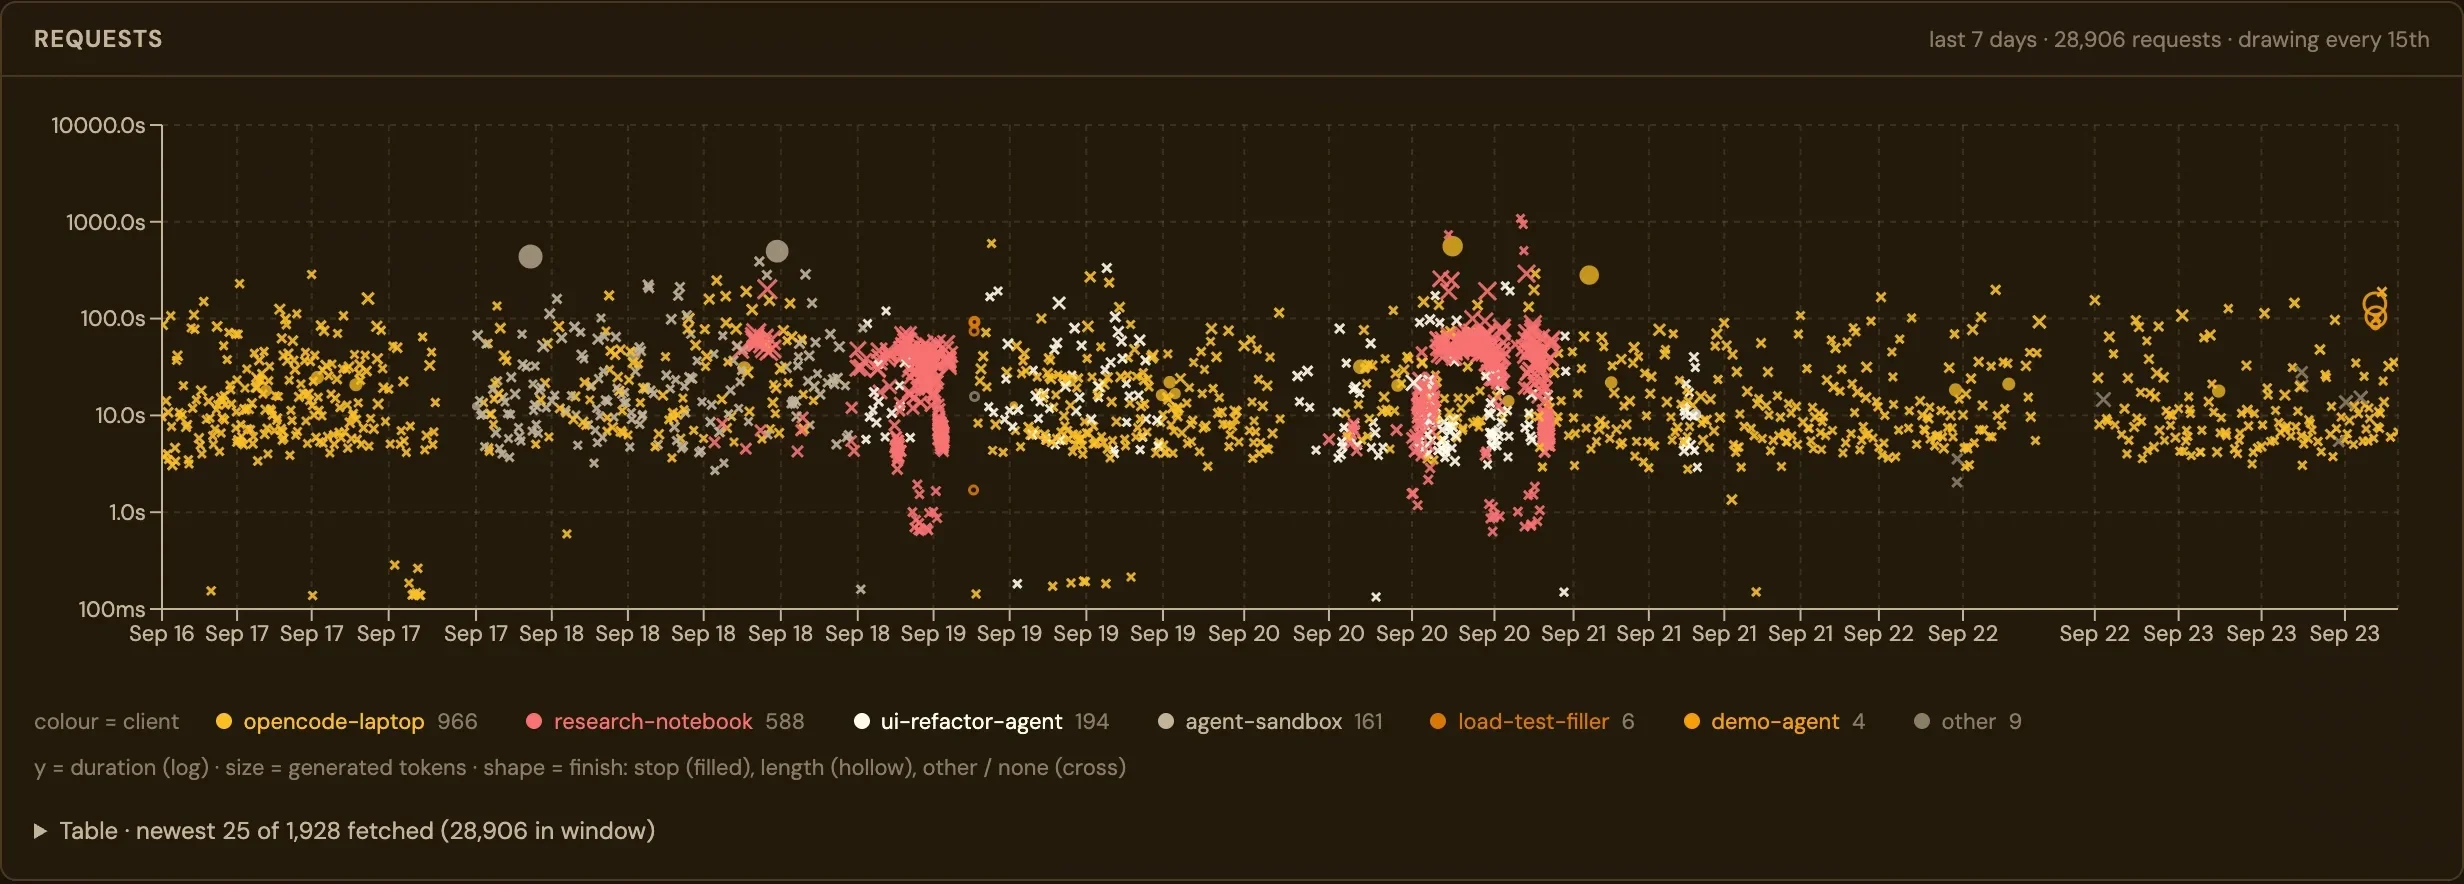
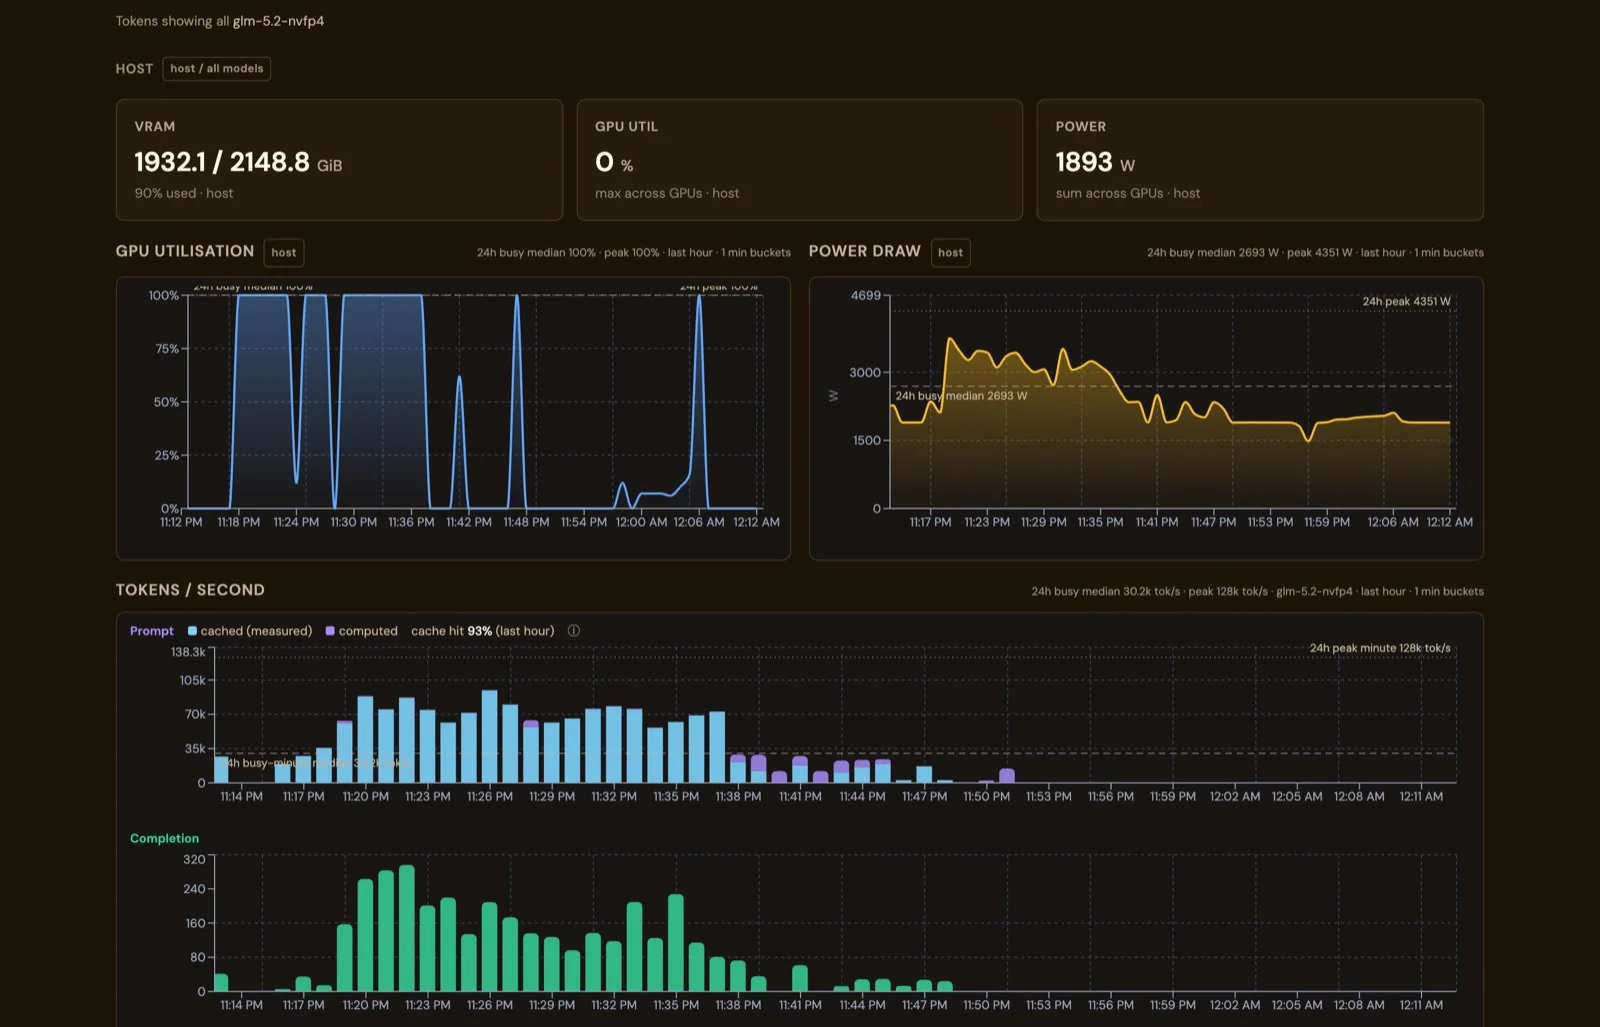
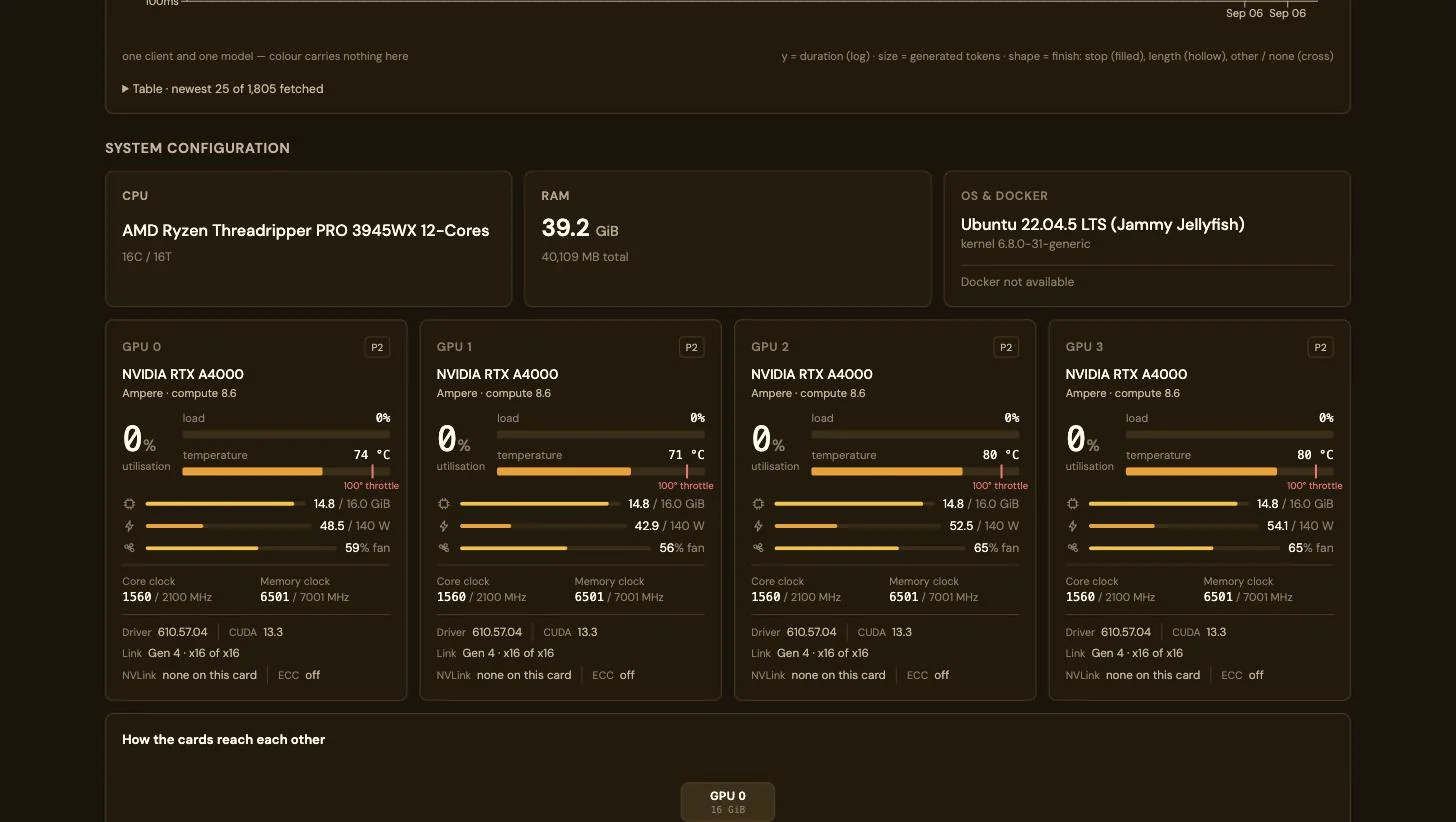
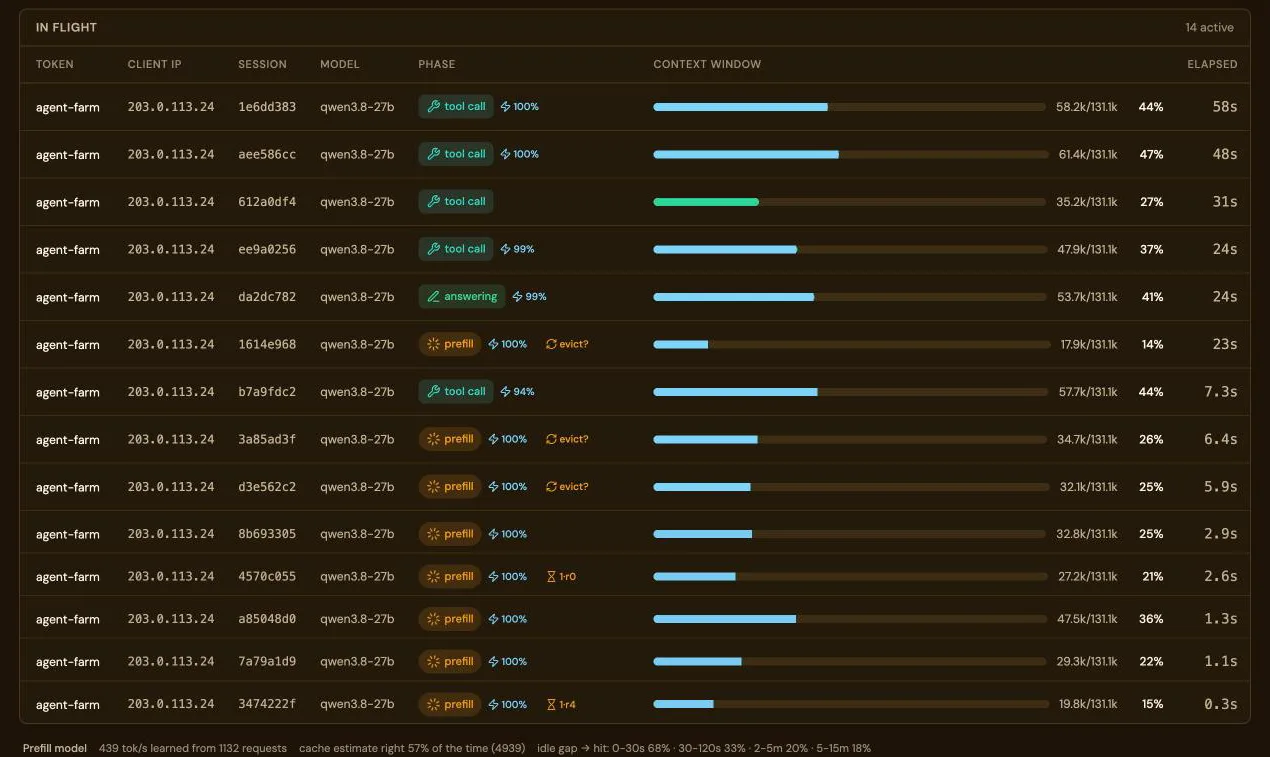
Der Durchsatz ist Parallelität × Prompt-Länge × Cache-Wiederverwendung, und eine Engine allein zeigt nichts davon im Zusammenhang. Die Stats-Seite schon, für Zeiträume von 1 h bis 7 Tagen: VRAM, GPU-Auslastung, Leistungsaufnahme (Linux), Token pro Sekunde mit Prompt-Token aufgeteilt in gecacht und berechnet, Latenz p50/p95, Trefferquote des Prompt-Caches, Preemptions, Anfragen pro Schlüssel und pro Client-IP. Stagniert die Auslastung, während Anfragen warten, erhöhen Sie die Parallelität; ist der Cache-Anteil niedrig, ordnen Sie Sitzungen fest einem Replikat zu.