LM Warden

Дрібниці, які ви знайдете, коли все запрацює.

God mode
Стежте в реальному часі за промптами й відповідями одного ключа на панелі на його сторінці. Дані зберігаються лише в пам’яті, передаються лише поки панель відкрита, а сама функція вимкнена, доки ви не задасте VW_GODMODE_ENABLED.
Токени адміністратора
Токени vwa_ дають змогу скриптам, CI та агентам працювати з API керування без пароля адміністратора, cookie сеансу чи заголовка CSRF. Показуються один раз, зберігаються як хеш SHA-256.
Керування кешем HuggingFace
Що лежить на диску й якій моделі воно належить. Прибирайте осиротілі файли, експортуйте чи імпортуйте весь кеш як tar-архів.
Один порт
Інтерфейс, API керування й /v1 використовують спільний :8080. Ваш власний TLS-термінатор, ingress чи SSO можна поставити перед ним без змін.
Доступ до інтернету не потрібен
Три tar-архіви образів і необов’язковий tar-архів кешу моделей — це все, що треба перенести на хост в ізольованій мережі. HF_HUB_OFFLINE=1 вимикає навіть завантаження ваг.
Статистика Router
Кожне рішення на /router/stats: локально, передано напряму, перенаправлено після збою, відхилено — із причиною, для кожного правила й кожної цілі, а також стан запобіжника. Лічильники ведуться в межах процесу; заголовки й тіла запитів ніколи не зберігаються.
Сторінка налаштування для кожного клієнта
Connect записує налаштування для Claude Code, Codex CLI, OpenCode, Aider, Grok CLI, SDK від Anthropic та OpenAI і трьох редакторів з адресою цього LM Warden, ключем і завантаженою моделлю, а потім надсилає тестовий запит.
Codex CLI
Перевірено з LM Warden 5 жовтня 2026 р. на Codex 0.160: виклики інструмента оболонки, редагування файлу, сеанс утримується на одній репліці. Міркування ввімкнено за замовчуванням; model_reasoning_effort = "none" їх вимикає. Лише локальні моделі: правила маршрутизатора не застосовуються.
Тестовий чат
Поговоріть із завантаженою моделлю в браузері, зокрема із зображеннями, перш ніж давати комусь ключ.

Три речі, яких ми навчилися на власних помилках.

Рушій падав чотири рази за день, а проксі й далі пересилав йому запити.

Ядро рушія vLLM аварійно завершувалося, тоді як обгортка vllm serve довкола нього продовжувала працювати, тож процес здавався живим, і запити й далі надходили до нього. Тепер сторожовий процес опитує власний ендпоінт рушія /health, а не таблицю процесів. Коли рушій перестає відповідати, сторожовий процес зберігає діагностичні дані, зокрема обмежений хвіст журналу, і перезавантажує модель.

Панель журналу моделі в реальному часі під навантаженням: рядки API-сервера vLLM, що відповідають на GET /metrics, POST /v1/chat/completions від клієнта, рядки рушія про 10 запитів у роботі й 0 в очікуванні та один рядок GET /health, усі з відповіддю 200 OK Перевірка сторожового процесу, на яку відповідає рушій
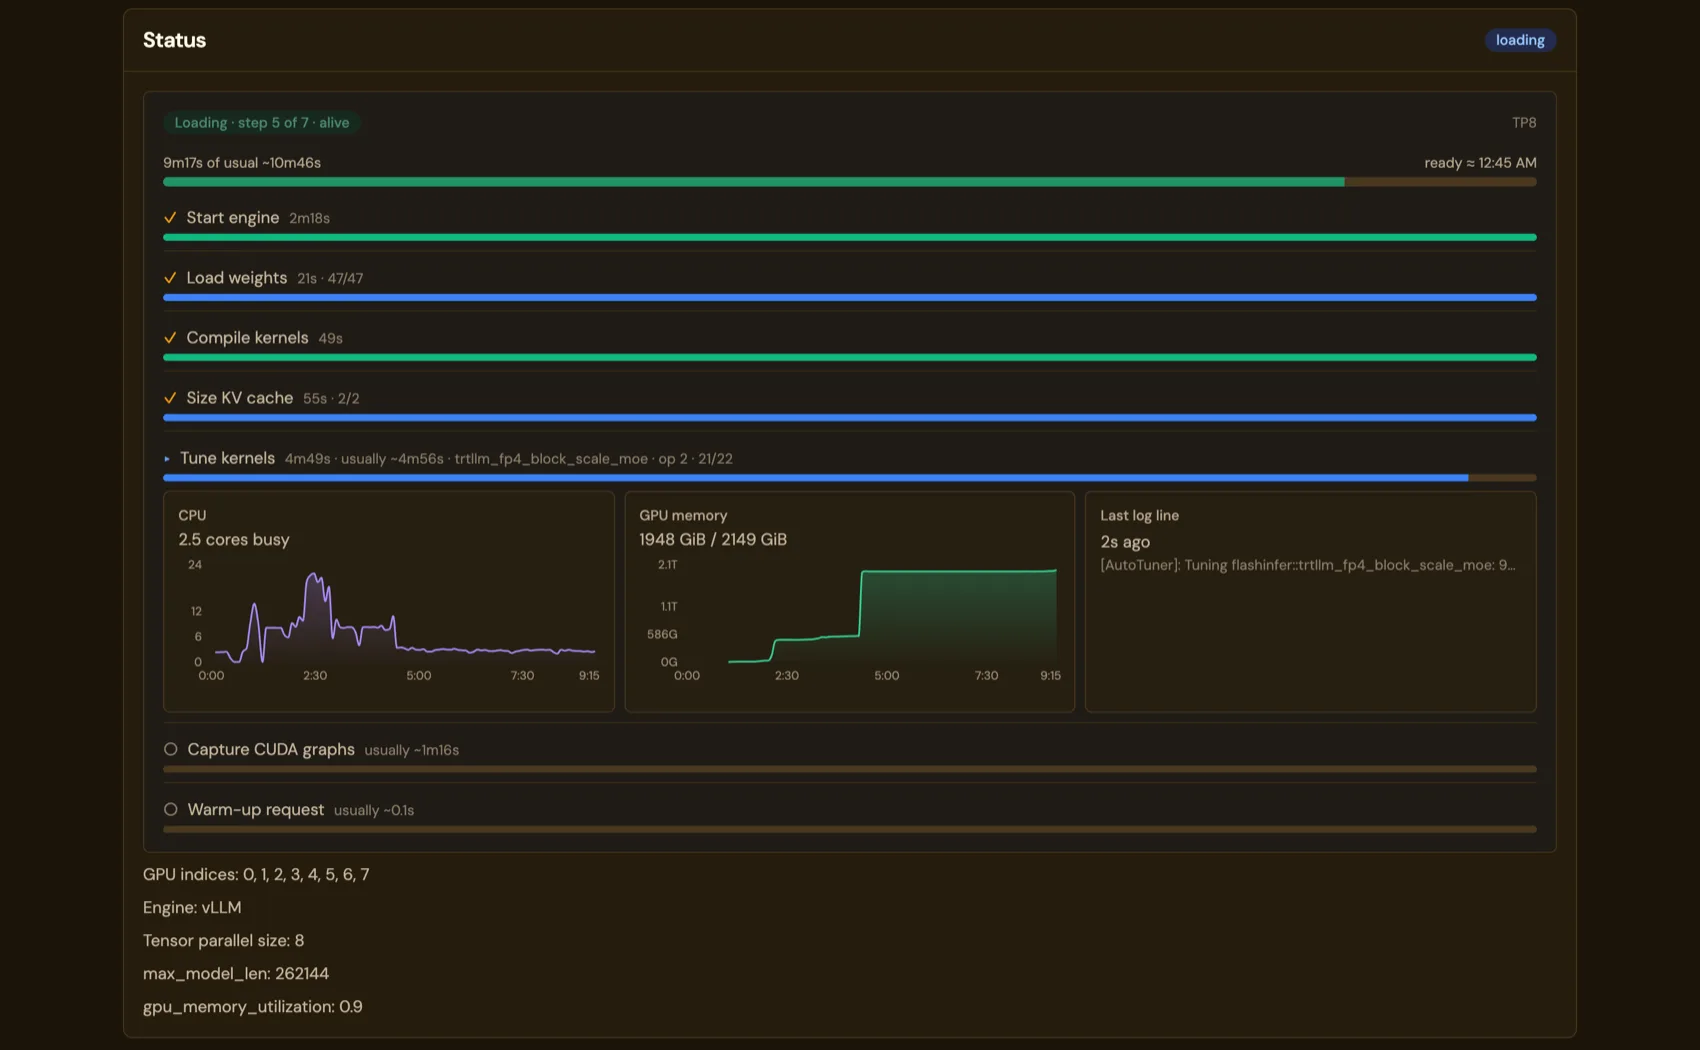
Рис. 15Журнал у реальному часі на сторінці моделі під час того самого навантаження: збирання /metrics, вхідні chat completions, власний лічильник рушія — 10 запитів у роботі й жодного в очікуванні — і одна перевірка /health між ними. Прокрутіть зображення вбік, щоб прочитати рядки повністю.

Завантаження на 12 хвилин раніше закінчувалося помилкою.

Велика модель може завантажуватися дванадцять хвилин і довше. Раніше LM Warden орієнтувався на фіксований таймер: коли час спливав, він записував у модель червону помилку «still loading», хоча рушій продовжував завантаження. Тепер сторінка моделі показує кожен крок завантаження з індикатором перебігу, звичайний час кожного кроку за попередніми завантаженнями та основні показники CPU й пам’яті GPU. Завантаження, що зависло, зупиняється, а його GPU звільняються; поки завантаження просувається, нічого не стає червоним. GLM-5.2 NVFP4 з тензорним паралелізмом 8 на восьми NVIDIA B300 завантажується приблизно за 11–12 хвилин; таке довге завантаження раніше впиралося в тайм-аут 600 с.

Сторінка моделі під час завантаження GLM-5.2 NVFP4 на восьми NVIDIA B300: минуло 9 хв 17 с зі звичайних 10 хв 46 с; Start engine, Load weights 47 з 47, Compile kernels і Size KV cache виконано; Tune kernels на op 2, 21 з 22; графіки CPU й пам’яті GPU, де зайнято 1948 з 2149 ГіБ; Capture CUDA graphs і Warm-up request ще попереду, кожен зі своїм звичайним часом
Рис. 16GLM-5.2 NVFP4 завантажується з тензорним паралелізмом 8 на восьми B300, дев’ята хвилина. Налаштування ядер — найдовший крок; графіки показують, що рушій живий, хоча журнал лише повторює перебіг налаштування.

Карта на 16 ГіБ вміщує менше, ніж каже арифметика.

Самі лише ваги моделі bf16 8B займають близько 15 ГіБ, і під час завантаження їй бракує пам’яті. Ми перевірили кожен рядок нижче на картах RTX A4000 і Quadro RTX 5000 по 16 ГіБ і оцінювали результат, читаючи відповіді моделі в тестовому чаті, а не покладаючись на перевірку стану.

МодельЩо працюєЩо не працює
openai/gpt-oss-20bДві карти, тензорний паралелізм 2, max_model_len 32000, gpu_memory_utilization від 0,7 до 0,9Одна карта: MoE на 20B не вміщається
Llama 3.1 8B, клас Mistral 7BОдна карта, з чекпойнтом AWQ-INT4, --enforce-eager і gpu_memory_utilization 0,9Репозиторій bf16: близько 15 ГіБ ваг, бракує пам’яті під час завантаження
Дві моделі одночасноОдна модель на карту, кожна вміщається на своїй картіДві моделі на одній карті

Перевірено на vLLM 0.20.0. Вимірювання реплік вище виконано на 0.26.0. Цей випуск постачається з 0.32.0; перше заміряне на ньому завантаження — GLM-5.2 NVFP4 з тензорним паралелізмом 8 на восьми B300, приблизно 11–12 хвилин. Правила вміщення на 0.32 повторно не вимірювали. Повна таблиця і причини, що стоять за нею, — у HAZARDS.md. У вас не NVIDIA? Для Apple silicon є бета-версія для Mac, наступною буде Windows, а інші GPU є в планах.