LM Warden

動かし始めると見つかる、細かな機能。

God mode
キーのページにあるドックから、そのキーのプロンプトと応答をリアルタイムで確認できます。メモリ内にだけ保持され、ドックが開いている間だけストリーミングされ、VW_GODMODE_ENABLED を設定しない限りオフです。
管理者トークン
vwa_ トークンを使うと、スクリプト、CI、エージェントが管理者パスワード、Cookie の管理、CSRF ヘッダーなしでコントロール API を操作できます。表示は一度だけで、SHA-256 ハッシュとして保存されます。
HuggingFace キャッシュ マネージャー
ディスク上に何があり、どのモデルのものか。どのモデルにも属さない孤立したファイルを削除し、キャッシュ全体を tarball としてエクスポートまたはインポートできます。
ポートは一つ
UI、コントロール API、/v1 は :8080 を共有します。独自の TLS ターミネーター、Ingress、SSO をそのまま前段に置けます。
外部への経路は不要
エアギャップ環境のホストに運ぶのは、三つのイメージ tarball と、任意のモデル キャッシュ tarball だけです。HF_HUB_OFFLINE=1 で重みのダウンロードも止められます。
Router の統計
すべての判定が /router/stats にあります。ローカル、パススルー、フォールバック、拒否を理由とともに、ルールごと、ターゲットごとに、ブレーカーの状態も含めて。プロセスごとの集計で、ヘッダーや本文は一切含みません。
クライアントごとのセットアップ ページ
Connect は、Claude Code、Codex CLI、OpenCode、Aider、Grok CLI、Anthropic SDK と OpenAI SDK、三つのエディターのセットアップを、この warden のアドレス、キー、読み込み済みのモデルで書き出し、テスト リクエストを送ります。
Codex CLI
2026 年 10 月 5 日に Codex 0.160 で warden に対して実行:シェル ツール呼び出し、ファイルの編集、一つのレプリカに留まるセッション。思考は既定でオンで、model_reasoning_effort = "none" でオフになります。ローカル モデルのみで、ルーターのルールは適用されません。
チャットのプレイグラウンド
キーを誰かに渡す前に、ブラウザーで読み込み済みのモデルと会話できます。画像も使えます。

苦労して学んだ三つのこと。

エンジンが一日に四回落ちても、プロキシはそこへ転送し続けていました。

vLLM のエンジン コアがクラッシュしても、それを包む vllm serve ラッパーは動き続けていたため、プロセスは生きているように見え、リクエストは送られ続けました。現在はウォッチドッグが、プロセス テーブルではなくエンジン自身の /health エンドポイントに問い合わせます。エンジンが応答しなくなると、上限付きのログ末尾を含む証拠を残し、モデルを再読み込みします。

負荷がかかった状態のモデルのライブ ログ パネル:GET /metrics とクライアントからの POST /v1/chat/completions に応答する vLLM API サーバーの行、実行中 10 件、待機中 0 件と報告するエンジンの行、GET /health の行が一つ。すべて 200 OK を返している ウォッチドッグのプローブに、エンジンが応答
図 15同じ負荷の間のモデル ページのライブ ログ:/metrics のスクレイプ、届き続けるチャット補完、実行中 10 件で待機なしというエンジン自身のカウント、その間に一回の /health プローブ。画像を横にスクロールすると行全体が読めます。
12 分かかる読み込みが、以前はエラーで終わっていました。

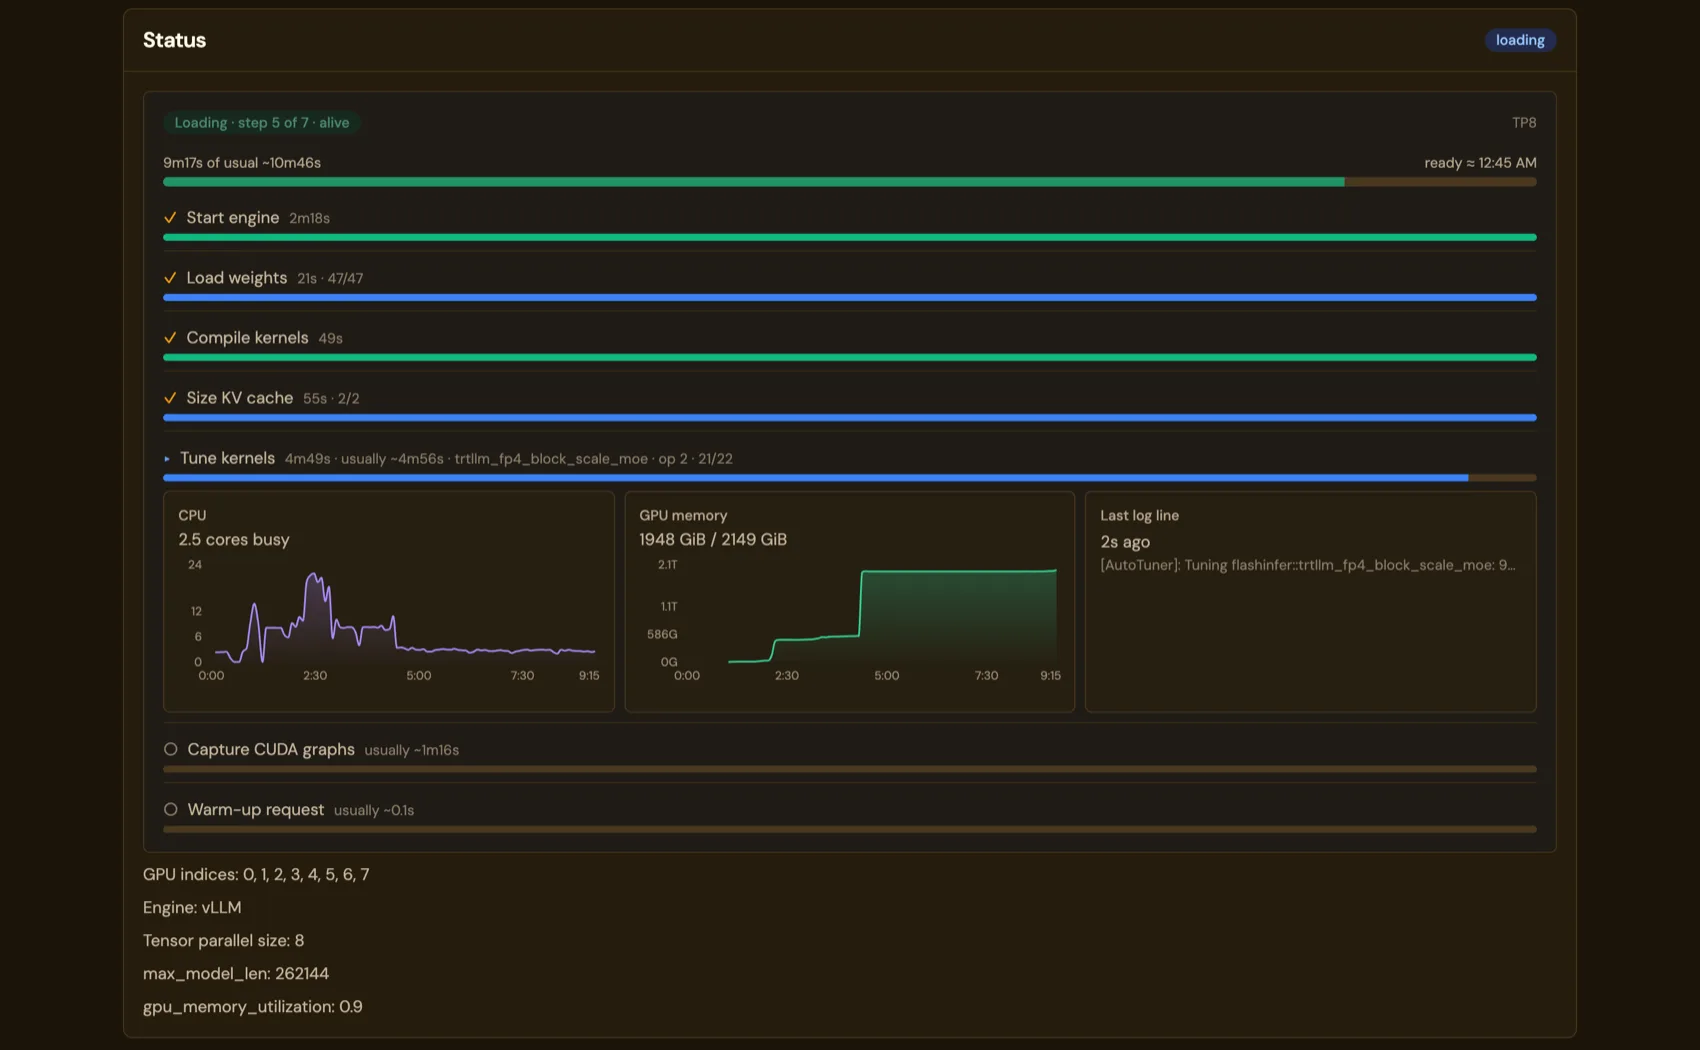
大きなモデルは読み込みに十二分以上かかることがあります。これまで warden は固定のタイムアウトで判断しており、期限が来るとエンジンがまだ読み込み中でもモデルに赤い 「still loading」 エラーを書き込んでいました。現在のモデル ページは、各読み込み手順を進行状況バー、過去の読み込みから得たそれぞれの通常の所要時間、CPU と GPU メモリの稼働状況とともに表示します。停滞した読み込みは停止され、その GPU は解放されます。読み込みが進んでいる間は何も赤くなりません。NVIDIA B300 八基でテンソル並列 8 の GLM-5.2 NVFP4 は約 11~12 分で読み込まれます。これほど長い読み込みは、以前は 600 s のタイムアウトに引っかかっていました。

NVIDIA B300 八基で GLM-5.2 NVFP4 を読み込み中のモデル ページ:通常 10 min 46 s のうち 9 min 17 s 経過。Start engine、Load weights 47 of 47、Compile kernels、Size KV cache は完了。Tune kernels は op 2 (22 中 21) を実行中。CPU と GPU メモリのグラフで 2149 GiB 中 1948 を使用中。Capture CUDA graphs と Warm-up request はこれからで、それぞれに通常の所要時間が付いている
図 16B300 八基でテンソル並列 8 の GLM-5.2 NVFP4 を読み込み中、開始から九分。カーネルのチューニングが長い手順です。ログはチューニングの進行を繰り返すだけですが、グラフはエンジンが生きていることを示しています。

16 GiB のカードに収まるのは、計算上の値より少なくなります。

bf16 8B モデルは重みだけで約 15 GiB あり、読み込み中にメモリが不足します。以下の各行を 16 GiB の RTX A4000 と Quadro RTX 5000 のカードで試し、ヘルス チェックを信用するのではなく、チャットのプレイグラウンドでモデルの回答を読んで判断しました。

モデル動くもの動かないもの
openai/gpt-oss-20bカード二枚、テンソル並列 2、max_model_len 32000、gpu_memory_utilization 0.7 ~ 0.9カード一枚:20B の MoE は収まらない
Llama 3.1 8B、Mistral 7B クラスカード一枚で、AWQ-INT4 チェックポイント、--enforce-eager、gpu_memory_utilization 0.9bf16 のリポジトリ:重みが約 15 GiB で、読み込み中にメモリ不足
二つのモデルを同時にカードごとに一つのモデルで、それぞれが自分のカードに収まる二つのモデルで一枚のカードを共有

vLLM 0.20.0 で確認しました。上記のレプリカの測定には 0.26.0 を使っています。このリリースには 0.32.0 が含まれており、これで最初に計測した読み込みは B300 八基でテンソル並列 8 の GLM-5.2 NVFP4 で、約 11~12 分でした。収まるかどうかのルールは 0.32 ではまだ測り直していません。完全な表とその理由は HAZARDS.md にあります。NVIDIA ではありませんか? Apple シリコンには Mac のベータ版があり、次は Windows、ほかの GPU はロードマップにあります。