GPU मॉनिटरिंग: इन आँकड़ों के पीछे की मशीन।
जब तक कैप्शन में कुछ और न लिखा हो, इस पेज की रीडिंग एक ही वर्कस्टेशन से हैं: चार RTX A4000, जिन सब पर मिलाकर एक ही मॉडल लोड है, और जो हमारे अपने टेस्ट ट्रैफ़िक से व्यस्त हैं। चित्र 1 और चित्र 5 रिकॉर्ड करते समय कंसोल ने यही आँकड़े दिखाए थे। आगे के फ़िट टेस्ट में एक Quadro RTX 5000 भी इस्तेमाल हुआ, और वहाँ यह लिखा है।
हर कार्ड के पैनल NVIDIA का ड्राइवर पढ़ते हैं, इसलिए वे Linux इंस्टॉल का हिस्सा हैं। Apple silicon वाले Mac पर Mac ऐप (बीटा) GPU उपयोग और Metal द्वारा बताया गया मेमोरी बजट दिखाता है, पावर रीडिंग के बिना।
- GPU
- 4 × NVIDIA RTX A4000, हर एक 16 GiB (Ampere, compute 8.6)
- इस्तेमाल में VRAM
- 64.0 GiB में से 59.4, एक मॉडल चारों कार्ड पर
- PCIe
- हर कार्ड पर Gen 4 x16
- ड्राइवर
610.57.04, CUDA 13.3
| रीडिंग | कैप्चर के समय | 24 h का मीडियन (व्यस्त समय) | 24 h शिखर |
|---|---|---|---|
| GPU उपयोग, सबसे व्यस्त कार्ड (%) | 100 | 100 | 100 |
| GPU पावर, चारों कार्ड का जोड़ (W) | 548 | 530 | 559 |
| प्रति मिनट टोकन (23 सितंबर का पैनल) | नहीं दिखाया गया | 190k | 880k |
आपके आँकड़े अलग होंगे, और इसीलिए उन्हें मापना ज़रूरी है। टोकन वाली पंक्ति उस समय की है जब पैनल प्रति सेकंड टोकन पर नहीं गया था; Stats पैनल अब प्रति सेकंड टोकन दिखाता है, और ये आँकड़े 23 सितंबर को पुराने प्रति-मिनट पैनल से लिए गए थे।
जो आँकड़ा मापा नहीं जा सकता, वहाँ “not reported” लिखा दिखता है।
ज़्यादातर GPU डैशबोर्ड चार कार्ड का औसत निकालकर एक ही रेखा दिखाते हैं और गायब मान को 0 बना देते हैं। यह कंसोल हर कार्ड को अपना पैनल देता है: ड्राइवर के बताए थ्रॉटल पॉइंट के मुक़ाबले तापमान, कार्ड की अपनी पावर सीमा के मुक़ाबले पावर, क्लॉक, फ़ैन, इस समय तय हुआ PCIe लिंक, और कार्ड में हों तो ECC और NVLink। अठारह महीने के अंतर पर ख़रीदे गए दो कार्ड अलग-अलग ही दिखते हैं, और जो मान ड्राइवर नहीं देता, उसे शून्य दिखाने के बजाय गायब बताया जाता है।
 थ्रॉटल पॉइंट ड्राइवर से, अंदाज़ा नहीं
क्लॉक क्यों कम है, जैसा ड्राइवर बताता है
अपनी 140 W सीमा के सामने पावर
NVLink और ECC, जैसा कार्ड बताता है
| हर कार्ड | तापमान और थ्रॉटल पॉइंट, पावर और उसकी सीमा, कोर और मेमोरी क्लॉक, पंखा, PCIe पीढ़ी और चौड़ाई, ECC, NVLink, और कार्ड इस्तेमाल करने वाला इंजन प्रोसेस |
|---|---|
| हर होस्ट | इस्तेमाल में VRAM, GPU उपयोग (सबसे व्यस्त कार्ड), पावर (कार्ड का जोड़) और प्रति सेकंड टोकन |
| हर अनुरोध | पहले टोकन तक का समय, टोकन के बीच की लेटेंसी और कुल अवधि; तीनों दोनों इंजनों के लिए प्रॉक्सी पर एक ही तरीक़े से मापे जाते हैं |
हर अनुरोध किसका इंतज़ार कर रहा है।
Stats पेज चल रहे हर अनुरोध को क्लाइंट के सेशन के साथ दिखाता है, और यह भी कि अनुरोध किस चरण में है: warden की क़तार में, प्रीफ़िल (इंजन प्रॉम्प्ट पढ़ रहा है), सोच रहा है, टूल कॉल लिख रहा है, या जवाब दे रहा है। एक बैज बताता है कि प्रॉम्प्ट का कितना हिस्सा शायद रेप्लिका के कैश में है। अगर कोई प्रीफ़िल इस मशीन की सीखी हुई प्रीफ़िल दर के अनुमान से ज़्यादा समय लेता है, तो पेज बताता है कि वह शायद क्यों रुका है: उसी रेप्लिका पर दूसरे प्रॉम्प्ट उससे आगे हैं, कैश शायद हटा दिया गया है, या वह धीमा है पर warden को कोई वजह नहीं दिखती। सेशन उस ID से पहचाना जाता है जो हर टूल पहले से भेजता है: Claude Code, Codex, OpenCode और pi में बिना किसी सेटअप के, Hermes और Aider में एक पंक्ति के सेटअप से।
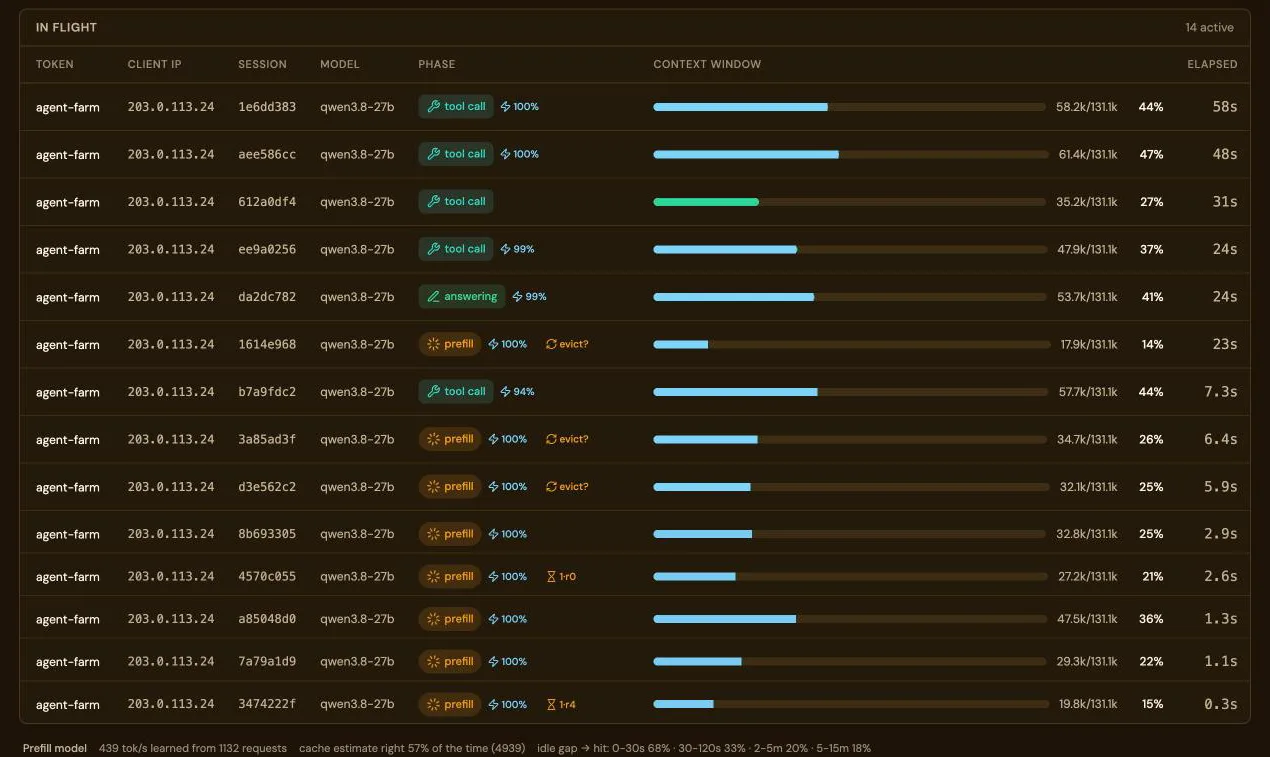 अभी कोई टोकन नहीं, कैश शायद हटा दिया गया
रेप्लिका 4 पर इससे आगे एक प्रॉम्प्ट