LM Warden

用起来之后,你还会发现这些小功能。

God mode
在某个密钥页面的停靠面板中,实时查看该密钥的提示词和回复。只保存在内存中,只在停靠面板打开时流式传输,除非你设置 VW_GODMODE_ENABLED,否则处于关闭状态。
管理员令牌
vwa_ 令牌让脚本、CI 和智能体无需管理员密码、Cookie 存储或 CSRF 标头即可调用控制 API。只显示一次,以 SHA-256 哈希存储。
HuggingFace 缓存管理器
磁盘上有哪些文件,分别属于哪个模型。可清理无主文件,并把整个缓存打包成 tarball 导出或导入。
一个端口
UI、控制 API 和 /v1 共享 :8080。你自己的 TLS 终结器、Ingress 或 SSO 可以原样放在它前面。
无需对外路由
对于物理隔离的主机,三个镜像 tarball 加上一个可选的模型缓存 tarball 就是需要传入的全部内容。HF_HUB_OFFLINE=1 甚至可以禁止下载权重。
Router 统计
/router/stats 记录每一个路由决策:本地、直通、回退、拒绝,附带原因,按规则和按目标分别统计,并给出熔断器状态。按进程统计,从不记录标头或正文。
每个客户端一个设置页面
Connect 为 Claude Code、Codex CLI、OpenCode、Aider、Grok CLI、Anthropic 和 OpenAI SDK 以及三款编辑器写好设置,填入这个 warden 的地址、一个密钥和一个已加载的模型,并发送一个测试请求。
Codex CLI
2026 年 10 月 5 日用 Codex 0.160 对一个 warden 实测:shell 工具调用、一次文件编辑,会话始终保持在同一个副本上。思考默认开启;model_reasoning_effort = "none" 可将其关闭。仅限本地模型:路由器规则不适用。
聊天试验场
在把密钥交给任何人之前,先在浏览器中与已加载的模型对话,包括图片在内。

我们吃过苦头才学到的三件事。

引擎一天内崩溃了四次,而代理服务还在继续向它转发请求。

vLLM 引擎核心崩溃了,而包裹它的 vllm serve 进程仍在运行,因此进程看起来还活着,请求也继续发给它。现在由一个看门狗询问引擎自己的 /health 端点,而不是查看进程表。当引擎不再应答时,看门狗会保留证据(包括有限长度的日志末尾),并重新加载模型。

负载下模型的实时日志面板:vLLM API 服务器行在响应 GET /metrics 和来自客户端的 POST /v1/chat/completions,引擎行报告 10 个请求正在运行、0 个在等待,还有一行 GET /health,全部返回 200 OK 看门狗的探测,由引擎应答
图 15同一负载期间模型页面上的实时日志:对 /metrics 的抓取、不断进来的聊天补全、引擎自己统计的 10 个请求正在运行且没有等待,以及其间的一次 /health 探测。左右滚动图片可阅读完整的行。
一次 12 分钟的加载过去会以错误告终。

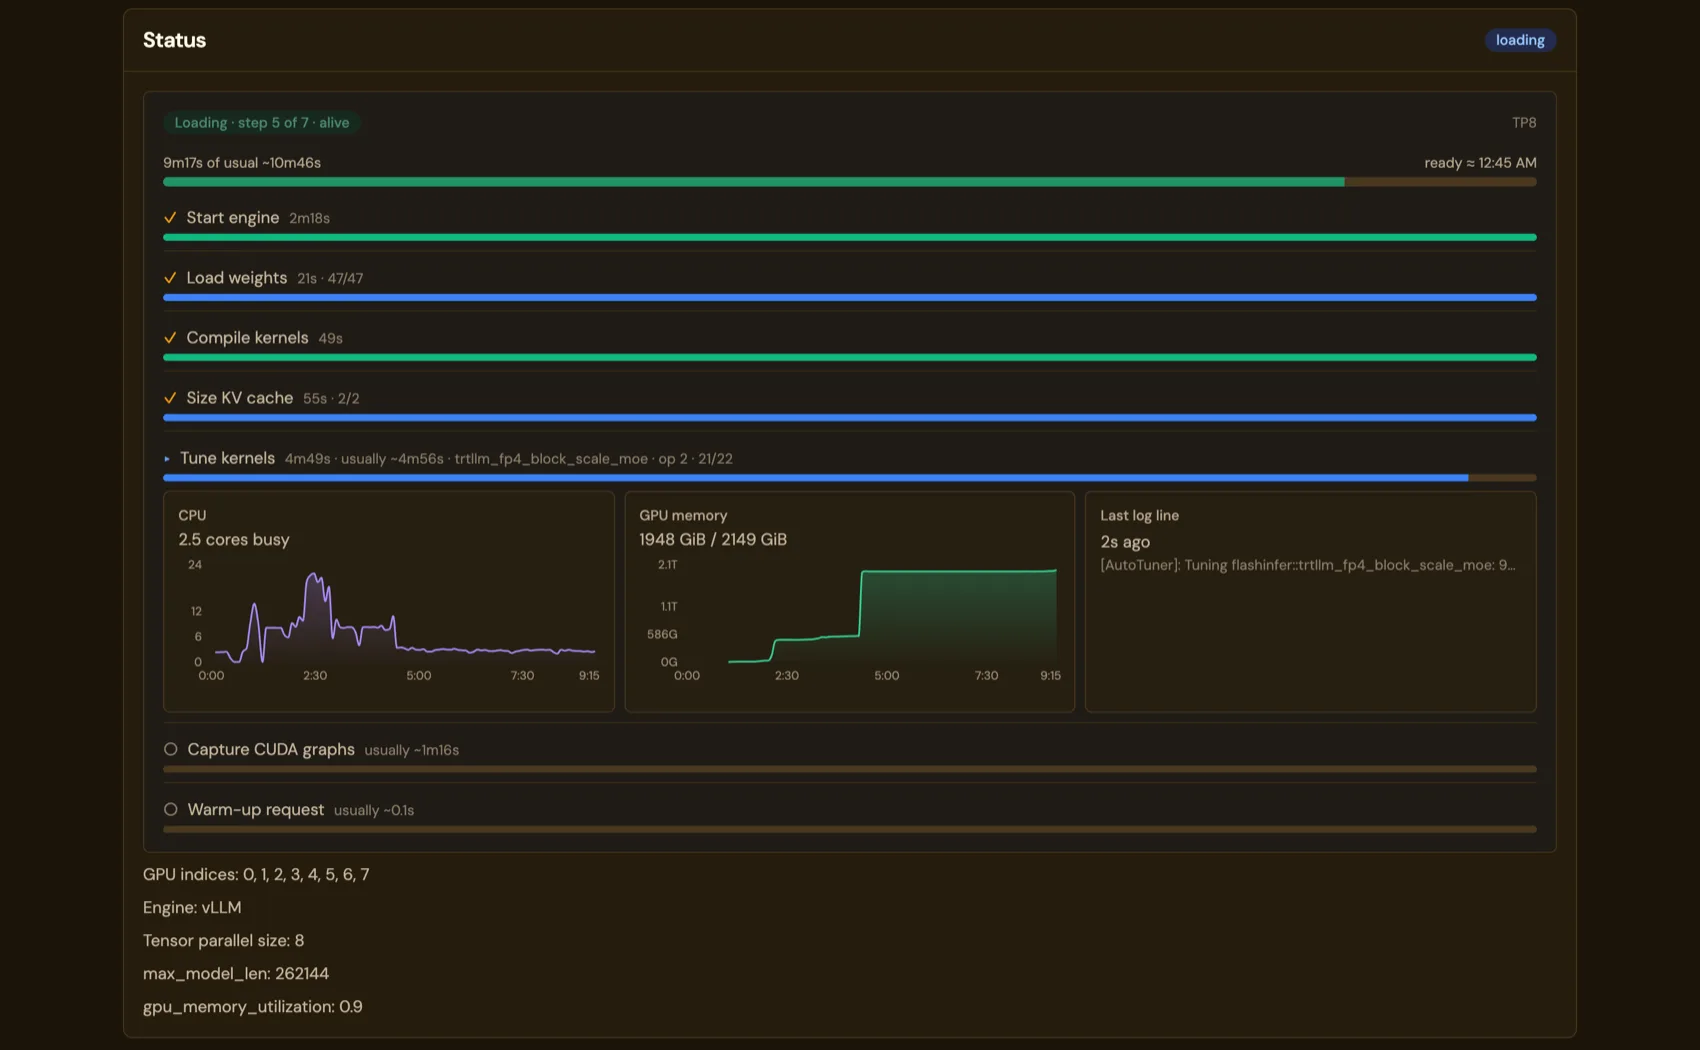
大模型可能需要十二分钟甚至更久才能加载完。过去 warden 只看一个固定的计时:到了截止时间,它会给模型写入一个红色的“still loading”错误,尽管引擎仍在加载。现在模型页面会显示每个加载步骤及其进度条、根据以往加载得出的每一步通常耗时,以及 CPU 和 GPU 内存的实时状态。停滞的加载会被停止,其 GPU 会被释放;只要加载还在推进,就不会有任何东西变红。GLM-5.2 NVFP4 以张量并行 8 在八块 NVIDIA B300 上加载约需 11 到 12 分钟;这么长的加载过去会触发 600 s 的超时。

GLM-5.2 NVFP4 在八块 NVIDIA B300 上加载时的模型页面:通常需要 10 min 46 s,已进行 9 min 17 s;Start engine、Load weights 47/47、Compile kernels 和 Size KV cache 已完成;Tune kernels 在 op 2,21/22;CPU 和 GPU 内存图表显示已用 1948/2149 GiB;Capture CUDA graphs 和 Warm-up request 尚未开始,每一步都标有通常耗时
图 16GLM-5.2 NVFP4 以张量并行 8 在八块 B300 上加载,已进行九分钟。内核调优是耗时最长的一步;日志只是重复调优进度,而图表显示引擎还活着。

一块 16 GiB 的显卡实际能装下的,比算出来的少。

一个 bf16 8B 模型光权重就约有 15 GiB,在这样的显卡上加载时会耗尽显存。我们在 16 GiB 的 RTX A4000 和 Quadro RTX 5000 显卡上逐一尝试了下面每一行,判断依据是在聊天试验场中阅读模型的回答,而不是相信健康检查。

模型可行的配置不可行的配置
openai/gpt-oss-20b两块显卡,张量并行 2,max_model_len 32000,gpu_memory_utilization 0.7 到 0.9一块显卡:20B MoE 放不下
Llama 3.1 8B、Mistral 7B 级别一块显卡,使用 AWQ-INT4 检查点、--enforce-eager 和 gpu_memory_utilization 0.9bf16 仓库:权重约 15 GiB,加载时显存不足
同时运行两个模型每块显卡一个模型,且各自都能放进所在的显卡两个模型共享一块显卡

基于 vLLM 0.20.0 验证。上文的副本测量使用的是 0.26.0。本版本附带 0.32.0;在该版本上首次计时的加载是 GLM-5.2 NVFP4 以张量并行 8 在八块 B300 上加载,约需 11 到 12 分钟。适配规则尚未在 0.32 上重新测量。完整的表格及其背后的原因见 HAZARDS.md。不用 NVIDIA?Apple 芯片有 Mac 测试版,下一个是 Windows,其他 GPU 已列入路线图。