Monitoramento de GPU: a máquina por trás destes números.
Salvo indicação em contrário na legenda, as leituras desta página vêm de uma única workstation: quatro RTX A4000, com um único modelo carregado em todas elas, ocupadas com o nosso próprio tráfego de teste. Estes são os números que o console mostrava enquanto gravávamos as figs. 1 e 5. Os testes de compatibilidade mais abaixo também usaram uma Quadro RTX 5000, o que está indicado neles.
Os painéis por placa leem o driver da NVIDIA, então fazem parte da instalação Linux. Em um Mac com chip Apple, o app para Mac (beta) mostra o uso da GPU e a memória disponível que o Metal informa, sem leitura de potência.
- GPUs
- 4 × NVIDIA RTX A4000, 16 GiB cada (Ampere, compute 8.6)
- VRAM em uso
- 59,4 de 64,0 GiB, um modelo nas quatro placas
- PCIe
- Gen 4 x16 por placa
- Driver
610.57.04, CUDA 13.3
| Leitura | Na captura | Mediana em carga, 24 h | Pico em 24 h |
|---|---|---|---|
| Utilização da GPU, placa mais ocupada (%) | 100 | 100 | 100 |
| Potência da GPU, soma das quatro placas (W) | 548 | 530 | 559 |
| Tokens por minuto (painel de 23 de set.) | não exibido | 190 mil | 880 mil |
Os seus números vão ser diferentes. É para isso que serve medi-los. A linha de tokens é anterior à mudança para tokens por segundo; o painel de estatísticas agora mostra tokens por segundo, e estes números são da captura de 23 de setembro no painel antigo, por minuto.
Um número que ele não consegue medir aparece como “not reported”.
A maioria dos painéis de GPU faz a média de quatro placas em uma linha só e desenha um valor ausente como 0. Este dá a cada placa o seu próprio painel: a temperatura em relação ao ponto de throttling que o driver informa, a potência em relação ao limite da própria placa, clocks, ventoinha, o link PCIe como está negociado agora, e ECC e NVLink quando a placa os tem. Duas placas compradas com dezoito meses de diferença continuam sendo duas placas, e um valor que o driver não fornece é marcado como ausente em vez de desenhado como zero.
 Ponto de throttling vindo do driver, não um palpite
Por que o clock caiu, como o driver informa
Potência em relação ao próprio limite de 140 W
NVLink e ECC, como a placa os informa
| Por placa | Temperatura e ponto de throttling, potência e o seu limite, clocks do núcleo e da memória, ventoinha, geração e largura PCIe, ECC, NVLink e o processo do mecanismo que usa a placa |
|---|---|
| Por host | VRAM em uso, utilização da GPU (a placa mais ocupada), potência (a soma das placas) e tokens por segundo |
| Por solicitação | Tempo até o primeiro token, latência entre tokens e duração, medidos no proxy da mesma forma para os dois mecanismos |
O que cada solicitação está esperando.
A página Stats lista cada solicitação em andamento com a sessão do cliente e a etapa em que ela está: na fila do warden, em prefill (o mecanismo lendo o prompt), pensando, escrevendo uma chamada de ferramenta ou respondendo. Um selo mostra a parcela do prompt que provavelmente está no cache da réplica. Quando um prefill demora mais do que o previsto pela taxa de prefill que o warden aprendeu nesta máquina, a página indica o motivo provável da espera: outros prompts na frente, na mesma réplica; um cache que provavelmente foi descartado; ou lentidão sem causa que o warden consiga identificar. A sessão vem do id que cada ferramenta já envia: Claude Code, Codex, OpenCode e pi sem configuração extra; Hermes e Aider com uma linha de configuração.
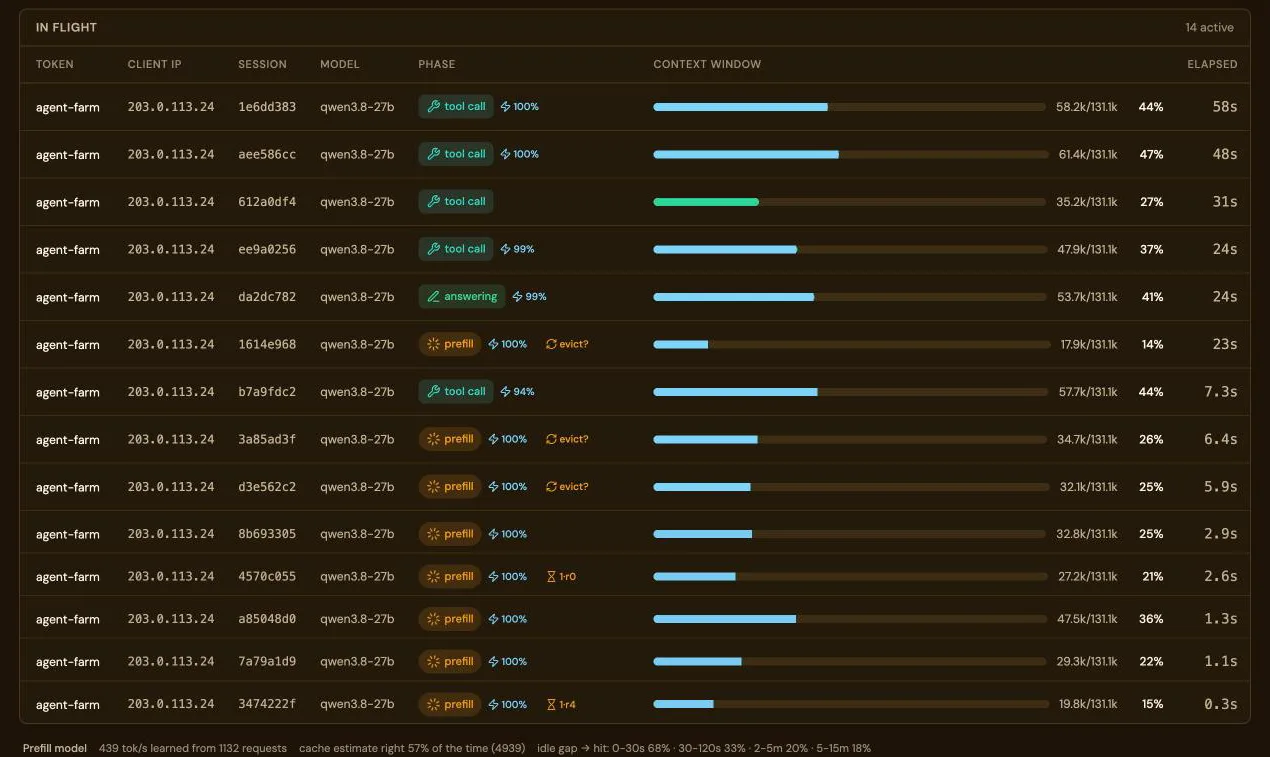 Nenhum token ainda, cache provavelmente descartado
Um prompt à frente dele na réplica 4