Monitorowanie GPU: serwer, z którego pochodzą te liczby.
O ile podpis nie mówi inaczej, odczyty na tej stronie pochodzą z jednej stacji roboczej: czterech kart RTX A4000 z jednym modelem załadowanym na wszystkie, zajętych naszym własnym ruchem testowym. Te liczby pokazywała konsola, gdy wykonywaliśmy zrzuty do rys. 1 i 5. Testy dopasowania niżej używały też karty Quadro RTX 5000, o czym tam mowa.
Panele poszczególnych kart odczytują sterownik NVIDIA, więc są częścią instalacji dla systemu Linux. Na Macu z procesorem Apple aplikacja na Maca (beta) pokazuje wykorzystanie GPU i budżet pamięci zgłaszany przez Metal, bez odczytu mocy.
- Karty GPU
- 4 × NVIDIA RTX A4000, każda 16 GiB (Ampere, compute 8.6)
- Użycie VRAM
- 59,4 z 64,0 GiB, jeden model na wszystkich czterech kartach
- PCIe
- Gen 4 x16 na kartę
- Sterownik
610.57.04, CUDA 13.3
| Odczyt | W chwili zrzutu | Mediana pod obciążeniem, 24 h | Szczyt w 24 h |
|---|---|---|---|
| Wykorzystanie GPU, najbardziej obciążona karta (%) | 100 | 100 | 100 |
| Moc GPU, suma czterech kart (W) | 548 | 530 | 559 |
| Tokeny na minutę (panel z 23 wrz.) | nie pokazano | 190 tys. | 880 tys. |
Twoje liczby będą inne. Właśnie po to się je mierzy. Wiersz tokenów powstał, zanim przeszliśmy na tokeny na sekundę; panel statystyk pokazuje teraz tokeny na sekundę, a te liczby pochodzą ze zrzutu z 23 września na starszym panelu minutowym.
Wartość, której nie da się zmierzyć, jest oznaczona jako „not reported”.
Większość pulpitów GPU uśrednia cztery karty do jednej linii i rysuje brakującą wartość jako 0. Ten daje każdej karcie własny panel: temperaturę względem progu dławienia zgłaszanego przez sterownik, moc względem własnego limitu karty, taktowanie, wentylator, łącze PCIe w stanie wynegocjowanym w tej chwili oraz ECC i NVLink, jeśli karta je ma. Dwie karty kupione w odstępie osiemnastu miesięcy pozostają dwiema kartami, a wartość, której sterownik nie podaje, jest oznaczana jako brakująca, a nie rysowana jako zero.
 Próg dławienia ze sterownika, a nie z domysłu
Dlaczego taktowanie spadło, według sterownika
Moc względem własnego limitu 140 W
NVLink i ECC, tak jak zgłasza je karta
| Na kartę | Temperatura i próg dławienia, moc i jej limit, taktowanie rdzenia i pamięci, wentylator, generacja i szerokość PCIe, ECC, NVLink oraz proces silnika używający karty |
|---|---|
| Na host | Użycie VRAM, wykorzystanie GPU (najbardziej obciążona karta), moc (suma kart) i tokeny na sekundę |
| Na żądanie | Czas do pierwszego tokenu, opóźnienie między tokenami i czas trwania, mierzone na proxy w ten sam sposób dla obu silników |
Na co czeka każde żądanie.
Strona Stats wymienia każde żądanie w toku z sesją klienta i etapem, na którym jest żądanie: w kolejce LM Warden, prefill (silnik czyta prompt), myślenie, pisanie wywołania narzędzia lub odpowiadanie. Plakietka podaje część promptu, która prawdopodobnie jest w cache repliki. Jeśli prefill trwa dłużej, niż przewiduje wyuczona dla tego serwera szybkość prefill, widać prawdopodobną przyczynę: żądanie czeka za innymi promptami na tej samej replice, cache został prawdopodobnie usunięty albo żądanie jest powolne z powodu, którego LM Warden nie widzi. Sesja pochodzi z identyfikatora, który każde narzędzie już wysyła: Claude Code, Codex, OpenCode i pi od razu, Hermes i Aider po jednym wierszu konfiguracji.
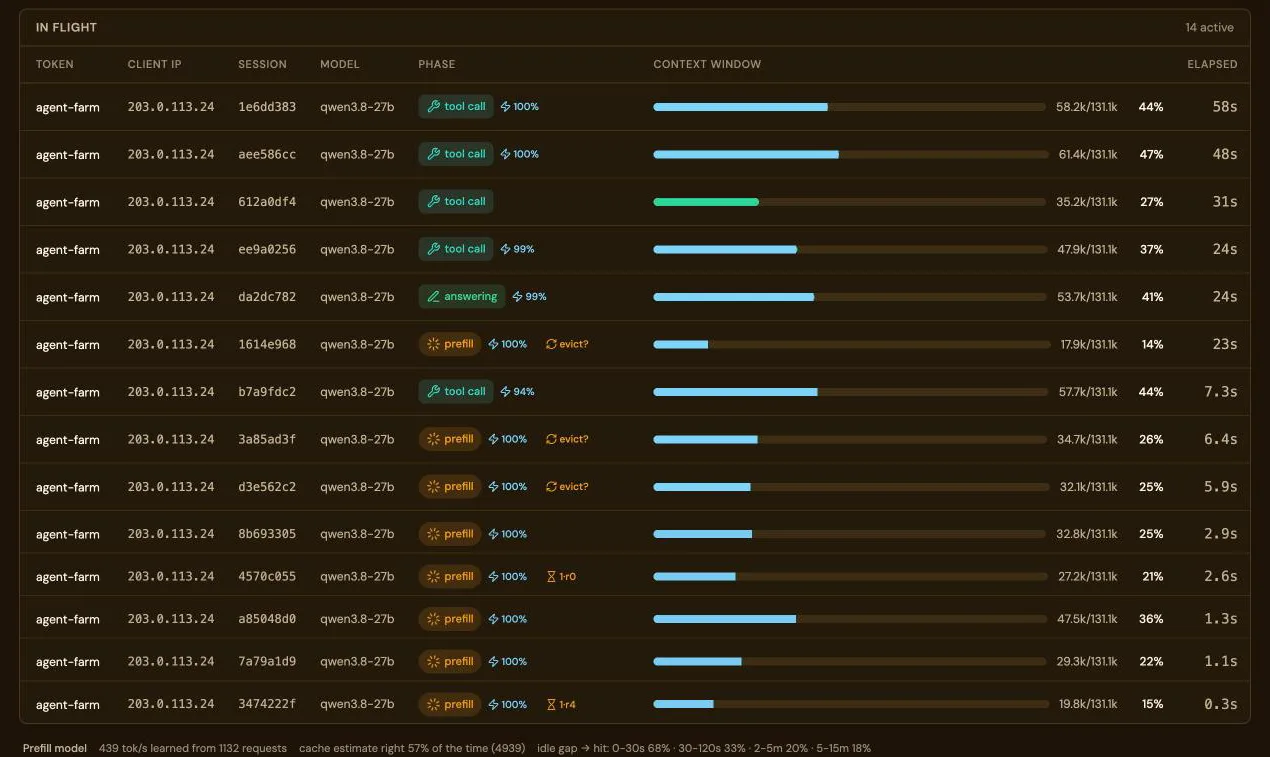 Jeszcze bez tokenu, cache prawdopodobnie usunięty
Jeden prompt przed nim na replice 4